Table of Contents
AI写代码越来越快,程序员价值到底在哪里?前几天的一次线上故障,让我重新想了想这个问题。
前几天,客户突然报了一个线上问题:即时对话里的消息发不出去了。
我们的应用底层用的是腾讯 IM。看到这个现象,我第一反应不是去查客户端,也不是怀疑腾讯 IM 本身出了问题,而是觉得消息发送的回调链路可能有问题。
于是我让部署在生产环境里的 DeepSeek Harness 去查日志。现在我的运维方式已经和以前很不一样了,不需要先打开 Kibana,根据时间、用户 ID、关键字一点点搜索,而是直接告诉 Harness:客户消息发送失败,重点检查消息发送回调相关的日志。
很快就找到了原因。
服务器时间不准,已经与当前时间相差63s。
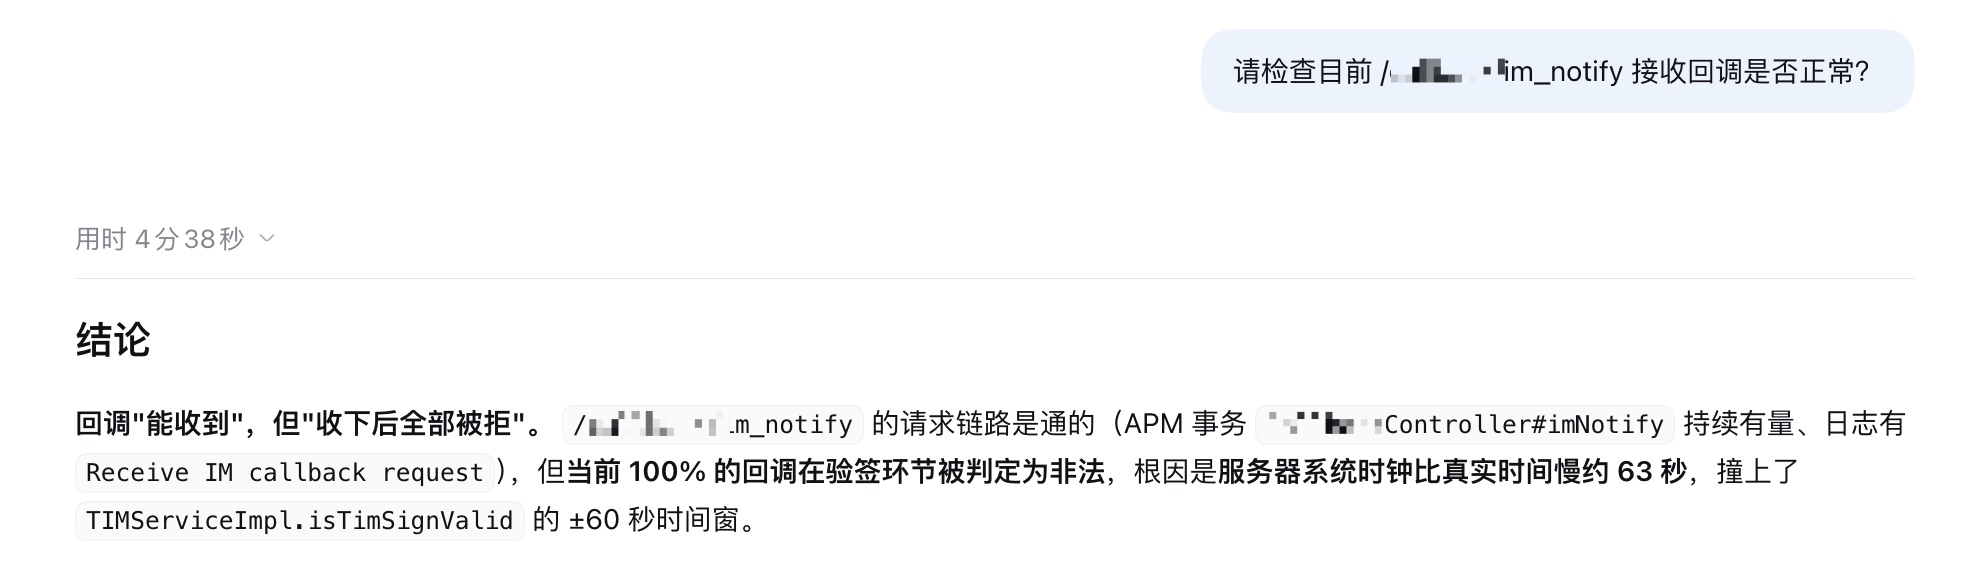
我们的回调程序会对腾讯 IM 请求中的时间戳进行校验,因为服务器时间发生漂移,正常的回调请求被判断成了无效请求,程序随后把消息丢弃了。我校准服务器时间,又把 chronyd 配置好,问题解决。
这是一个不算复杂的线上故障,但处理完以后,我反而一直在想另一件事情。
我们现在这个系统,99%以上的代码已经由 AI 编写。我自己真正一行一行敲进去的代码已经非常少了。但客户只说了一句“消息发不出去”,我为什么会首先想到回调?
这件事让我重新理解了,在 AI 已经可以大量写代码以后,一个程序员真正值钱的部分到底还剩下什么。
AI写代码,正在把具体实现从程序员工作里拆出去
我自己这两年的变化非常明显。
以前做一个功能,从需求、数据库设计、接口、前端、测试到上线,中间很大一部分时间就是写代码。现在需求和架构确定以后,大量具体实现都可以交给 Coding Agent。我更多是在描述需求、补充上下文、检查实现结果,以及遇到问题以后决定应该从哪里开始排查。
所以我并不认同一种比较常见的安慰式说法:AI 只是一个提高效率的工具,程序员的工作不会发生根本变化。
至少从我自己的实际使用来看,变化已经发生了。
过去程序员一个非常重要的能力,是把需求翻译成可以运行的代码。现在这部分工作的成本正在快速下降。一个熟练使用 Agent 的开发者,一天可以产生过去几个人才能完成的代码量,而且随着模型和 Agent 继续进步,这个趋势大概率还会继续。
Google DORA 在 2025 年针对近5000名技术从业者的研究中发现,接近90%的受访者已经在工作中使用 AI,超过80%的人表示生产力有所提升。不过与此同时,仍有30%的人对 AI 生成的代码几乎没有或完全没有信任。DORA 对这个现象的总结很有意思:AI 更像一个放大器,它可以放大一个团队原本具备的能力,也会放大原来就存在的问题。
我自己的体验也差不多。
AI 已经可以把代码写得非常快,但“代码越来越容易得到”和“软件越来越容易做好”,并不是一回事。
这次消息发送故障就是一个很小的例子。
如果让我自己去搜索日志,当然也能找到问题。DeepSeek Harness 的价值在于,它把后面搜索、关联日志、检查代码这些工作大幅加速了。但客户说“消息发不出去”的时候,整个系统至少有很多地方都可能出错:客户端 SDK、网络、IM 服务、鉴权、消息回调、业务逻辑、数据库,甚至配置和服务器环境。
Harness 可以查这些东西,但首先查哪里,仍然取决于你怎样理解这个系统。
会查日志和知道该查什么,其实是两种能力
我后来想,这可能是目前很多关于 AI Coding 的讨论里容易被忽略的一点。
我们很喜欢测 AI 会不会完成某个任务:能不能修 Bug,能不能写完整功能,能不能通过测试,能不能操作数据库。但线上故障通常不会把任务描述得这么清楚。
客户不会告诉你:
“腾讯 IM 回调接口因为服务器时钟漂移,导致 RequestTime 校验失败,请检查 NTP。”
他只会说:
“消息发不出去。”
从这句话到检查消息回调,中间实际上经过了一次很大的搜索空间压缩。
我知道腾讯 IM 在整个业务里的位置,知道一条消息发送以后还要经过哪些环节,知道我们在回调里面做过什么处理,也大致知道哪些问题会导致消息完全发不出去,哪些问题只会造成展示异常。
这些东西并不是某一段代码,而是一个人在长期开发和维护系统以后,脑子里形成的一张地图。
以前这张地图往往是在写代码的过程中自然形成的。数据库是自己设计的,接口是自己写的,第三方服务也是自己接的,所以系统哪几个地方容易出问题,基本心里有数。
现在有了 AI,一个新的问题开始出现:代码生成越来越快,但人对系统的理解未必同步增长。
这也是我现在使用 Coding Agent 时比较在意的一件事。我可以不亲手写代码,但技术架构、主要模块、业务流程和关键依赖仍然必须清楚。如果连这些都不知道,那么 AI 写得越快,系统反而可能越快变成一个没人真正理解的黑盒。
所以我越来越觉得,未来软件开发的一个重要瓶颈,可能会从“代码生产能力不够”,逐渐转向“人的认知跟不上代码增长”。
这也解释了为什么在 AI Coding 时代,架构、测试、日志、可观测性和文档可能会重新变得重要。过去很多团队觉得这些事情不直接产生功能,能省就省;但当 Agent 可以一天修改大量代码以后,如果没有足够好的测试和运行数据,人甚至很难知道它到底改对了没有。
程序员不会平均地被AI影响
当然,从这次经历得出“所以程序员不会被 AI 淘汰”,我觉得也太乐观了。
有些程序员的工作确实正在被快速压缩。
如果一个岗位主要做的是根据明确需求写接口、CRUD、简单页面、调整字段、补单元测试,或者按照一个已经定位清楚的 Bug 修改几行代码,那么这些任务越来越适合交给 Agent。过去企业需要很多人的原因之一,是软件生产本身非常耗费人工;当生产代码的成本快速下降以后,开发团队的结构当然会发生变化。
最近的一些就业数据已经开始出现这种差异。
Stanford Digital Economy Lab 在2026年8月更新的一项研究中,分析了覆盖数百万美国劳动者的 ADP 薪资数据。研究并没有发现 AI 已经造成全经济范围的大规模岗位消失,但在 AI 暴露程度较高的职业中,22至25岁年轻劳动者的就业水平,相对于低暴露同行应该达到的趋势已经低了19%,而经验更丰富的劳动者没有出现类似缺口。软件开发正是研究列出的高 AI 暴露职业之一。
另一项2026年9月发布的研究规模更大,分析了41个国家12.5亿条招聘信息和1.54亿条就业记录。研究者发现,企业采用生成式 AI 以后,Junior 员工在员工结构中的占比相对下降。不过这里有一个很重要的细节:这种变化主要不是来自 Junior 员工大规模减少,而是 Senior 员工增长得更快。
我觉得这个结果比“AI 会不会让程序员失业”更值得讨论。
AI 对程序员的影响,很可能不会平均发生。
那些工作内容主要集中在“把一个已经定义清楚的问题实现出来”的人,会承受更大的压力;而能够自己定义问题、理解业务、设计系统、判断风险,并且能够调度 AI 完成大量执行工作的人,生产力反而可能被进一步放大。
过去一个优秀程序员和普通程序员,也许只是代码质量和开发速度的区别。以后这种差距可能会变成,一个人能不能带着几个甚至几十个 Agent,同时管理更大的系统范围。
这并不意味着 Senior 天然安全。所谓经验如果只是记住更多 API、框架用法和语法细节,同样很容易被模型覆盖。真正留下来的经验,应该是知道一个复杂系统为什么这样设计、业务真正关心什么、哪些地方不能出错,以及出现异常以后怎样最快建立一个靠谱的假设。
程序员价值,可能越来越取决于“业务×技术×AI”
这些年有一种观点很流行:程序员会成为最早被 AI 淘汰的职业之一。这个判断不能说完全没有道理,因为程序员创造的东西恰好就是代码,而代码又是大模型最容易大量学习和验证的内容之一。
但经历这次故障以后,我更倾向于认为,我们过去可能把“程序员”和“写代码的人”看成了同一件事情。
在很长一段时间里,两者确实高度重合,所以这个区别没有那么重要。但 AI 正在把它们拆开。
一个未来的软件工程师,也许绝大多数代码都不是自己写的。他需要做的事情可能变成:理解业务到底要解决什么问题,设计系统怎样实现,用 Agent 完成具体任务,然后根据测试、日志和生产数据判断结果是否正确。出了事故以后,他还要知道应该先怀疑哪里。
这种能力很难简单叫作“编程”,但它依然属于软件工程,而且可能比过去更依赖技术经验。
我现在做项目,越来越能感受到这种变化。
我的代码写得越来越少,但我反而不能比以前更不了解系统。如果业务流程不清楚,架构不知道,Agent 为什么这么改也不关心,那么所谓“99%的代码都由 AI 写”,并不一定是一件值得炫耀的事情。它也可能意味着,项目里产生了越来越多没有人真正理解的代码。
前几天那个故障处理完以后,我没有改多少代码,甚至整个排查过程中最费时间的工作都是 DeepSeek Harness 做的。
但如果再来一次类似问题,我还是希望自己看到客户描述的那一刻,脑子里能够马上出现那张系统地图。
因为至少从目前来看,代码已经越来越便宜了。
真正稀缺的,是有人知道这些代码为什么存在,它们和业务怎样连接,以及当系统不再按照预期运行时,应该从哪里开始找答案。