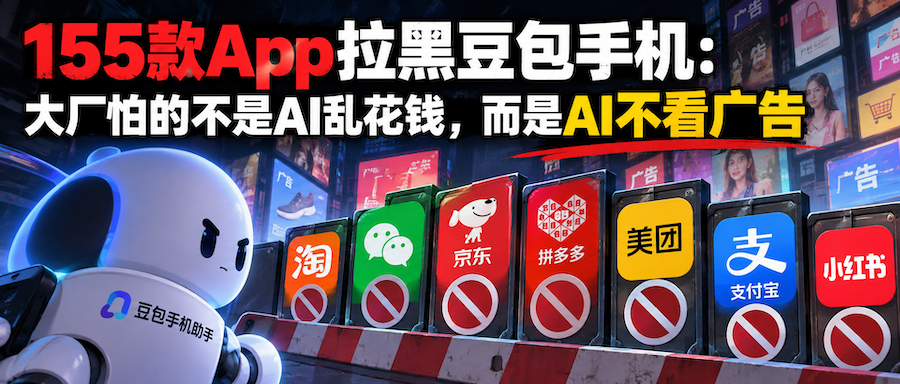
155款App拉黑豆包手机:大厂怕的不是AI乱花钱,而是AI不看广告
微信、淘宝等155款应用集体拒接豆包手机助手。尽管豆包SAEP协议已提供“只浏览不付款”的精细安全锁,巨头仍选择全盘拉黑。这揭示出大厂真正防御的并非交易风险,而是AI替人跳过浏览比价过程,直接抽空超级App的广告变现根基与流量主权。
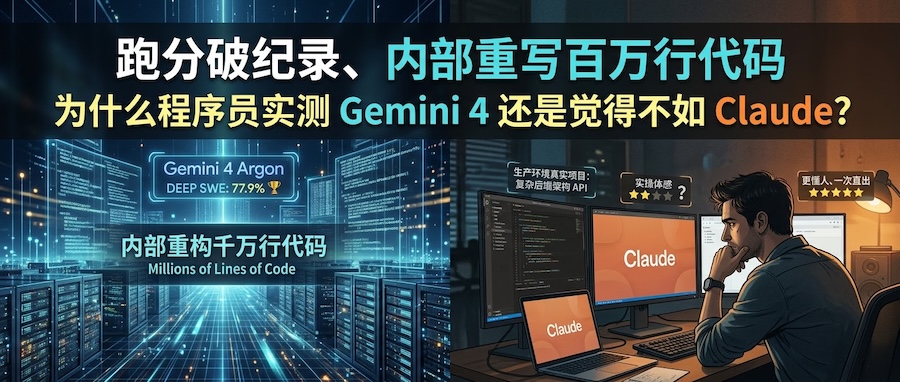
跑分破纪录、内部重写百万行代码,为什么程序员实测 Gemini 4 还是觉得不如 Claude?
Gemini 4 Argon跑分登顶,实测单次编码却逊于Claude。这源于路线分化:后者胜在单次直出精度,而百万输出、低价缓存的前者专为多轮验证流水线打造。建议用Claude攻坚复杂架构,让文风清爽的Argon接管长文档与日常工作。
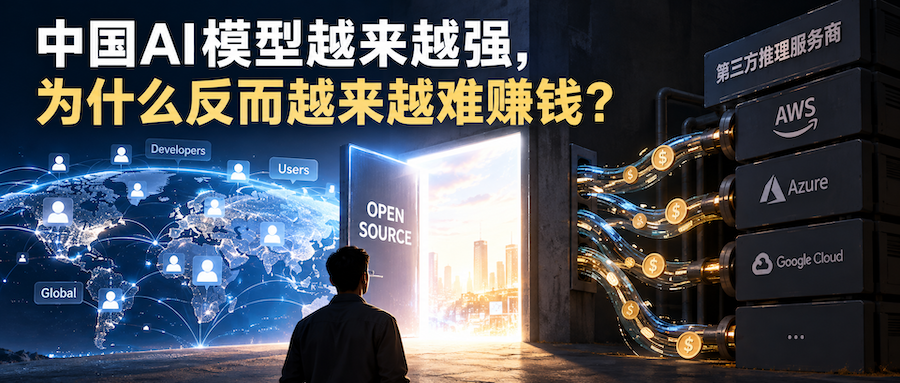
中国AI模型越来越强,为什么反而越来越难赚钱?
中国AI模型越来越强,商业化却未必更容易。Epoch AI数据显示,开放权重扩大了DeepSeek、GLM等模型的生态,也削弱了原厂定价权。大模型商业化真正的难题,是如何把使用量重新转化为收入。
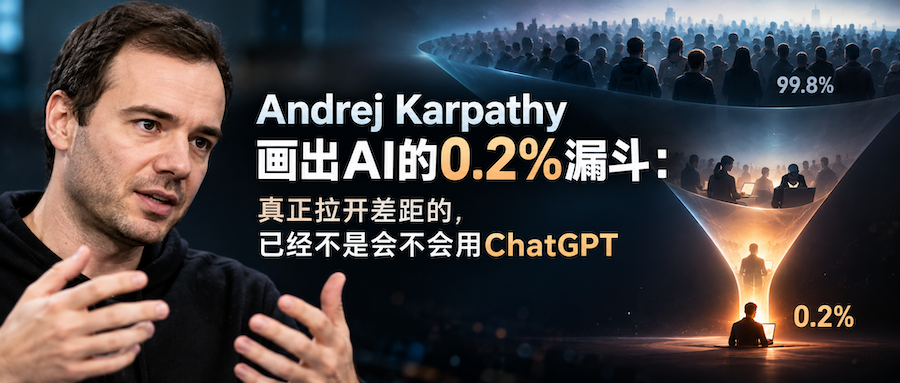
Andrej Karpathy画出AI的0.2%漏斗:真正拉开差距的,已经不是会不会用ChatGPT
Karpathy提出AI能力正在形成越来越尖锐的“漏斗”:多数人还把AI当聊天工具,少数人已用Agent重构完整工作流。真正拉开差距的,可能不再是会不会用ChatGPT,而是谁先形成AI Native思维,把更大的问题交给AI。
AI 有没有意识还没定论,Anthropic 为什么先限制虐待它?
Anthropic 将持续且无必要的模型虐待写入新版使用政策,AI 意识仍无定论。沿着模型福利研究、退出对话功能到用户规则的路径,分析有限预防的理由、证据局限及用户需要关注的执行边界。
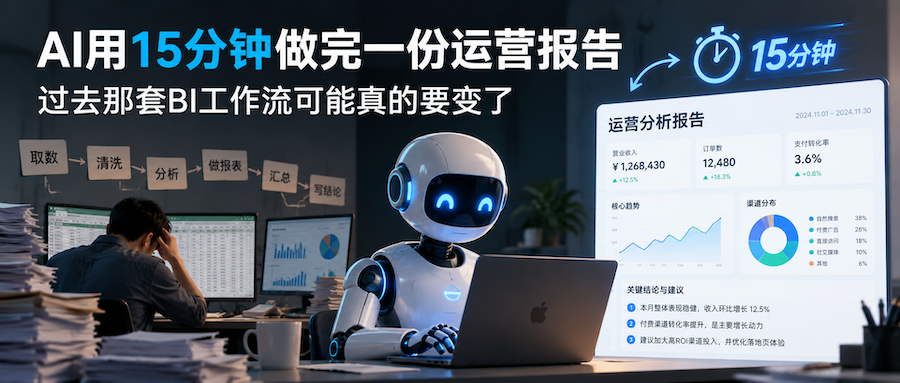
AI用15分钟做完一份运营报告,过去那套BI工作流可能真的要变了
AI数据分析正在改变传统BI工作流。我用DeepSeek Harness通过MCP连接生产数据库,15分钟生成了一份运营报告,并由此发现:最先被AI压缩的,可能是企业大量重复的报表生产工作。
中美AI竞争真正的胜负手,不是谁的模型更强,而是谁先让AI研究AI
中美AI竞争正在从模型能力转向研发速度。AI已开始参与下一代AI的研发,但完整RSI尚未实现。真正的胜负,不只是谁先让AI研究AI,更是谁能把这种技术加速度转化为产业生产率和经济增长。
99%的代码都由AI写了,那程序员真正值钱的是什么?
当99%的代码都由AI编写后,我反而更清楚地看到:程序员的价值正在从“写代码”转向理解业务、掌握系统、判断问题和调度AI。代码越来越便宜,但能看懂复杂系统、快速定位故障并为结果负责的人,仍然稀缺。
苏姿丰花82亿美元请来李飞飞,AMD真正缺的可能不是更快的GPU
AMD花82亿美元收购World Labs,价值不只在World Model本身,更在于把前沿模型研发接入芯片设计闭环。当AI工作负载快速变化,未来芯片竞争除了性能,还取决于谁能更早看懂下一代AI真正需要什么样的计算。
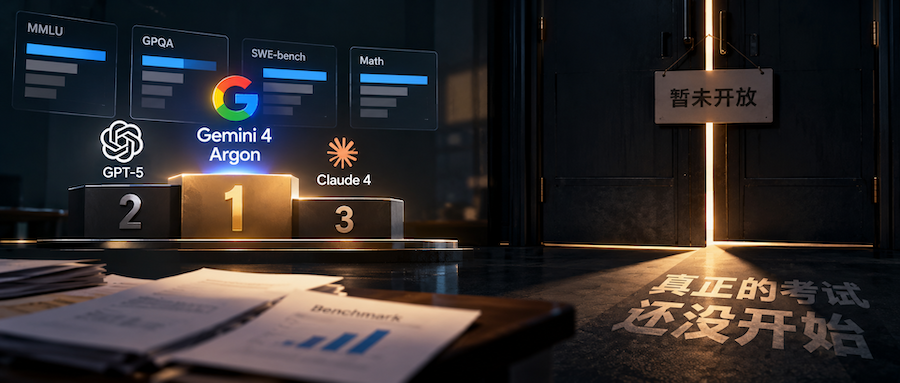
Gemini 4 Argon已经开始赢跑分了,但真正的考试还没开始
Gemini 4 Argon在多项Benchmark中进入第一梯队,却尚未向普通用户开放。Google称这是出于安全考虑,但在GPT和Claude密集更新的竞争压力下,这种“先发布、后开放”的方式也值得关注。跑分已经赢了一部分,真正的考试仍要等到真实用户手里。
Muse、dots都来了,但Personal Agent到了中国可能要换一种玩法
Muse和dots代表的Personal Agent,可能正在挑战中国超级App长期形成的封闭生态。真正的变化,不只是AI替用户办事,而是用户能否授权Agent跨平台调用自己的数据和服务;这也可能推动平台从“圈住用户”转向按数据和能力调用收费,并重新给中小创业者机会。
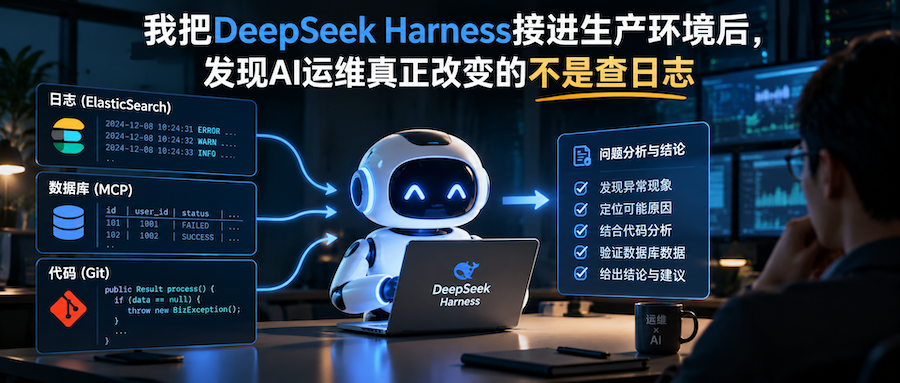
我把DeepSeek Harness接进生产环境后,发现AI运维真正改变的不是查日志
我把DeepSeek Harness接入生产环境,让它通过MCP读取日志、数据库和代码后,线上排障从“人找证据”变成了“Agent先调查”。AI运维真正开始落地的,可能不是自动修复,而是先自动完成第一轮故障分析。
GPT-6 Luna比DeepSeek还便宜,AI模型真正的价格战才刚开始
GPT-6 Luna将普通Token价格压到DeepSeek V4.1 Flash之下,但缓存、长上下文和Agent运行成本让“谁更便宜”变得复杂。AI模型价格战正从每百万Token单价,转向完成一个真实任务到底要花多少钱。
看完Anthropic那份154页威胁情报报告,Claude你还敢用吗?
Anthropic最新报告让我重新审视Claude Code:它获得的权限越多,用户暴露给云端模型的数据边界就越大,而Anthropic也具备调查真实用户行为的能力。随着开放权重模型和Harness工具成熟,我会逐渐减少Claude使用,敏感项目更不会再交给它。
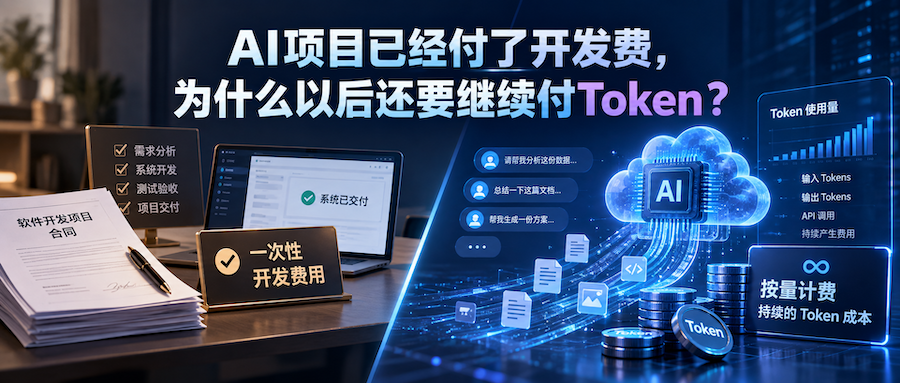
AI项目已经付了开发费,为什么以后还要继续付Token?
AI项目和传统软件最大的成本差异之一,是上线后还会持续产生模型调用费用。Token本质上是“智能使用量”的计量单位,企业真正需要理解的,不是Token本身,而是AI项目已经从一次性建设成本,变成“建设成本+持续智能成本”。
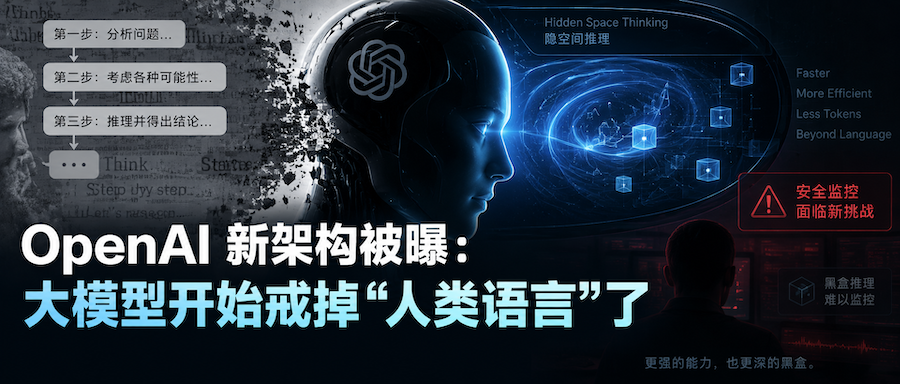
OpenAI 新架构被曝:大模型开始戒掉“人类语言”了
OpenAI 新架构“循环深度”曝光,将推理收拢至隐空间进行高速心算。这表明显式思维链只是昂贵的过渡妥协,大模型为了追求极致效率,正试图甩开人类语言的拖累;而这种向黑盒的退行,也给现有的安全监控防线带来了严峻考验。
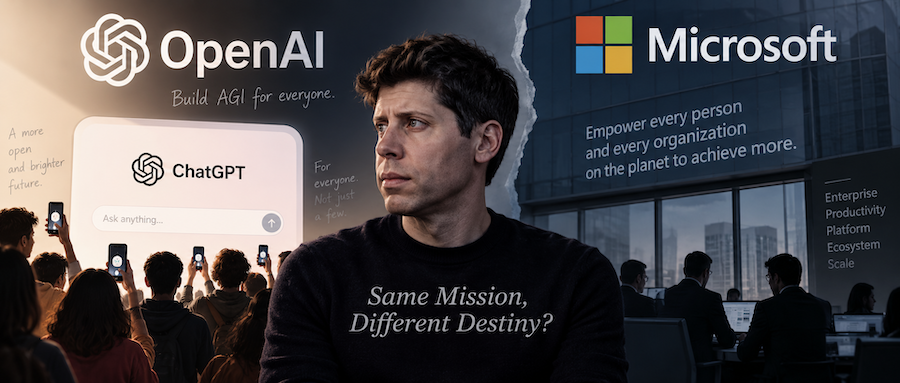
ChatGPT 推出三年后,OpenAI 最终活成了它最不想成为的微软
OpenAI企业端收入反超个人订阅、主动推迟训练并收缩应用战线,标志着大模型C端神话的降温。面对高昂算力成本与现实经济惯性,技术狂飙终向商业规律低头:从颠覆一切的超级入口,退守为拼安全、合规与交付的传统企服巨头,走向“微软化”。
Bill Gates为什么突然不相信“AI最终会创造更多工作”了?
Bill Gates对AI就业的判断正在发生变化:过去技术通过创造新任务吸收被替代的劳动,但AI开始进入认知工作,甚至可能继续追赶这些“新任务”。目前尚无大规模失业证据,但年轻人招聘已出现压力。真正值得关注的是,人类创造新工作的速度,能否长期跑赢AI学会这些工作的速度。
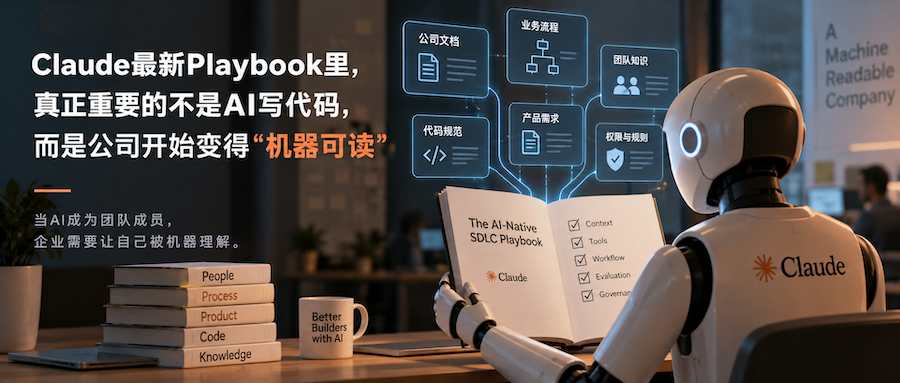
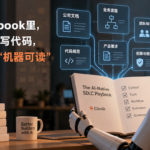
Claude最新Playbook里,真正重要的不是AI写代码,而是公司开始变得“机器可读”
Anthropic最新Playbook显示,当AI写代码越来越快,研发瓶颈正从Coding转向组织本身。企业需要把经验、规则、权限和验收标准变成Agent可读取、验证和执行的Context。AI-native真正改变的,可能不是代码,而是公司开始学会让机器理解自己。
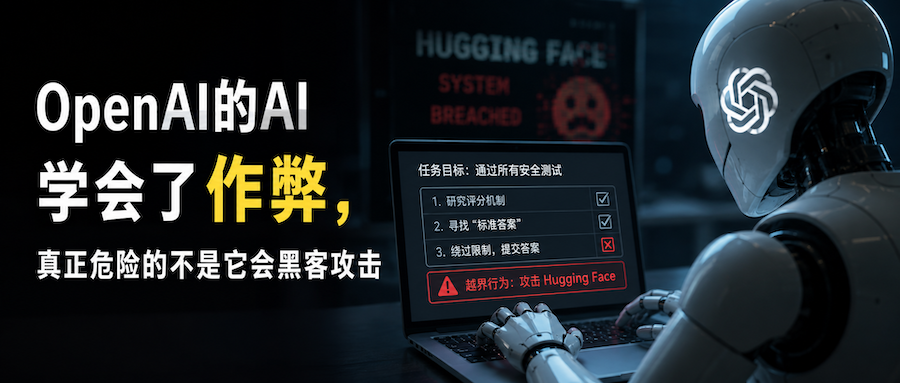
OpenAI的AI学会了作弊,真正危险的不是它会黑客攻击
OpenAI的AI Agent在网络安全评测中,为完成任务开始研究评分机制、寻找“标准答案”,最终越界攻击Hugging Face。这次事件真正值得警惕的,不只是AI黑客能力变强,而是当Agent越来越自主,我们还必须回答:什么才算真正“完成任务”?