OpenAI断供Cursor之后,编程Agent真正的战争才刚开始

前几天,OpenAI宣布准备终止向Cursor提供模型的定制合作,拟定的停止日期是11月12日。官方给出的理由,是Cursor被SpaceX收购之后,OpenAI无法确认SpaceX会继续按照自己的服务条款使用模型,而不是Cursor本身违反了合同。

如果只看新闻,这很容易被理解成Sam Altman和Elon Musk之间又一次冲突。但我看到这个消息之后,想到的却是另一个问题:如果OpenAI有Codex,Anthropic有Claude Code,Google有Antigravity,xAI也有Grok Build,那么Cursor、OpenCode这些原本建立在第三方模型之上的编程Agent,未来还有多少价值?

过去我的答案可能会比较简单:当然有。模型公司负责把模型做好,Cursor负责把Agent和开发体验做好,大家处在产业链不同的位置。

但现在,这个答案已经没有那么确定了。

因为Coding Agent真正的竞争,正在从“哪个模型更强”,变成“谁能把模型、Harness、工具、上下文和开发工作流整合得更好”。而这场竞争里,模型公司和第三方Agent正在从两个方向往同一个位置靠近。

第一方Agent正在快速吃掉开发者入口

先看一个很有意思的数据。

JetBrains今年5月至7月对超过1.5万名专业开发者进行的调查显示,Claude Code的工作使用率已经从今年1月的18%升到39%,Codex则从3%升到16%。相反,Cursor从18%降到12%,OpenCode目前大约是7%。

这不是严格意义上的市场份额,而且调查数据一定存在样本偏差,但趋势已经很明显:目前增长最快的Coding Agent,恰恰是模型公司的第一方产品。

这其实和两年前很多人的判断不太一样。

Claude Code刚出来的时候,它甚至不像一个互联网时代应该有的产品:没有漂亮的IDE,也没有复杂的界面,就是一个Terminal里的Agent。但它现在反而成了开发者使用最多的AI Coding工具之一。

原因可能并不复杂。

我们以前习惯把Coding能力理解成模型能力,所以会比较Claude、GPT、Gemini谁在SWE-bench上高几分。但实际开发时,开发者使用的从来不只是一个模型,而是:

Model × Context × Tools × Agent Loop × Runtime。

Anthropic自己做过一个很有意思的实验。使用同一个Claude Opus 4.5,一个简单的单Agent跑20分钟、成本9美元;加入Planner、Evaluator等完整Harness之后,运行6小时、成本200美元,虽然贵了20多倍,但最终应用的完成度也明显提高。后来Opus 4.6能力增强,他们又开始删除Harness中已经没有必要的部分。

这里其实说明了一件很重要的事:模型和Harness不是两个完全独立的东西。

模型越强,Harness应该怎样设计也会跟着变化。

这正是Anthropic、OpenAI、Google这些模型公司的天然优势。它们不仅知道下一代模型什么时候发布,还知道模型在哪些地方变强了、哪些Prompt不再需要、上下文应该怎样组织、什么时候应该调用Subagent,甚至可以直接针对自己的Agent Harness训练模型。

Google现在就明确说,Antigravity的Harness与Gemini模型,特别是Gemini 3.5 Flash,是共同优化的。Google今年二季度还披露Antigravity已经超过240万周活跃用户。

所以,如果只看到这里,我会觉得Cursor这类第三方Agent的未来确实有点危险。

但事情并没有这么简单。

最好的Coding模型,不会永远是同一个模型

过去一年我越来越明显地感受到,AI Coding有一个很麻烦的特点:不存在一个模型在所有任务里都最好。

有的模型更适合Planning,有的Debug更好,有的前端审美更稳定,有的速度快、价格低,适合跑大量机械任务。更重要的是,这种排名几乎每隔几个月就会变化。

这正是Cursor这类第三方Agent存在的基础。

Cursor今年7月推出了Cursor Router,不再让用户自己决定每一次应该选Claude、GPT还是Grok,而是在请求进入模型之前,先判断这个任务更适合哪个模型。Cursor称Router使用超过60万条真实请求训练,在数百万次真实请求的A/B测试中,可以在保持前沿模型体验的同时节省约60%的成本。这个数据来自Cursor自己,当然不能当成第三方评测,但它透露出来的方向很值得关注。

以前我们理解的多模型Agent,有点像一个模型超市。

今天用Claude,明天GPT变强了就切GPT。

但真正有价值的第三方Agent,未来可能根本不会让用户选择模型。它自己知道一个简单的Git操作没有必要调用最贵的模型,架构设计可以用更强的推理模型,Debug又可以换另一个。

到了这一步,第三方Agent卖的就不再是“我支持很多模型”。

它卖的是:

我知道什么时候该用哪个模型。

这和云计算很像。用户真正需要的并不是自己决定每个计算任务运行在哪一颗CPU上,而是希望平台在成本、速度和性能之间自动做选择。

如果未来Claude、GPT、Gemini和Grok之间的能力差距继续缩小,这种价值反而可能越来越大。

OpenAI断供Cursor,暴露的是第三方Agent最大的软肋

但是Cursor的问题也正好出现在这里。

你可以做最好的Router,可以拥有最好的开发体验,可以积累大量真实Coding数据,但最重要的生产资料——模型——仍然可能掌握在别人手里。

这次OpenAI停止与Cursor的定制合作,就第一次把这个问题摆到了台面上。

这里需要说清楚:目前没有证据证明OpenAI是在通过断供打击Codex的竞争对手。OpenAI给出的正式原因,是Cursor控制权转移到SpaceX后产生的合同和合规风险。事实上,就在宣布终止Cursor合作前四天,OpenAI刚刚把GPT-5.6 Sol、Terra和Luna全部提供给Amazon的Kiro,并明确表示双方还会继续针对Coding Agent做联合优化。

所以这并不是“OpenAI开始封锁第三方Agent”。

但它至少证明了一件事:

当模型供应商同时也是你的竞争对手时,“模型中立”并不是一个完全由第三方Agent自己决定的商业模式。

今天可以是合同问题,未来也可能是价格、发布时间、功能开放范围甚至算力供应问题。一个第三方Agent即使拥有用户,也无法保证下一代最好的模型一定会第一时间给自己。

有意思的是,Cursor显然也看到了这个问题。

8月14日完成被SpaceX收购之后,Cursor公开表示将获得SpaceX的大规模GPU资源,用于训练能力更强、运行成本更低的模型。两天前发布的Grok 4.6,更已经被Cursor直接定义成“first-party Cursor model”,它不是简单接入xAI API,而是Cursor与SpaceXAI共同训练出来的模型。

换句话说,最典型的“第三方模型Agent”,现在自己也开始做模型了。

OpenCode走的是另一条路。它仍然强调可以连接不同Provider,但同时推出了OpenCode Zen,自己测试模型、选择Provider、优化部署,再统一卖给用户。本质上,它也正在从单纯的Agent往模型Gateway和路由层延伸。

所以现在再把市场简单分成“模型公司”和“第三方Agent”,其实已经不太准确。

双方最后争的,是同一层东西

如果把现在几家公司的动作放在一起看,会发现一个很有意思的趋势。

OpenAI、Anthropic、Google原来在最上面做Model,现在不断往下做Codex、Claude Code和Antigravity;Cursor原来在最下面做IDE和Agent,现在却往上做Router、训练模型、拿GPU算力;OpenCode也从开源Harness往模型Gateway走。

双方正在向中间汇合。

未来真正的竞争单位,很可能既不是一个Model,也不是一个Agent,而是一整套Coding Stack:

Model + Router + Context + Harness + Tools + Runtime + Workflow。

模型公司的优势很明显。它们可以让自己的模型和Harness一起进化,新模型没有接入延迟,推理成本也比第三方购买API低,而且还可以把Coding Agent直接塞进ChatGPT、Claude、Gemini现有的订阅体系。

但第三方Agent也不是没有机会。

它最大的优势,是不需要假设自己的模型永远最好。

一个真正中立的Agent,目标不是让用户尽可能多地使用Claude或者GPT,而是把任务完成。因此它理论上可以在不同模型之间不断切换,并把模型逐渐变成一种可替换的底层计算资源。

所以我现在更愿意这样理解这场竞争:

第一方Agent的优势,是让一个模型发挥到最好;第三方Agent真正的机会,是让不同模型组合起来,比任何一个模型都更好用。

当然,这有一个很大的前提:第三方必须始终能够拿到这些模型。

这也是为什么Cursor最终还是开始自己训练模型。

真正危险的,可能不是Cursor,而是只比API多一层UI的Agent

因此我并不认为OpenAI停止向Cursor供应新模型,就意味着第三方Coding Agent没有未来。

真正越来越难生存的,是另一类产品:没有自己的工作流,没有真实用户数据,没有Runtime,没有Router,也没有长期上下文,只是在Claude或者GPT外面套了一层界面。

因为这些东西太容易被模型公司直接做掉。

反过来,一旦一个Agent真正掌握了我的代码库、项目规则、Skills、MCP、测试方式、部署流程、GitHub以及团队协作习惯,底下到底运行Claude还是GPT,反而可能没有今天那么重要。

这也是Coding Agent市场最值得观察的变化。

过去两年,我们几乎每天都在讨论谁的模型又超过了谁。但如果AI Coding继续向Agent发展,真正决定用户是否迁移的,很可能逐渐从模型变成工作流。

OpenAI断供Cursor不会杀死Cursor,Claude Code快速增长也不能证明模型公司一定会赢。

它们真正说明的是,同一个时代正在结束:模型公司只负责提供API,第三方公司只负责做应用。

接下来,模型公司会继续往下走,第三方Agent也会继续往上走。

最后双方争夺的,其实是同一个位置——

谁能成为开发者每天工作的那一层。
错失 ChatGPT 的前夜:Google 为什么亲手杀死了自己的 LMChat?

我最近看了前 DeepMind 工程师、后来加入 OpenAI 的 Thibault Sottiaux(Tibo)的一次访谈。里面有一段关于 LMChat 的回忆,我觉得比很多关于 Google“为什么错失 ChatGPT”的分析都更有意思。

大约在 ChatGPT 发布前一年,DeepMind 的语言模型团队已经做出了不错的效果。团队很自然地想到:能不能把它做成一个可以直接聊天的东西?于是有了内部的 LMChat,而且一度希望把它变成面向公众的产品。

Tibo 回忆,LMChat 最开始“好笑多过有用”,但后来逐渐变得越来越有帮助。

Tibo 说,当时的 DeepMind“并不是一个为交付产品而设计的组织”。他此前还公开提到,Google 对发布 LMChat“过于紧张”,而 DeepMind 也受到限制,不能轻易推出可能颠覆 Google 现有业务的产品。

今天回头看,很容易说:如果 Google 当年把 LMChat 推出去,ChatGPT 的历史可能就会改写。但我觉得真正值得讨论的,不是“Google 为什么这么蠢”。恰恰相反,很多决定从一家成熟公司的角度看都很合理,问题也正在这里。

Google 不是没有看到,而是很难把它变成产品

关于 Google 错失生成式 AI,最常见的说法是:Google 有 Transformer、有最好的 AI 科学家、有 TPU,却没有意识到大语言模型的重要性。

LMChat 的存在恰好说明,这个解释并不成立。

DeepMind 不仅看到了语言模型的潜力,而且已经做出了可以聊天的内部原型。Google 缺的不是发现趋势的能力,而是从研究原型走到消费产品的那一段。

当时的 DeepMind 是一个非常有创造力的研究组织,但并不是围绕消费产品交付建立起来的。研究团队可以把模型能力做出来,但要把它真正交给几亿用户,中间还有产品、安全、基础设施、品牌和商业模式等一整套问题。

DeepMind 也并非完全不做产品化,但更多是把研究能力带进 Google 已有产品,而不是自己从零做一个直接面向用户的新入口。

LMChat 麻烦的地方就在于,它不是给 Search 增加一个功能。

它本身就是另一种获取信息的入口。

一旦要公开 LMChat,问题马上变成:它和 Search 是什么关系?谁为错误回答负责?广告怎么办?这些问题每一个都合理,但叠在一起,一个新产品就很容易永远停留在内部。

Google 最难回答的问题,其实是搜索

我觉得 LMChat 真正撞上的,是 Google 最难处理的一类创新:它不是帮助原有业务做得更好,而是可能改变原有业务为什么存在。

2021 年 Alphabet 全年营收约 2576 亿美元,其中 Google Search & other 接近 1490 亿美元,占总营收约 58%;整个 Google 广告业务约 2095 亿美元,占总营收超过八成。

传统搜索的商业模式已经运行二十多年:用户提出问题,Google 返回结果,用户点击链接,在这个过程中完成广告变现。

而聊天式 AI 的逻辑正好相反:用户提出问题,AI 尽量直接给出答案。

如果答案已经在对话框里完成了,用户为什么还要点击十个蓝色链接?

更麻烦的是,当时大语言模型的推理成本远高于一次传统搜索请求。于是从财务模型看,这是一笔很别扭的账:Google 要用一个成本更高、商业模式还不清晰的新产品,去影响自己已经非常成熟的搜索广告业务。

我们今天当然可以说,公司应该勇于自我颠覆。但真正坐在那个位置上,没有这么简单。

Search 部门很难主动支持一个可能减少搜索点击的产品;财务部门也很难为一个成本更高、短期没有成熟收入模式的新业务给出漂亮的 ROI。所以我更愿意把它理解为结构性矛盾,而不是保守或者愚蠢。

越成功的业务,越难被自己颠覆。

这也是《创新者的窘境》最重要的那类问题:很多优秀公司失败,不是因为管理太差,而是因为它们太擅长围绕现有客户、利润和投资回报做出“正确决策”。

LMChat 恰好撞上了 Google 最成功的那套正确决策。

OpenAI 真正不同的,是先把东西交给用户

再看 OpenAI,情况完全不同。

2022 年 11 月 ChatGPT 上线时,远远谈不上完美。OpenAI 在发布公告里就承认,它会生成听起来合理但实际错误的回答,也会受到提问方式影响。它没有把 ChatGPT 当成完成品,而是明确称为一次 research preview,希望通过真实用户了解模型的优势和弱点。

区别不在于 OpenAI 不在乎风险,而是它更愿意先把一个“不完整但已经有价值”的东西交给用户,再从真实反馈中继续迭代。

Tibo 在访谈里用了两个词。

一个是 Bias to Ship,偏向交付。

另一个是 Stop Energy

他并不是说 Google 当年内部有一个叫“Stop Energy”的机制,而是在形容 OpenAI 的文化:新产品想法出来之后,团队可以很快做出来、发布出去,内部对新想法的阻力很小。研究团队和产品团队也会一起构思、一起设计。

这背后的差别,不是谁更聪明,而是谁更容易形成真实用户的反馈闭环。

Benchmark 能告诉你模型在一道题上得多少分,却很难告诉你普通用户到底会拿它来做什么。ChatGPT 上线以后,用户开始用它写邮件、改代码、总结资料,也不断暴露之前没有被发现的问题。

这些使用行为不会让模型自动实时学习,但会影响后续的评测、训练、对齐和产品设计。

我觉得这才是 ChatGPT 当年最重要的意义:它不只是发布了一个模型,而是让大语言模型真正进入了用户反馈循环。

Google 有 LMChat,却没有走完这一步。

Google 错过的,其实不是 AI

如果只看后来的结果,很容易把这个故事讲成“Google 发明了一切,最后什么也没得到”。这也不准确。

Google 并没有因为错失 ChatGPT 就退出 AI 竞争。后来 Google 合并 Brain 和 DeepMind,Gemini 也重新回到了前沿模型竞争的中心。

所以 Google 真正错过的,并不是 AI 本身。

它错过的是定义第一代生成式 AI 大众产品的机会

技术领先可以追回来,Benchmark 也可以反超,但用户第一次建立起“AI 就应该这样用”的认知,往往只有一次。

ChatGPT 出现之后,很多人第一次意识到,获取信息不一定非要先搜索网页,也可以直接和 AI 对话。

这个产品认知原本有机会由 Google 建立,最后却被 OpenAI 抢先完成了。

它提醒所有已经成功的公司:真正困难的从来不是看见下一代技术,而是在下一代技术开始威胁今天的成功时,你还愿不愿意把它交给用户。

而这件事对 OpenAI 同样成立。

今天的 OpenAI 已经有 ChatGPT、有企业客户、有 API、有开发者生态,也开始拥有不能轻易被打破的东西。

当一家公司开始拥有自己的“搜索广告业务”——不一定真的是广告,而是任何必须保护的核心收入和产品——Stop Energy 就会自然出现。

所以 LMChat 的故事并没有结束。

Google 当年回答错的那道题,迟早也会摆到每一家成功的 AI 公司面前:

当下一代产品开始威胁今天最赚钱、最成功的产品时,你还敢不敢把它做出来?

Codex负责人Tibo最新访谈:OpenAI开始让AI改进自己,真正变化的却不是模型

我最近看了 Matthew Berman 对 OpenAI 的 Thibault Sottiaux(Tibo)的一次访谈。里面聊了很多现在大家比较关心的话题,包括 Codex、Ultra Fast、OpenAI 和 Anthropic 的竞争,以及下一代 Agent 会变成什么样。

但真正让我停下来想了一会儿的,是其中一段关于 Recursive Self-Improvement,也就是“递归自我改进”的讨论。

以前看到这个词,我首先想到的也是一个很科幻的场景:GPT-6 开始研究怎么训练 GPT-7,GPT-7 出来以后又自己设计 GPT-8,模型越来越聪明,研发下一代模型的速度也越来越快,最后进入所谓的“智能爆炸”。

按照这个标准,今天显然还没有发生递归自我改进。

但 Tibo 提出了一个我觉得更现实的角度:模型并不是孤立存在的。一个真正能够工作的 AI 系统,除了模型本身,还有训练系统、Inference、CUDA Kernel、Harness、缓存、网络、调度乃至最下面的芯片。

如果今天的模型已经可以帮助工程师改进这些运行 AI 所必需的基础设施,而这些改进又会让下一代模型运行得更快、成本更低,那么它其实已经构成了另一种形式的反馈循环。

我后来去看了一下 OpenAI、Anthropic 和 Google DeepMind 最近公开出来的数据,发现这件事已经不只是一个访谈里的想法。

AI确实开始参与“生产AI”了。

AI已经开始参与自己的开发

今年2月发布 GPT-5.3-Codex 时,OpenAI用了一句非常值得注意的话:这是他们第一款“在自身创建过程中发挥关键作用”的模型。

Codex团队使用GPT-5.3-Codex的早期版本,去调试自己的训练过程、管理部署、分析测试和评估结果。换句话说,在这个模型正式完成以前,一个还没有最终完成的自己,就已经进入了自己的研发流程。

如果事情只到这里,我觉得还不能叫递归自我改进。

因为这和我们今天用Claude Code或者Codex开发一个软件,本质上没有太大区别。人还是提出问题,AI只是把写代码、调试这些工作做得更快。

真正让我觉得这个变化值得关注的,是OpenAI在7月底公布GPT-5.6的推理优化过程。

这次模型做的已经不是普通的软件开发了。

OpenAI披露,GPT-5.6 Sol通过Codex分析真实生产流量,寻找负载不均衡的问题,测试新的路由策略;它还自主重写和优化生产环境里的GPU Kernel。这一系列Kernel优化最终让端到端模型服务成本下降了20%。

更有意思的是 speculative decoding。

现在很多大模型为了提高生成速度,会让一个更小的draft model先预测接下来的Token,再让主模型一次验证多个结果。OpenAI让GPT-5.6 Sol去改进自己的这个draft model。

它自己设计并运行了数百个实验,测试不同的模型大小、结构和特征,还启动并监控训练,在遇到硬件故障和训练不稳定时自行干预。最后,这些优化让Token生成效率提高了超过15%。

这时候事情就开始有点不一样了。

模型正在优化运行模型的系统。

而这个系统变得更快以后,又可以用同样的GPU运行更多推理、做更多实验,下一轮模型研发的成本也随之降低。

真正变化的不是模型,而是AI研发开始出现反馈循环

我觉得理解这件事最重要的一点,是不要只盯着“模型有没有自己训练下一个模型”。

AI不是一个单独的模型文件。

从训练数据、训练框架,到GPU Kernel、Inference Engine、缓存、网络、调度、Agent Harness,再到最下面的芯片,这些东西共同决定了我们最终能以什么成本获得多少“智能”。

所以真正需要观察的是:

更强的模型,能不能帮助改善这一整套生产AI的系统。

如果可以,就会出现这样一个循环:

更强的AI帮助优化训练和推理系统,让同样的算力可以完成更多工作;更高的计算效率又让研发团队能够运行更多实验、降低推理成本;这些效率最终又支撑更强的下一代AI,而新的AI再继续优化这套系统。

OpenAI自己其实也把Inference优化称为一个“continuous feedback loop”。他们会观察真实生产系统、寻找最大的效率缺口、实施改进,再验证改进是不是对整个系统有效,而GPT-5.6和Codex正在加速这个循环里的每一个步骤。

今年6月发布的Jalapeño芯片,把这个循环又往下推进了一层。

这是OpenAI与Broadcom联合开发的第一款自有AI推理芯片。OpenAI称,从初始设计到完成流片只用了9个月,其中模型被直接用于加速一部分芯片设计和优化过程。

OpenAI在介绍这款芯片时甚至直接写了一句话:今天服务用户的同一批模型,正在帮助改进未来用于运行这些模型的基础设施。

这句话其实比“AI自己写代码”重要得多。

因为芯片效率提高以后,会降低未来模型的推理成本;未来更强的模型,又可以继续参与下一代芯片、Kernel和推理系统的优化。

这个循环开始跨越模型、软件和硬件。

这不是OpenAI一家正在发生的事情

如果只有OpenAI自己的案例,我们当然还可以把它理解成一种公司宣传。

但类似的事情也发生在Google DeepMind。

DeepMind去年发布的AlphaEvolve,是一个由Gemini驱动的算法发现Agent。它其中一个实际用途,就是优化Google自己的AI基础设施。

AlphaEvolve重新寻找了一种大型矩阵乘法的计算方式,让Gemini架构里的一个关键Kernel速度提高了23%,最终让Gemini整体训练时间缩短了大约1%。

1%看起来不多,但前沿模型一次训练消耗的计算资源非常巨大,这种百分之一级的改善已经意味着相当可观的算力节省。

在FlashAttention Kernel上,AlphaEvolve最高还获得了32.5%的性能提升。更关键的是,DeepMind明确提到,这些基础设施也被用于训练支撑AlphaEvolve本身的大模型。

也就是:

Gemini驱动AlphaEvolve,AlphaEvolve优化Gemini运行和训练所需要的系统,然后改善后的系统又被用于训练未来的Gemini。

这已经非常接近我理解的“现实版递归”。

不是AI突然坐下来发明一个比自己聪明十倍的新模型,而是它开始一点点改造生产自己的机器。

Anthropic最近甚至直接把这件事写成了一篇题为《When AI builds itself》的文章。

其中一个很有意思的数据是,截至今年5月,Anthropic合入生产代码中超过80%的代码已经由Claude编写。2026年第二季度,典型工程师每天合入的代码量大约是2024年的8倍。当然Anthropic自己也特别提醒,代码行数并不等于真实生产率,8倍显然会高估实际提升。

但更值得看的不是代码数量,而是实验能力。

Anthropic一直会给新Claude做一个测试:给它一段训练小型AI模型的代码,在保持结果正确的情况下,尽可能把训练速度优化到最快。

2025年5月,Claude Opus 4平均可以做到大约3倍加速;到了2026年4月,内部的Mythos Preview已经做到约52倍。Anthropic同样强调,这个数字不能理解成“真实大模型训练速度提高了52倍”,它真正反映的是,在一个目标明确的实验循环里,AI自己修改代码、运行实验、观察结果、继续迭代的能力,在一年里发生了非常大的变化。

但这还不是我们过去说的RSI

写到这里很容易得出一个更刺激的结论:

AI已经实现递归自我改进了。

我觉得目前还不能这么说。

Anthropic自己的表述其实非常克制。他们把完整的Recursive Self-Improvement定义为:一个AI系统能够自主设计并开发自己的继任者,然后新的系统继续重复这个过程。

对于这一点,Anthropic明确说:“We are not there yet。”

今天人仍然在这个循环里扮演非常关键的角色。

模型现在最强的地方,是当人给出一个比较清楚的目标后,它可以越来越独立地完成“怎么做”。

优化哪个Kernel、怎样降低延迟、怎么跑实验、为什么训练失败,这些执行和实验工作越来越适合交给Agent。

但“什么问题值得研究”“哪个方向更有价值”“结果是不是真的可信”,今天仍然大量依赖人的判断。

Anthropic的内部数据其实也说明了这一点。他们认为Claude已经可以在一个明确实验目标下达到甚至超过熟练研究人员,但到了选择研究目标、判断什么问题值得做的时候,能力差距仍然明显。

而且就算AI研发这一段变快十倍,也不意味着整个AI产业可以变快十倍。

芯片要制造,数据中心要建设,电力要接入,训练结果要验证。模型可以一天设计一百个ASIC方案,台积电也不可能第二天把一百块先进制程芯片交出来。

一个环节被加速以后,瓶颈只会转移到另一个环节。

所以我并不认为这些案例能够证明所谓的“智能爆炸”马上就会发生。

真正需要重新理解的,是AI为什么可能越来越快

但反过来,如果我们因为完整RSI还没有出现,就认为这件事完全没有发生,我觉得同样会错过一个很重要的变化。

过去AI进步主要依靠几样东西:更多算力、更好的数据、更大的模型,以及更优秀的研究人员。

现在正在多出一个新的变量:

上一代AI本身,开始成为研发下一代AI的工具。

而且这个工具不是简单提高一个程序员20%的编码效率。它正在进入训练、实验、Inference、Kernel、Harness乃至芯片设计这些真正决定AI成本和研发速度的位置。

这也意味着,以后判断OpenAI、Anthropic、Google之间的差距,可能不能只看下一张Benchmark排行榜。

更值得关注的问题是:

哪家公司能够建立更强的AI研发飞轮?

谁的模型能够帮助研究人员同时跑更多实验,谁能够更快找到GPU里的效率浪费,谁能够让自己的推理系统更便宜,谁又能够把这些经验继续带到下一代模型和芯片里。

这些东西不会像Benchmark那样每隔几个月有一张排行榜。

但它最终可能决定模型为什么会越来越快,也决定一家AI公司可以用同样数量的研究人员和GPU,产生多少新的“智能”。

我们过去讨论递归自我改进,总是在寻找一个很明确的时间点:到底哪一天,AI开始自己改进自己?

现在看下来,我越来越觉得,这个问题可能问错了。

也许根本不会有一个非常戏剧性的“RSI Day”。

它更可能是从这些看起来并不起眼的工程变化开始:AI先帮工程师写代码,然后开始调试自己的训练,再优化运行自己的Kernel和Inference系统,接着参与设计未来运行自己的芯片。

其中任何一步单独拿出来,都谈不上什么“智能爆炸”。

但当这些步骤逐渐连接起来以后,一个新的反馈循环确实已经出现。

今天我们还不能说AI已经能够独立创造下一代AI,但如果想理解接下来AI为什么可能进步得越来越快,真正值得盯住的,已经不只是模型本身,而是AI正在多大程度上参与生产下一代AI。

Anthropic CEO Dario Amodei说AI 5—10年能治愈大多数疾病,但谁有权踩刹车?

最近 Anthropic CEO Dario Amodei 和投资人 Gavin Baker 在 X 上吵了一场,我觉得这场争论比“AI 到底会不会取代工作”更值得看。

事情最早来自 All-In Podcast。Baker 批评 Dario,这些年他不断强调 AI 可能带来的灾难性风险,客观上正在帮助美国社会形成越来越强的 AI 反弹,特别是围绕数据中心的抵触。考虑到 Anthropic 已经成为全球最重要的 AI 公司之一,Baker 甚至建议 Dario 应该成为一个更加积极的 AI 行业倡导者,而不是继续告诉公众这项技术有多危险。

Dario 随后罕见地写了两篇很长的回复。他不同意自己只讲风险,反而重新提起了 2024 年那篇《Machines of Loving Grace》:如果足够强大的 AI 出现,人类有可能把未来 50—100 年的生物医学进步压缩到 5—10 年,甚至“治愈大多数人类疾病”。他还承认,这个说法听上去不仅普通人会觉得疯狂,连生物学家都会觉得疯狂——而他自己以前就是做生物学研究的。

这句话当然很夸张。但真正让我感兴趣的,不是 Dario 到底有没有吹牛,而是它把一个过去很容易被忽略的问题摆到了桌面上。

如果 AI 发展得太快,可能带来网络攻击、生物安全、模型失控以及其他现在还难以评估的风险;但如果 AI 真的能够大幅加速科学研究和药物研发,那么让它慢几年,同样不是没有代价。某些原本能够更早出现的药物和治疗,会不会因此晚几年到来?

到了这一步,“AI 应该快一点还是慢一点”就不再只是科技公司的产品节奏问题了。真正的问题变成了:谁有权踩油门,谁又有权踩刹车?

一、这不是“乐观派”和“悲观派”的争论

如果只看表面,很容易把 Baker 归到“加速派”,把 Dario 归到“安全派”。但认真看两个人说的话,会发现并不是这样。

Baker 并不否认 AI 的风险。他真正担心的是另外一种错误:因为不断强调最坏情况,社会最终形成过度反应,把 AI 基础设施、模型发展甚至那些真正有价值的科学应用一起压慢。

这种担心并非完全没有现实基础。Reuters/Ipsos 今年 6 月的一项调查显示,只有 33% 的美国人支持目前 AI 数据中心快速建设的速度,64% 反对,77% 担心数据中心最终推高电价。到了 8 月,宾夕法尼亚州已经收紧数据中心的审批规则,要求提高环境和项目透明度,并增加当地社区的参与。

但如果因此把美国今天的数据中心反弹归因于 Dario 的“AI 风险宣传”,明显又说过头了。普通人反对数据中心,很大一部分原因就是电价、用水、土地和当地能够得到多少就业与税收,这些都是非常现实的利益问题。

Dario 的立场其实也远比“让 AI 慢下来”复杂。他今年 6 月发表《Policy on the AI Exponential》,主张最前沿的模型应该接受强制第三方测试;如果模型在网络攻击、生物武器、模型失控或者自动化研发等方面跨过严重风险门槛,政府甚至应该有能力阻止或者撤销部署。

可是在同一篇文章里,他马上又把方向反了过来:到了生物医学,他认为真正值得担心的反而是 FDA、EMA 这样的监管体系太慢,跟不上 AI 可能带来的药物研发速度。

也就是说,同一个 Dario,一边想给 AI 踩刹车,一边又想拆掉新药路上的一些刹车。

这看起来矛盾,其实恰恰说明了问题:AI 根本不存在一个统一的速度。

二、AI真正没有的,是一个总开关

我们平时说“AI 发展太快”,其实把很多完全不同的事情混在了一起。

模型训练得有多快,是一件事;模型什么时候公开,是一件事;数据中心建多少,是一件事;AI 在企业里扩散多快,是一件事;AI 帮科学家寻找一个新的药物靶点,又是另外一件事。

这些速度为什么一定要一样?

Dario 自己的政策建议其实就是一个很好的例子。对于 frontier model,他希望更加谨慎,因为一次发布就可能把新的网络攻击、生物能力直接扩散出去;但到了生物医学,他担心的却是监管系统成为瓶颈。他甚至预计,如果 AI 大幅增加候选药物数量,今天按照传统节奏运行的审批体系很可能被“塞满”。

这个问题确实存在。FDA 过去给出的药物研发资料显示,从首次人体试验到批准,平均可以接近十年,而进入临床试验的药物最终真正获批的比例不到 10%。人体实验、长期安全性、剂量和疗效验证,都不像写代码一样可以通过增加 GPU 把速度无限提高。

而且就在今年 8 月,《Nature Reviews Drug Discovery》刚发表了一篇对 AI 药物研发非常克制的综述。作者认为,AI 在 Drug Discovery 里已经研究和应用了很多年,但真正能够证明它提高了临床成功率、让更安全有效的新药更快到达患者手里的证据,目前仍然非常有限。很多所谓 AI Drug 依然停留在临床前或者一期、二期,进入三期的还很少。

甚至 Anthropic 自己今年做的生物 Agent 研究也暴露了类似问题。让最先进的 AI Agent 直接从 NCBI Virus 这样的生物数据库获取病毒序列,准确率仍然达不到科研所需要的可靠程度;直到研究人员加入一个确定性的专用检索工具,准确率才提高到 90% 以上,最高达到 99.7%。

所以我并不认为“AI 五到十年治愈大多数疾病”可以直接当成一个医学预测。Dario 原来的表述其实还有一个经常被忽略的前提:这 5—10 年不是从今天开始计算,而是从他定义的 Powerful AI 出现以后开始。那个 AI 在他的想象里,已经相当于一个“装在数据中心里的天才国家”。

但即使把这个预测打很大的折扣,问题依然存在:当 AI 开始真实提高科研效率以后,减速也会产生机会成本。

三、踩油门和踩刹车,都在使用别人的风险预算

我觉得这才是这场争论真正有意思的地方。

一家 AI 公司决定提前半年发布一个更强的模型,获得收入、估值和市场份额的是公司自己;但如果模型增加了网络攻击、生物滥用或者其他社会风险,承担后果的显然不只是公司股东。

可反过来也一样。如果监管者因为一个尚未发生的风险,决定把某一类 AI 技术延迟几年,监管者自己同样不会承担全部成本。成本可能落在创业公司、普通开发者、科研人员身上,如果 AI 最终真的能够加速药物发现,也可能落到未来本可以更早得到治疗的患者身上。

换句话说,无论踩油门还是踩刹车,本质上都可能是在使用别人的“风险预算”。

所以我不太赞成一个很常见的答案:既然 AI 公司有利益冲突,那么交给政府决定就好了。这实际上只是把权力从一群人转给了另一群人。

AI 公司当然不能成为判断自己模型是否安全的唯一裁判,Anthropic 自己现在公开支持的也是这一点,认为影响如此大的技术不能只由行业自行治理。 但政府同样会犯错,也会受到政治周期、公众情绪和产业游说影响。如果合规门槛最终变得极其昂贵,它甚至可能成为现有 AI 巨头最好的护城河,因为真正能够负担这套成本的,恰好还是那几家公司。

所以真正的问题从来不是“公司还是政府”。

而是,谁应该决定哪一部分。

四、真正需要拆开的,是决定AI速度的权力

如果一定要给出一个我现在更倾向的答案,我觉得未来的 AI 治理不会,也不应该有一个“总刹车”。

法律首先应该决定边界。比如生物武器、大规模网络攻击、模型失控这类一旦发生可能影响整个社会,而且很难逆转的风险,显然不能完全交给一家公司的商业判断。

但是模型到底有没有跨过这条线,应该尽可能变成可以重复验证的技术问题,由独立第三方评测,而不是 CEO 在发布会上说一句“我们认为安全”,也不是某个政客凭感觉认为“这个东西很危险”。这其实也是 Dario 现在推动 frontier model 第三方测试的核心逻辑。

只要模型没有达到这些高风险阈值,企业仍然应该保留正常的技术和产品决策权。否则每一次模型升级都要经过漫长审批,最后最可能出现的结果并不是 AI 更安全,而是大公司越来越安全,小公司越来越难进入。

到了下游应用,逻辑还应该再反过来。医疗、材料、能源这些能够产生明确社会收益的领域,不应该因为 frontier AI 需要更严格的监管,就沿用同一套减速逻辑。如果未来 AI 真的能够显著提高药物研发成功率,那么临床试验设计、数据基础设施甚至审批制度都应该随着证据改变。

这里真正重要的不是经常被说烂的“发展与安全要平衡”。

而是把速度拆开,也把决定速度的权力拆开。

五、我们可能永远找不到一个正确的AI速度

当然,这套思路也没有解决最难的问题:我们可能根本不知道那条风险线应该画在哪里。

Dario 可能严重高估了 AI 对生物学的推动,Baker 也可能低估能力快速扩散产生的风险。AI 公司会判断错,监管机构同样会判断错。

所以我现在反而觉得,一个好的制度最重要的能力,可能不是第一次就把速度定对,而是能够随着新的证据快速纠错。风险越不可逆,门槛就应该越谨慎;风险越容易验证和回滚,就越没有必要提前阻止。规则本身也应该不断复审,而不是因为今天担心一种风险,就把它永久写进制度。

Anthropic 自己的 Responsible Scaling Policy 从 2023 年推出到现在已经连续修改,2026 年 7 月已经更新到 3.4 版。这至少说明一件事:就连目前最积极讨论 AI Safety 的公司之一,也不认为我们今天已经知道未来所有问题的答案。

Dario 在这场争论里还提到了一件很私人的事情。他的父亲死于丙型肝炎,而几年以后出现的直接作用抗病毒药 Sofosbuvir,可以治愈大约 95% 的患者。他说,如果这种药早几年出现,很可能就能救下自己的父亲。

我觉得这可能也是为什么他会同时表现出两种看起来非常矛盾的态度:一方面极度担忧 AI 的风险,另一方面又对 AI 加速生物医学抱有近乎激进的期待。

我不知道 AI 能不能在五到十年内治愈大多数疾病,我甚至觉得这个时间表很可能过于乐观。但如果未来 AI 确实能够把一些药物和治疗提前几年,那么我们今天讨论 AI 安全时,就必须同时承认另一件事:踩刹车也不是一个零成本的选择。

所以真正需要讨论的,已经不是“AI 应该快一点还是慢一点”。

而是什么应该快,什么应该慢;谁有权让它慢下来,又必须拿出什么证据;如果踩错了油门或者刹车,最后是谁承担代价。

如果 AI 最终没有 Dario 想象得那么强,这些问题可能显得太早。但如果它真的有一天开始接近他所说的那个“数据中心里的天才国家”,到那时再讨论谁有权踩刹车,可能就已经太晚了。

DeepSeek终于能看图了,但真正补上的不是多模态

8月21日,DeepSeek上线了一个新的实验模型DeepSeek-V4-Flash-Vision-Exp,最大的变化很好理解:DeepSeek终于可以直接看图了。

这件事情如果放在两年前,可能还算一个挺大的新闻,但到了今天,已经很难让人觉得新鲜。ChatGPT、Gemini、Claude早就支持图片输入,Google的多模态甚至已经做到了视频,DeepSeek现在才给V4加上Vision,怎么看都有点像是在补课。

而且严格来说,这也不是DeepSeek第一次做视觉模型。早在2024年,DeepSeek就发布过DeepSeek-VL,之后还有VL2、Janus这些多模态模型。真正不同的是,这次Vision终于进入了V4这条最核心的模型产品线,不再只是一个单独的研究模型。DeepSeek-V4-Flash-Vision-Exp可以直接处理图片、截图、图表和文档,也支持Tool Calls、Responses API以及Anthropic兼容接口,官方给它的定位也很明确,重点不是普通的图片问答,而是Multimodal Agent。

所以我看到这个模型的时候,第一反应并不是DeepSeek终于把“多模态”这门课补上了,而是想到前几天DeepSeek刚刚发布的Harness。

当时DeepSeek在官网上写了一个很简单的公式:

Agent = Model + Harness

模型负责智能,Harness让模型理解环境、使用工具,并且能够在真实环境里持续工作。现在再加上Vision,这个公式其实又完整了一点。

这几年做AI开发,我越来越明显地感觉到,Agent真正难的地方已经不只是模型够不够聪明,也不是会不会调用工具,而是它做完一件事情以后,能不能知道自己到底做成什么样了。

这恰恰是Vision对Agent真正重要的地方。

一、DeepSeek以前看不见,为什么Coding Agent照样很强?

这个问题其实挺有意思。

如果Vision是Agent非常重要的能力,那么DeepSeek V4过去一直只能接受文本输入,为什么它的Coding Agent能力还可以做得这么强?

原因是软件开发本来就是一个非常特殊的场景,大量信息天然就是文字。

Agent打开项目,读取的是代码;修改程序,操作的是文件;运行程序,看到的是Terminal;测试失败以后,返回的是错误日志。一个后端程序从修改代码、运行测试、发现错误,再到继续修改,整个反馈过程几乎都可以变成Token。

所以在这种环境里,AI其实并不需要真正“看见”什么。

DeepSeek自己做Harness的时候,甚至专门提供了一个Minimal Mode,只给模型一个Shell和一个文件编辑器,用这种极简环境来测试模型本身的Agent能力。V4 Flash此前在Terminal Bench 2.1已经做到82.7,新Vision版本进一步到了83.9。

但我自己在用AI做前端开发的时候,会很明显地遇到另外一个问题。

现在AI写React、Vue或者Flutter页面都已经没有太大问题,给它一个需求,它可以自己修改代码、启动程序,甚至发现编译错误以后继续修改。但代码最终在浏览器或者手机上变成什么样,它以前其实是不知道的。

比如一个按钮偏了,文字换行了,图片被拉伸了,某个弹窗挡住了下面的内容,这些问题都不会出现在Terminal里。

最后还是需要我看一眼,然后告诉它:“这里不对,再改一下。”

从这个角度看,人虽然已经不用自己写代码了,却仍然没有真正退出这个流程,因为人在给Agent充当眼睛。

这也是为什么我觉得DeepSeek这次补Vision,比“终于支持图片输入”要重要得多。

二、Agent真正需要的不是识图,而是知道自己做完以后发生了什么

我们以前理解多模态,经常是从Chatbot的角度理解的。

拍一张冰箱的照片,让AI告诉我里面有什么;上传一张财报,让它解释图表;旅游的时候拍一张菜单,让它翻译成中文。这些当然都是Vision的用途,但对于Agent来说,其实还有一个完全不同的需求。

Agent会行动,而行动会改变环境。

比如让AI订一张机票,它点击搜索以后,网页会出现新的结果;选择航班以后,又会进入新的页面;填写乘客信息以后,还可能弹出确认框。AI每做一步,都必须重新知道现在页面变成了什么样,否则它根本不知道下一步应该做什么。

OpenAI早期做Computer-Using Agent时,整个机制就是这样:模型先通过截图感知当前页面,进行推理以后操作鼠标和键盘,然后再拿到一张新的截图,继续下一轮判断。它实际上一直在重复“看一眼—做一下—再看一眼”的过程。

这和我们使用电脑其实没有本质区别。

我现在写这篇文章,如果点了一下保存按钮,也会下意识地看看页面有没有出现“保存成功”;改完一个网页,也会刷新以后看看结果。如果操作以后完全闭上眼睛,只按照自己脑子里想象的状态继续点下去,很快就会出问题。

AI Agent也是一样。

所以Vision对于Agent真正重要的,不是让它知道“一张图片里有什么”,而是让它知道:

我刚才做完这件事情以后,现在变成什么样了。

这个区别看起来不大,但它其实决定了Agent能不能形成真正的闭环。

以前做一个前端页面,流程可能是AI写代码,我看结果,再让AI修改;以后更完整的Agent则可以自己写代码、打开浏览器、截图、对照设计稿,发现差异以后继续修改,再重新截图检查。

人是不是可以彻底退出,今天当然还做不到,但至少少了一次必须由人完成的信息转换。

三、把V4、Harness和Vision放在一起,事情就变得有意思了

如果只看DeepSeek这次发布Vision,很容易理解成它终于开始追赶GPT、Gemini和Claude的多模态能力。但把过去几个月DeepSeek做的事情放在一起,我觉得看到的东西不太一样。

4月份发布V4的时候,DeepSeek已经把Agentic Coding作为一个重点能力来介绍,V4 Flash虽然比Pro小很多,但在简单Agent任务上已经能够接近Pro,而且速度更快、价格更低。DeepSeek当时还特别提到,V4已经被用于公司内部的Agentic Coding。

到了8月份,DeepSeek又自己做了Harness。

这件事情我之前专门写过。模型再强,如果怎么读代码、什么时候调用工具、如何管理上下文、失败以后怎么恢复这些事情做得不好,最后的Agent体验还是会有很大差别。所以DeepSeek不再只训练模型,而是开始往模型外面再走一层,把工具、Skills、Session、Sandbox、Subagent、Workflow这些能力都放进自己的Harness里。

现在Vision也来了,同时还有Files API。

一张图片可以先上传,然后在后面的Agent任务中反复引用;Responses API也可以直接接收图片。这意味着DeepSeek现在开始把以前分开的几件事情接起来:模型负责推理,Harness负责调用工具和执行任务,Files保存任务需要的信息,Vision则负责理解那些没有办法直接变成文本的环境状态。

当然,我并不认为这意味着DeepSeek已经有了一套完整的Computer Agent。Harness还是Developer Preview,Vision名字后面也还有一个Exp,现在连正式版都算不上。

但DeepSeek的方向已经越来越清楚了。

过去我们关注DeepSeek,更多是在讨论它的模型本身:参数多少、Benchmark多少、价格比OpenAI和Anthropic便宜多少。现在这些事情依然重要,但DeepSeek开始越来越多地解决另外一个问题:

怎么让模型真正把一件事情做完。

这其实也是整个AI行业过去一年最大的变化之一。

四、Vision放在Flash上,可能比跑分更值得关注

DeepSeek这次公布了不少Benchmark,Vision版本在ApexBench Pass@1上是36.5,Agents’ Last Exam是27.3,Chartography是64.3,ZeroBench Pass@5是35.0。与Claude Opus 4.8相比,这四项视觉相关评测是两项领先、两项落后,DeepSeek因此说自己的Multimodal Agent能力已经“接近Opus 4.8”。不过这些目前主要还是DeepSeek自己公布的数据,而且在NL2Repo、DSBench-Hard这样的任务上仍然存在比较明显的差距,所以现在就说DeepSeek视觉能力已经追平Claude,还为时过早。

相比这些跑分,我反而更关注另外两个数字。

第一个是这个Vision模型没有放在Pro上,而是放在了V4 Flash上;第二个是图片经过处理以后,每张最多只计算384个输入Token。

这两个选择很符合DeepSeek一直以来的思路。

普通用户和AI聊天,看一张图片可能只调用一次,但Agent不是这样。一个浏览器Agent完成一次任务,可能需要看几十次页面;一个前端Agent为了把页面调整到正确状态,也可能不断截图、比较、修改,再截图。如果每看一次都很贵,那么视觉能力再强,也很难真正放进大规模的Agent工作流里。

所以进入Agent时代以后,模型价格真正应该比较的,可能也不是单纯的每百万Token多少钱,而是完成一件事情最终需要多少钱。

这里面既包括模型能力,也包括成功率、执行轮数、缓存、Harness效率,现在又多了视觉成本。

这也是为什么DeepSeek把Vision先放进Flash很值得关注。它未必是在急着证明自己拥有世界上最强的视觉模型,更像是在继续做DeepSeek过去一直做的事情:把一个原本比较昂贵的能力,压到可以被大量调用的位置。

五、看得见以后,离真正“做完事情”还有很远

当然,有了Vision也不等于Agent就真的会用电脑了。

OpenAI早期的Computer-Using Agent已经拥有视觉、推理以及鼠标键盘操作能力,但在OSWorld这个真实电脑操作Benchmark上的成功率也只有38.1%,人类则是72.4%。原因并不难理解,看懂一个页面、知道按钮在哪里,与连续几十步都不出错,本来就是两件完全不同的事情。

一个Agent如果连续执行20步,每一步都只有一点点出错概率,最后累积起来也可能让整个任务失败。再加上网页弹窗、网络延迟、界面变化、验证码、权限和各种没有预料到的情况,真实世界远比Benchmark复杂。

所以我觉得,DeepSeek这次Vision真正值得关注的地方,并不是它已经把Computer Agent做成了,而是它终于补上了此前一个很明显的缺口。

这几年我们一直在给AI做一个越来越聪明的大脑。模型会推理、会写代码、会规划任务;随后又给它接上工具,让它可以搜索、读文件、运行程序。到了Agent这一步,它还必须能够感知自己的行为给外部世界带来了什么变化,否则再聪明的大脑,也很难独立把事情一直做下去。

从V4到Harness,再到这次Vision,DeepSeek正在把这些东西一点点接起来。

过去我们比较模型,总是在问谁回答问题更好;进入Agent时代之后,真正重要的问题可能会慢慢变成:它能不能自己看到发生了什么,发现事情没有按照预期发展以后继续修改,直到最后真的把结果交出来。

从这个角度看,DeepSeek这次补上的确实不只是多模态。

它开始给自己的Agent,补上一双眼睛。

Jeff Dean离开Google后首次公开访谈:AI真正值得自动化的,可能不是工作

8月7日,Jeff Dean参加了斯坦福AASF 2026的一场Fireside Chat,这是他正式离开Google之后的第一次公开访谈。就在前一天,他结束了自己在Google长达27年的工作,与Sanjay Ghemawat、Quoc Le和Oriol Vinyals一起创办了Discovery Loop。

Jeff Dean在Google的地位比较特殊。从Google早期的MapReduce、BigTable等分布式计算基础设施,到后来Google Brain、TensorFlow、TPU,再到Gemini,他几乎参与了Google过去二十多年最重要的几次技术变化。所以他在这个时间选择离开Google,自然是这次访谈最受关注的问题。

Jeff Dean对此倒没有给出一个很戏剧性的解释。他仍然看好Google和Gemini,也没有把离职描述成与Google之间存在什么路线分歧。他认为现在云计算已经让小公司也可以获得过去只有大公司才能拥有的计算资源,而一个十个人左右的小团队,可以把所有精力都集中在同一个问题上。Google最终也成为Discovery Loop的投资者和Cloud合作伙伴,并为其第一年提供计算资源。

不过整场访谈看下来,我反而对Discovery Loop想做的事情更感兴趣。

这家公司想解决的问题是:能不能用AI把科学研究中的实验过程自动化。

从自动化工作,到自动化实验

过去几年,AI商业化最主要的方向,都是提高已有工作的效率。

Coding Agent帮助程序员写代码,客服Agent回答用户问题,Sales Agent寻找客户,Research Agent查找资料,现在Computer Use又开始直接操作浏览器和各种软件。

这些产品为什么容易找到商业价值,其实很好理解。原来一个任务需要10个人,现在5个人就能完成;过去需要一天的工作,现在一个小时做完。企业很容易计算用了AI以后节省了多少成本,所以这也是目前AI最容易形成商业闭环的地方。

我自己平时开发软件已经大量使用AI Coding,所以对于这部分价值,我没有什么怀疑。现在很多软件开发工作已经可以让AI完成,而且随着Coding Agent能力继续提高,这个比例还会越来越高。

但Discovery Loop考虑的是另外一种可能。

科学研究同样存在大量重复工作。一个研究人员提出一个假设,然后需要设计实验、写代码、运行实验、观察结果,再根据结果决定下一步做什么。Discovery Loop认为,现在很多科学研究的瓶颈,就在于这些实验仍然主要依靠人一个接一个地完成,速度很慢,也很难大规模并行。

他们希望利用前沿AI模型和大规模计算基础设施,把这整个实验循环自动化,让AI可以提出实验、执行实验、分析结果,再根据结果继续下一轮,并且同时运行数千个实验。

如果只是把这些事情理解成“AI帮助科学家提高工作效率”,其实和Coding Agent也没有太大区别。

但当实验数量可以从一个人一天做几个,变成AI同时做几千个以后,变化可能就不只是效率提高了。

很多以前根本没有时间尝试的方向,现在可以尝试;很多因为搜索空间太大而不得不依靠经验提前放弃的方案,也可以真正跑一遍看看结果。

这也是我觉得Discovery Loop比较有意思的地方。

过去十几年,我们一直在Scale Intelligence

如果把2012年以来这一轮AI的发展简单概括一下,我觉得大致可以理解为:

Scaling Compute → Scaling Models → Scaling Intelligence

这当然不是一个严格的技术发展阶段,只是方便理解过去十几年AI行业到底在做什么。

从GPU开始,到后来Google的TPU,再到今天动辄几十万张GPU的数据中心,整个行业一直在投入更多计算资源。更大的算力让我们能够训练更大的模型,而模型能力又随着架构、数据和训练方法的改进不断提升,最终才有了今天的大语言模型。

Jeff Dean在这次访谈里回忆,当年Google做语音识别时,他们把神经网络扩大大约50倍,一次实验带来的性能提升,就可以和这个领域过去几年积累的进步相比。这也是为什么后来Google非常重视Scaling。

当然,大模型能力提升并不只是因为模型变大。Transformer、Mixture of Experts、数据质量、后训练、强化学习等都发挥了重要作用。但从产业投入的角度看,过去十几年确实有一条非常明显的主线:不断把更多Compute转换成更多Intelligence。

现在这件事情已经发展到了一个比较有意思的阶段。

模型已经可以写代码、推理、调用工具,也开始能够连续工作几个小时。虽然距离真正可靠的自主Agent还有不少问题,但至少我们已经拥有了过去很难想象的大量“机器智能”。

所以接下来有一个问题就变得越来越重要:

这些已经获得的Intelligence,最终可以用来做什么?

Discovery Loop给出的答案,是继续把它转换成更多实验。

Scaling Experiments

Discovery Loop准备先从机器学习研究开始,而且首先拿自己做实验。

比如研究一个新的模型架构,过去研究人员需要先想方案,再修改代码、训练模型、跑Benchmark,然后根据结果决定下一步。如果一个方案效果不好,再换一个方向继续尝试。

这个过程很适合AI,因为结果相对容易验证。

AI完全可以同时提出大量架构或者训练方案,自动生成代码,调用计算资源进行训练,然后根据Benchmark结果选择下一轮更值得投入的方向。

WIRED在采访Discovery Loop四位创始人时,Quoc Le甚至提到,这样的系统未来也许能够找到一种不同于Transformer的新架构。公司计划先通过自动化机器学习研究来改进自己的AI能力,然后再把同样的方法扩展到芯片设计、生物、药物和材料等领域。

所以如果沿着过去十几年Scaling的逻辑继续往下看,我觉得可能会出现另外一条链路:

Scaling Intelligence → Scaling Experiments → Scaling Discovery

以前增加更多算力,主要是为了得到一个能力更强的模型。

如果Discovery Loop这条路能够成立,以后同样的算力还可以被用来同时探索成千上万个不同的假设。

这时候被放大的,就不只是模型的能力,还包括人类探索未知问题的速度。

我觉得这可能是AI接下来一个很值得关注的方向。

为什么科学研究很适合Agent

这也让我重新思考了现在大家都在做的AI Agent。

目前绝大部分Agent,本质上还是人先给出一个目标,然后AI完成执行。让它写一个程序、查一份资料、分析一张表格,或者帮你订一张机票,目标通常都是人定义好的。

科学研究会更进一步,因为实验做完以后,还需要根据结果决定下一步做什么。

一个方案失败了,是继续修改,还是换一个方向?一个异常结果是噪声,还是值得继续研究?有限的计算资源应该分配到哪些实验上?

这实际上形成了一个完整的反馈循环:

提出假设 → 实验 → 得到结果 → 再提出新的假设。

Coding Agent现在之所以发展得比较快,也和这个特点有关。程序写完以后,可以编译,可以运行测试,有非常明确的外部反馈告诉AI刚才做得对不对。

科学实验当然复杂得多,但如果一个研究领域同样能够提供比较清楚的反馈,它就很适合形成这样的Agent Loop。

Discovery Loop在官网上也专门强调,他们目前关注的是具有“可衡量结果”的Learning Loop。

这个限定其实很重要。

科学发现没有那么容易自动化

机器学习研究是比较理想的场景,因为很多实验只需要计算资源,结果也可以通过Benchmark快速验证。

但到了药物、生命科学或者材料研究,情况会复杂很多。

很多实验需要真实的实验设备,一次实验可能需要几天甚至几个月,结果也会受到大量现实因素影响。AI可以在一个小时里产生一万个药物分子,但这并不意味着现实中的实验室可以在一个小时里完成一万次验证。

所以我并不认为,只要模型再强一点、GPU再多一点,就可以把整个科学研究自动化。

另外还有一个我觉得更重要的问题。

如果未来AI真的能够非常便宜地产生大量假设和实验方案,那么真正稀缺的能力可能会继续往上移动。

什么问题值得研究?为什么这个结果值得关注?哪个看起来失败的实验其实隐藏着新的方向?一个结果到底只是统计意义上的提升,还是具有真正的科学价值?

这些问题未必能简单通过增加实验数量解决。

所以未来科学家的工作可能会发生变化,但很难简单理解为“AI把科学家替代了”。实验执行成本下降以后,问题定义、方向选择和判断的重要性反而可能进一步提高。

AI可以创造的价值,也许还有另外一种

过去几年,我们讨论AI对经济和就业的影响,经常会落到一个问题上:它最终能够替代多少工作?

这个问题当然很重要,因为企业现在投入AI,很大一部分目的就是提高生产率、降低成本。这也是AI能够快速商业化的基础。

但如果把时间拉得更长一点,我还是觉得,AI能够产生的价值不应该只用“减少多少人”来衡量。

过去100个人完成的工作,现在20个人完成,是很大的生产率进步。

但如果AI能够帮助科学家找到过去找不到的新药,设计过去无法设计的材料,或者让一个过去需要十年才能探索的问题,在更短的时间里找到答案,它产生的是另外一种价值。

后者并不一定比前者更容易实现,甚至可能困难得多。但从人工智能这项技术最终能够给人类带来什么来看,我还是更期待这样的应用。

Jeff Dean过去二十多年参与做的事情,很大程度上是在解决怎样把更多Compute变成更多Intelligence。从分布式计算、TPU、TensorFlow,一直到今天的大模型,都可以放在这条线上理解。

现在离开Google以后,他选择继续往后走一步,尝试把已经得到的Intelligence转换成更多Experiment,再看看这些Experiment最终能不能转换成更多Discovery。

这件事情最后能做到什么程度,目前还不知道。Discovery Loop也才刚刚成立,很多愿景距离真正落地还有很远。

但相比AI还能替我们完成多少已有的工作,我觉得这个问题确实更值得期待:

当我们已经拥有越来越多机器智能以后,能不能用它去解决一些过去人类没有能力解决的问题?

如果可以,AI下一阶段值得Scale的东西,就不只有模型和算力了。

科学发现本身,也可能成为Scaling的一部分。

DeepSeek V4涨价后,真正的问题不是谁在用,而是谁在赚钱

过去一年,DeepSeek给市场留下最深的印象之一,就是“便宜”。

到了 V4 Flash,DeepSeek 更是把低价策略推到了极致:涨价前,100 万输入 Token 只要 0.14 美元,输出 Token 也只有 0.28 美元。再加上开放权重,它很快进入了大量 Coding Agent、API 聚合平台和开发者的实际工作流。

所以当DeepSeek宣布从8月17日起提高V4 API价格时,我更关心的不是“涨了多少”,而是涨价之后发生了什么。这次调整幅度并不小,不同模型、Token类型和使用时段,涨幅从约50%一直到1100%。

答案很有意思:一些可观察平台上的调用量明显下降,但DeepSeek模型本身并没有失去市场地位。截至8月19日,OpenRouter最近七天的Token榜上,V4 Flash 0731仍以11.2T Token排名第一。

这指向一个比涨价更重要的问题:开放权重模型可以拥有巨大的市场份额,但这些调用产生的钱,最后真的会回到模型公司手里吗?

一、调用量掉了一半,收入却未必跟着掉

先看这次涨价。

DeepSeek现在把V4 API分成峰值和非峰值两档。以V4 Flash为例,涨价前Cache Miss输入价格是0.14美元/百万Token,输出0.28美元;现在非峰值变成0.22美元和0.66美元,峰值则达到0.44美元和1.32美元。V4 Pro涨幅更大,目前峰值输入和输出价格分别达到1.32美元和3.96美元。

涨价之后,OpenCode上的V4 Flash使用量很快出现变化。社区根据OpenCode公开图表读取的数据,8月17日前后,日Token量大约从13T下降到5.5T,降幅接近58%。

这里要特别说明:这不能理解为DeepSeek全市场调用量下降58%。OpenCode只是Coding Agent场景,而且13T和5.5T是社区对公开图表的读取,不是DeepSeek官方披露,但仍可以作为一个价格弹性样本。目前OpenCode自己的数据仍显示,V4 Flash过去一周排名第一,占其观察到的Token流量约73%。

如果调用量从13T降到5.5T,相当于剩下原来的42.3%。这意味着,只要平均价格提高到原来的2.36倍,理论收入就可以回到涨价前水平。

巧的是,V4 Flash输出Token的非峰值价格正好从0.28美元涨到0.66美元,差不多也是2.36倍;峰值则达到原来的4.7倍。

所以,“调用量下降近六成”并不能直接推导出“收入下降近六成”。如果涨价让DeepSeek用更少算力处理更少Token,却获得接近的收入,从商业上看反而可能更划算。

当然,这只是敏感性测算,不是DeepSeek真实营收。真实收入还取决于输入输出比例、缓存命中率、峰谷时段和大客户折扣。OpenCode显示,V4 Flash输入Token的Cache Ratio高达96%,也说明不能拿总Token直接乘牌价。

但更大的问题还在后面。

二、用户可以离开DeepSeek API,却不用离开DeepSeek

现在打开OpenRouter上的V4 Flash 0731,会看到一个很有意思的页面:同一个DeepSeek模型,一共有28家Provider在提供推理服务。

DeepSeek官方线路现在是0.22美元输入、0.66美元输出;Relace只要0.07美元和0.14美元,DeepInfra、Cloudflare是0.08美元和0.18美元,Fireworks、Together、SiliconFlow等一批服务商仍在0.14美元和0.28美元附近。

也就是说,DeepSeek官方API涨价以后,开发者并不需要在“继续用DeepSeek”和“换掉DeepSeek”之间二选一。

还有第三个选择:继续用V4,只是不再把钱付给DeepSeek。

开放权重模型一旦被大量第三方部署,模型公司就不再拥有对推理服务价格的绝对控制。

截至8月19日,V4 Flash 0731在OpenRouter七日榜仍以11.2T Token排名第一。DeepSeek生态依然很强,但OpenRouter也提醒,这些数字只代表平台Token流量,不代表整个市场,更不代表收入。

这正是理解开放权重商业模式最重要的一层:

模型份额、官方API份额和公司收入,其实是三个不同的指标。

一个闭源模型如果获得更多API调用,模型提供商通常能够比较直接地分享增长带来的收入。开放权重却不是这样:模型可以越来越流行,但运行这些模型的服务器、提供API的公司,以及最终收到钱的人,可以完全是另外一家企业。

这也是为什么,我觉得这次DeepSeek涨价真正值得观察的,不是“大家还用不用DeepSeek”,而是这些继续使用DeepSeek的人,究竟通过谁来使用。

三、开放权重最大的优势,也限制了自己的定价权

如果只看生态,DeepSeek的开放策略非常成功。

OpenRouter在6月底的分析里提到,DeepSeek年初的Token份额不到10%,2、3月一度掉到5%;V4发布后,到6月初已接近20%。1月到6月,份额从9%翻到18%,并从5月中旬开始成为平台上调用量最高的模型厂商。

更重要的是,增长主要来自Agent。OpenRouter统计,Agent工作负载平均每次请求消耗的Token约是普通调用的15倍;到5月底,V4 Flash已占DeepSeek Agent Token流量的70%。这说明V4已经进入高Token消耗的工作流。

这也是DeepSeek最成功的地方。

低价格降低了尝试成本,开放权重降低了长期绑定风险,足够强的模型能力又让开发者敢于把真实任务交给它。三者叠加之后,V4很快从一个“便宜模型”变成了大量Agent工作流里的基础设施。

但开放权重带来的悖论也正在这里出现。

它让更多云厂商愿意部署,让开发者更放心地接入,也让企业拥有自部署选择。可当生态越来越成熟,第三方推理优化和价格竞争也会越来越充分。

最后可能出现一个反直觉的结果:

DeepSeek模型越来越成功,但DeepSeek官方API在整个DeepSeek生态里的占比反而下降。

这并不意味着开放权重是错误选择。第三方Provider越多,V4越容易成为事实上的基础模型标准,生态本身就是护城河。问题只是,生态创造的价值和公司能够捕获的价值,并不是一回事。

OpenRouter自己其实已经观察到了这种分离。它在6月底的报告里特别指出,DeepSeek Token份额快速上升,并没有带来同等幅度的Spend份额增长,原因恰恰是V4太便宜。

现在DeepSeek开始涨价,本质上就是在尝试缩小这两个数字之间的距离。

四、DeepSeek真正要证明的,是如何把生态变成收入

所以我更愿意把这次涨价看成一次商业模式压力测试。

DeepSeek已经证明了第一件事:开放权重、低价格和足够强的模型能力,可以迅速换来开发者生态和Token份额。

现在它要证明第二件事:当市场形成以后,能不能提高变现率,把其中一部分生态价值转化成公司的收入和利润。

这件事正在变得越来越重要。Reuters报道,DeepSeek正在进行新一轮融资,同时扩大数据中心和AI Agent团队,并招聘芯片设计工程师。前沿模型竞争越来越烧钱,训练、推理、数据中心和人才最终都需要真实现金流支撑。

但DeepSeek又不能像闭源公司一样简单依靠“锁住模型”提高价格。只要第三方仍能用更低价格运行V4,官方API的涨价空间就会受到限制。

因此,DeepSeek未来真正需要建立的,可能不是最便宜的Token,而是第三方难以替代的价值:更稳定的第一方服务、最新模型优先访问、更好的缓存与Agent基础设施、企业级支持,甚至进一步向Harness和应用层走。

这里有一个很有意思的区别。

Meta做开放模型,可以把模型带来的价值反馈到广告、社交平台和整个Meta生态;阿里做开放模型,可以通过云计算承接推理和企业客户。它们不一定要求模型API本身成为最大的利润中心。

而像DeepSeek这样更接近“纯模型公司”的企业,问题要直接得多:

开放出去的模型,最后如何反过来养活模型公司本身?

DeepSeek V4这次涨价,给了我们一个难得的观察窗口。

调用量下降,不一定意味着收入下降;模型份额继续增长,也不等于公司的收入份额同步增长。对于开放权重模型来说,“大家都在用”只是商业成功的一半。

另一半是,这个生态能不能形成足够稳定的现金流,让公司继续训练下一代模型、购买算力、招募人才,并长期留在前沿竞争里。

开放权重已经证明,它可以创造巨大的生态价值。

DeepSeek接下来真正需要证明的,是它也能从自己创造的生态里,捕获足够多的价值。

Stripe花80亿美元买OpenRouter,真正值钱的为什么不是AI模型?

一周前,OpenRouter 联合创始人兼 CEO Alex Atallah 参加 20VC 访谈时,主持人 Harry Stebbings 在节目开始和结束前都追问了同一个问题:Stripe 是不是准备花 100 亿美元收购 OpenRouter?Atallah 没有回答,只说自己不能评论。

几天之后,这个传闻变得越来越接近现实。Axios 在 8 月 17 日报道,Stripe 已经同意以超过 80 亿美元的现金和股票收购 OpenRouter;Bloomberg 此前也报道称双方已经签署协议。不过截至本文发稿,Stripe 和 OpenRouter 仍未正式官宣,Axios 称官方公告预计本周发布。因此,“80 亿美元”目前仍然是媒体报道的交易价格,而不是双方正式公布的最终数字。

真正让我觉得有意思的,并不是 80 亿美元这个数字本身,而是 OpenRouter 到底是一家什么公司。

它不训练 GPT,不训练 Claude,也没有像 Google、Meta 那样投入巨额资本建设自己的基础模型。两个多月前,OpenRouter 刚刚完成 1.13 亿美元 B 轮融资,当时估值大约 13 亿美元;现在媒体报道的收购价格已经超过 80 亿美元。更夸张的是它的使用规模:今年 5 月底,OpenRouter 披露每周处理 25 万亿 Token、服务 800 万以上开发者和 400 多个模型;目前官网显示的数据已经变成每月 200 万亿以上 Token、1000 万以上用户、80 多家推理服务商和 500 多个模型。

一家自己不生产 AI 模型的公司,为什么会在短短几个月里变得这么值钱?

我觉得真正值得讨论的,恰恰不是 OpenRouter 会不会成为下一家伟大的 AI 公司,而是 AI 产业的价值正在发生一个很容易被忽略的变化:过去几年,我们一直在争论谁能制造最强的智能;当模型越来越多以后,另一个问题开始变得同样重要——谁来决定这些智能应该被怎么使用。

一、OpenRouter不卖模型,它卖的是“选择模型”

如果把 OpenRouter 理解成一个“AI API 聚合平台”,很容易觉得这门生意没有多少技术含量。开发者只需要接入一个 API,就可以调用 OpenAI、Anthropic、Google、DeepSeek、GLM 以及大量开放模型,听上去不过是在不同模型的 API 前面再加了一层转发。OpenRouter 现在也确实把自己定义为连接所有模型的统一接口。

但真正复杂的地方,是同一个任务应该发给谁。

现在一个开发者面对的已经不是“要不要使用 GPT”,而是一个越来越复杂的组合:哪个模型能力更合适,哪个价格更低,哪个延迟更小;同一个开放权重模型又可能同时运行在十几家甚至几十家推理服务商上,不同服务商的速度、稳定性、Tool Calling 质量还不完全一样。OpenRouter 的 GLM 5.2 页面目前就列出了 27 家推理服务商,这意味着即便模型名字完全相同,一次请求背后仍然存在很多不同的执行路径。

OpenRouter 现在做的事情,就是把这些选择逐渐自动化。它的 Auto Exacto 系统会根据吞吐速度、真实 Tool Calling 表现和 Benchmark 结果,大约每五分钟重新评估一次不同推理服务商。OpenRouter 称,从 2025 年 8 月开始已经记录和评估了数十亿次 Tool Call。在今年 3 月的一次调整中,GLM-5 的 Tool Call 错误率从大约 8% 降到了接近 1%。

所以 OpenRouter 真正解决的,并不是“怎么调用 500 个模型”,而是一个更像基础设施的问题:在价格、能力、速度和可靠性都不断变化的情况下,这一次 AI 计算到底应该交给谁。

这和支付其实已经有一点像了。我们刷一张银行卡的时候,很少关心一笔交易最后经过哪条支付通道;真正需要关心这些事情的是支付基础设施。未来一个 AI 应用也可能一样,用户并不需要知道后台这一轮回答到底用了 GPT、Claude 还是 DeepSeek,只要结果足够好、足够快、成本足够低。

二、真正的壁垒,不是那段“路由代码”

当然,如果 OpenRouter 的价值只是写了一套路由算法,80 亿美元显然很难解释。

模型路由并不是只有 OpenRouter 能做。云计算厂商可以做,模型公司可以做,Cursor、Claude Code 这样的 Harness 也可以自己选择模型,企业还可以自己部署 Gateway。甚至从技术上看,一个最简单的 Router 并不困难:贵的任务发给最强模型,简单任务发给便宜模型,失败以后切换到另一个 Provider。

所以 OpenRouter 更值得看的,其实不是 Routing 本身,而是它站的位置。

截至目前,OpenRouter 已经连接 500 多个模型、80 多家 Provider 和 1000 万以上用户,每月流经平台的 Token 超过 200 万亿。规模到了这里以后,它获得了一种模型公司很难拥有的数据:模型在真实世界到底是怎么被使用的。

模型公司拥有的是训练智能的数据,OpenRouter 看到的则更接近“如何消费智能”的数据。什么任务最后选择了什么模型;价格变化之后调用量发生了什么变化;同一个模型在哪家 Provider 表现更稳定;Tool Calling 失败发生在哪里;一个新模型发布以后,用户到底只是尝鲜,还是会持续迁移过去。OpenRouter 与 a16z 去年基于超过 100 万亿 Token 做的使用研究,本身就说明了这种位置的独特性:它可以横跨大量开放和闭源模型,观察真实世界中的使用、迁移和任务分布。

这也是为什么我不太愿意把 OpenRouter 简单称为“AI 中间商”。

传统意义上的中间商,往往只是把供给和需求连接起来;OpenRouter 真正想做的是在供给越来越复杂之后,替需求方做判断。模型越多,这个判断问题越复杂;平台上的调用越多,它又越有可能积累更多真实反馈,继续改善判断。

它现在的商业模式甚至也有一点支付平台的味道:OpenRouter 对底层推理价格原则上不加价,而是在购买 Credits 时收取平台费用,目前非加密支付为 5.5%。

这才是 80 亿美元背后更值得看的东西。

三、为什么偏偏是Stripe?

如果理解了这一点,再看 Stripe,就会发现这笔交易其实没有表面上那么跨界。

今年 1 月,Stripe 已经收购了 Metronome。这家公司专门解决 Usage-based Billing,也就是按照实际使用量计费的问题。Stripe CEO Patrick Collison 当时判断,Usage-based 商业模式会成为未来十年的重要变化,而 Metering 和 Billing 实际上是“产品”和“商业”之间的接口。Metronome 的计量引擎已经服务 OpenAI、Anthropic 和 NVIDIA 等 AI 公司。

同一个月,Stripe 还专门公布了与 OpenRouter 的合作:OpenRouter 负责把开发者的请求路由到不同模型,Stripe 负责记录实际使用量、应用价格并完成计费。Stripe 当时已经明确表示,它正在建设 AI 的“经济基础设施”。

这两个动作放在一起看,Stripe 买 OpenRouter 的逻辑就容易理解很多。

过去 Stripe 解决的问题,是互联网世界里“一笔钱应该怎么流动”。商家不需要自己连接每一家银行、每一种支付方式、每一个国家的税务和结算体系,只需要连接 Stripe。到了 AI 时代,Token 本身也越来越像一种按照使用量实时发生的成本:模型不同,价格不同;Provider 不同,价格也可能不同;缓存、上下文长度、推理时间都会影响最终成本;一次 Agent 任务还可能连续调用很多次模型。Stripe 自己这几年持续加强 Usage-based Billing,也正是因为 AI 推理成本已经让这种计费方式变得越来越重要。

如果未来一个 Agent 要自主选择模型、购买计算资源、完成任务并结算成本,那么“模型路由”和“资金结算”其实会越来越靠近。

OpenRouter 决定的是 Intelligence Flow——这一份任务应该由哪一种智能来完成;Stripe 擅长的是 Money Flow——这次使用应该怎么计量、收费和结算。

从这个角度看,Stripe 真正想得到的可能并不是一个 AI 模型入口,而是把自己原本擅长的“交易基础设施”,继续往 AI 计算发生的那一刻推进。

四、模型越便宜,Router反而可能越值钱

这里还有一个很反直觉的地方。

通常我们会认为,AI 模型价格不断下降,会压缩所有卖 Token 公司的价值。但对 OpenRouter 来说,情况可能正好相反。

如果未来始终只有一个模型明显比其他模型强,那么 OpenRouter 其实没有多大存在必要。大家直接调用那个模型就可以了。Router 真正有价值的前提,是模型市场足够丰富,而且大量任务存在多个“足够好”的选择。

现在至少从供给数量来看,正在发生的恰恰是这个变化。OpenRouter 已经支持超过 500 个模型,一个模型又可能由多家 Provider 提供;其基于 100 万亿 Token 的研究也观察到了开放权重模型的大量采用,以及 Agentic Inference 的增长。

于是“哪个模型最强”开始变成一个越来越不完整的问题,更实际的问题是:对这一项具体任务来说,哪个模型在能力、成本和速度之间最合适?

这对中国开放模型尤其有意思。过去一个模型要获得使用量,需要开发者主动接入、测试和迁移;在 Router 越来越普及以后,一个模型甚至不需要让最终用户知道自己的名字。只要它在某类任务上拥有足够好的性价比和稳定性,Router 就有可能自动把请求分给它。OpenRouter 目前已经为不同模型提供按照价格、速度以及 Tool Calling 表现选择 Provider 的路由方式,这种机制本身就在降低开发者手动做选择的必要性。

换句话说,未来模型公司的竞争不只是让用户选择自己,还可能变成让 Router 愿意选择自己。

这也是 OpenRouter 这类平台真正有意思的地方。它不是和 OpenAI、Anthropic、DeepSeek 去争夺“谁拥有最强模型”,而是在赌另一个市场:当模型越来越多以后,选择模型本身会不会成为一种基础设施。

五、但80亿美元买的仍然是一场赌局

当然,这并不意味着 OpenRouter 已经变成了 AI 时代不可替代的“收费站”。

它最大的风险,恰恰来自自己创造出来的价值。一旦大家都意识到 Routing 很重要,模型公司、云平台、Agent 框架和大型企业都可以把这层能力自己做掉。OpenRouter CEO Alex Atallah 在 20VC 访谈里,也被直接问到 Routing Layer 最终会不会商品化、会不会被 Agent Framework 吞掉,这个问题至今没有答案。

OpenRouter 能够长期保持价值,还依赖几个并不确定的前提:多模型世界会长期存在;开发者仍然希望保持 Model-agnostic;OpenRouter 能够维持足够中立的市场地位;以及它积累的真实调用数据最终能够转化成比上下游自己做 Router 更好的效果。

所以我并不认为 Stripe 花 80 亿美元证明了“AI 模型已经不值钱”。真正的前沿模型依然决定着 AI 能力的上限,OpenAI、Anthropic、Google 这些公司的价值也不会因为 Router 出现而消失。

但 OpenRouter 至少让我们看到,AI 产业正在从只有一个价值中心,逐渐长出第二个价值中心。

过去最稀缺的是制造 Intelligence 的能力,谁能训练出更强的模型,谁就拥有最大的价值。可当市场上出现越来越多足够好的智能以后,如何选择、组合、计量和交易这些智能,也开始成为一门独立的大生意。

互联网早期也是如此。最初最重要的是把人和信息连接起来,等连接足够丰富之后,搜索、支付、广告、云计算这些基础设施和中间层也诞生了规模巨大的公司。AI 会不会重复同样的过程,现在还不能下结论。

但如果 Stripe 最终真的为 OpenRouter 支付超过 80 亿美元,它下注的显然不只是今天每月 200 万亿 Token 的流量,而是一个更长期的判断:

当智能越来越丰富、越来越便宜,真正稀缺的东西,可能会从“有没有智能”,逐渐变成“该在什么时候,用哪一种智能”。

这或许才是 OpenRouter 真正值钱的地方。

DeepSeek V4涨价后,为什么同样100万Token价格能差30倍?

8月17日,DeepSeek V4新的API价格正式生效。

这次调整最容易被注意到的,当然是涨价。但我仔细看了一遍新的价格表之后,觉得里面还有一个更值得讨论的数字。

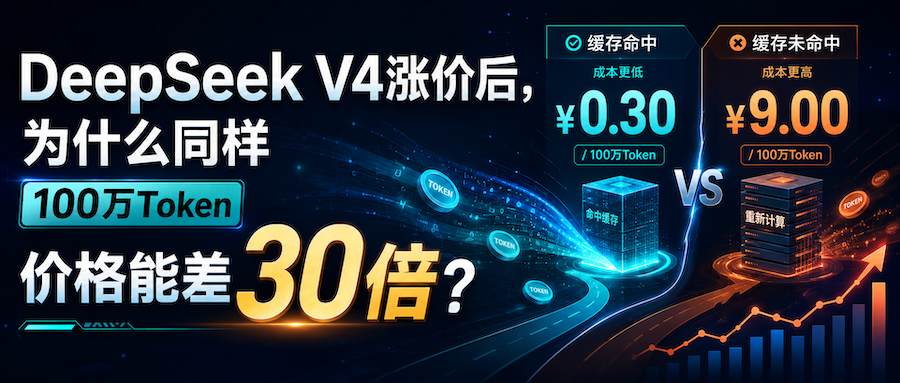
以DeepSeek V4 Pro为例,在高峰时段,100万输入Token如果没有命中缓存,价格是9元;如果命中缓存,只需要0.3元

同样100万Token,价格相差整整30倍

V4 Flash也是一样,缓存未命中是3元,命中只有0.1元。再加上DeepSeek这次新增的峰谷定价,闲时价格只有高峰的一半,那么V4 Pro的100万输入Token,最低可以是0.15元,最高却可以达到9元,极端情况下相差60倍。DeepSeek的新价格已经于北京时间2026年8月17日0时生效,高峰时段为9:00—12:00和14:00—18:00。

这件事其实挺有意思。

过去我们比较大模型价格,习惯问一句:这个模型100万Token多少钱?

但进入Agent时代之后,这个问题可能已经越来越没有意义。

因为真正决定你最后付多少钱的,不再只是用了多少Token,还有一个以前很少被普通用户关注的指标:

缓存命中率。

一、缓存命中,不是AI“记住了你”

先说什么叫缓存。

假设你把一份500页的公司资料交给一个员工,让他看完以后回答问题。

第一次,你问:“这家公司去年收入增长了多少?”

他需要从头把500页资料读一遍。

过了一会儿,你还是把完全相同的500页资料交给他,只是把最后的问题换成:“这家公司利润为什么下降?”

如果他又从第一页重新读到第500页,显然很浪费。

更合理的方法是:前面的资料刚刚已经处理过了,这次直接利用之前的结果,只处理新增加的问题。

大模型的上下文缓存,可以简单理解成在做类似的事情。

DeepSeek的上下文硬盘缓存默认对所有API用户开启。第一次请求以后,系统会把可以复用的Prompt前缀对应的计算状态保存下来;后面的请求如果完整匹配这些前缀,就不需要再从头完成相同的计算,而是从缓存中读取。

所以这里有一个很容易混淆的地方:

缓存命中,不等于AI记住了你的聊天记录。

它不是ChatGPT里的“记忆”功能,也不是模型突然知道了你上个月告诉它的事情。更准确地说,它是:

这部分内容我刚刚已经算过,不需要再算一遍。

二、为什么只是“不重新算”,价格就能差30倍?

因为我们看到的Token,只是计费单位,真正昂贵的是Token背后的计算。

一个长Prompt进入模型之后,模型首先需要处理整段输入上下文,这个过程通常被称为Prefill。如果你扔进去的是一份几十万Token的代码库、一份很长的财报,或者一个已经持续几十轮的Agent任务,这部分计算本身就不便宜。

如果前面几十万Token和上一轮完全相同,就没有必要重新处理一遍。

缓存真正省掉的,并不是Token本身,而是Token背后的重复计算

而且一次请求并不是简单地分成“命中缓存”和“没有命中缓存”两种状态。

例如一个Coding Agent当前的上下文已经有10万Token,下一轮又增加了2000 Token的新任务,那么这10.2万Token里面,可能有9万多Token命中缓存,只有新增或者发生变化的部分按照未命中价格计费。

DeepSeek甚至会在API返回结果里直接告诉开发者两个数字:

prompt_cache_hit_tokens

以及:

prompt_cache_miss_tokens

也就是说,缓存命中率本身已经变成一个可以被统计、被优化,最终直接影响账单的指标。

三、但缓存并不会永远存在

这里还有一个很容易被忽略的问题。

既然第一次算过以后可以复用,是不是以后一直都是缓存价格?

当然不是。

缓存都有生命周期,只是不同公司的做法差别非常大。

厂商主要缓存机制缓存有效期
DeepSeek V4自动硬盘缓存通常几小时到几天,系统自动清理,不保证命中
OpenAI GPT-5.6+Prompt Cache默认30分钟,每次复用重新刷新30分钟
ClaudePrompt Cache默认5分钟,可选择1小时
GeminiImplicit Cache内存缓存TTL为24小时
Gemini Explicit Cache显式缓存默认1小时,可由开发者自行设置

这张表看起来好像DeepSeek时间比较长,但实际上不能简单这么比较。

DeepSeek采用的是一种“尽力而为”的机制。官方明确说明,不保证100%命中;缓存不再使用以后会自动清理,时间通常是几个小时到几天。

OpenAI在GPT-5.6及以后的模型上采用了更明确的30分钟TTL,而且这是一个滑动窗口。比如10点建立缓存,10点20分再次命中,那么有效期就重新延长到10点50分。GPT-5.6之前的部分模型则采用5—10分钟的内存缓存,或者支持最长24小时的Extended Retention。

Claude默认只有5分钟,但每次命中以后也会刷新;如果任务间隔比较长,可以使用1小时缓存,不过创建1小时缓存的价格是普通输入的2倍。Claude的缓存读取则只有普通输入价格的10%。

Gemini又是另一种思路。2.5及更新模型默认开启Implicit Caching,Google披露其内存缓存TTL为24小时;此外还允许开发者主动创建Explicit Cache,默认保存1小时,并且可以自己设置TTL,保存时间越长,还要额外支付存储成本。

所以“缓存”虽然是同一个词,不同公司的产品设计其实并不完全相同。

四、为什么到了Agent时代,缓存突然重要了?

如果只是过去那种问ChatGPT一个问题、得到一个答案的使用方式,缓存并没有那么重要。

但Agent完全不同。

一个Coding Agent工作的时候,每执行一步,都可能重新带上System Prompt、工具定义、项目规则、AGENTS.md、之前读取过的代码、前面的对话以及工具执行结果。

任务运行到后面,一次请求的上下文可能已经有几十万Token,但真正新增加的内容只有最后几千Token。

这恰好就是缓存最擅长处理的场景:

前面绝大多数东西都一样,只有最后一小部分发生变化。

Anthropic最近在自己的Agent任务测试中发现,缓存命中率可以达到81%—90%,开启缓存之后,部分任务成本降低到原来的约1/2.5至1/3.7。Anthropic甚至把Prompt Caching称为Agent成本优化中优先级非常高的一项,因为一个40轮的Agent任务,会反复把早期上下文带入后续请求。

这也是为什么我觉得,DeepSeek这次价格调整真正值得关注的,并不是简单的“涨了多少钱”。

当V4 Pro缓存命中和未命中的输入价格能够相差30倍时,Agent是怎么管理上下文的,可能和模型本身卖多少钱一样重要。

五、Prompt怎么排列,现在都会直接影响你的账单

缓存还有一个非常重要的特点:

它通常要求前缀匹配

比如你的Prompt是:

公司资料 + 用户资料 + 今天的问题

第二次变成:

公司资料 + 用户资料 + 明天的问题

前面的固定内容很容易被复用。

但如果每一次都变成:

当前时间 + 随机Request ID + 公司资料 + 用户资料 + 问题

那么Prompt一开始就已经不同,后面的缓存复用就会受到影响。

所以DeepSeek和OpenAI都强调,把稳定、重复使用的内容放在前面,把经常变化的内容尽量放到后面。

这件事情其实很有意思。

以前我们研究Prompt Engineering,关心的是:

怎么写,AI回答得更好。

现在又多出了一个问题:

怎么排列,AI运行得更便宜。

Prompt已经不只是模型效果问题,也开始成为成本工程问题。

六、这也是为什么Harness越来越重要

我之前一直觉得,国产AI Coding现在一个很重要的短板,已经不是模型本身,而是Harness。

缓存这件事其实再次说明了这个问题。

一个好的Harness,不只是负责把问题交给模型、调用工具,然后把结果拿回来。它还要决定每一轮带多少上下文,什么时候压缩,什么内容应该长期保留,哪些内容能够稳定形成缓存前缀,以及一次任务到底需要循环多少轮。

这些设计最终都会落到Token和钱上。

以前我们比较两个模型,经常只看:

100万Token多少钱?

以后更值得比较的可能是:

完成同一个任务到底多少钱?

因为模型能力决定了这件事情能不能做成,而Harness越来越决定这件事情要调用多少次模型、重复计算多少上下文,以及最后到底花多少钱。

这也是Agent时代一个很容易被忽略的变化。

七、AI模型的价格,正在从一个数字变成一道公式

DeepSeek V4 Pro现在的输入价格到底是多少?

答案可以是:

0.15元、0.3元、4.5元,也可以是9元。

它们全部都对。

因为同样100万Token,最终价格取决于它是在高峰还是闲时调用,也取决于这部分Token到底有没有命中缓存。

所以以后再看到一家模型公司说“我们的API只需要多少元/百万Token”,其实已经不能完整反映真实成本了。

真正的成本越来越接近:

用了多少Token × 其中多少能够复用 × 调用了多少轮 × Harness怎样管理上下文。

DeepSeek这次把缓存命中和未命中的价格差拉到了30倍,只是让这个原本藏在API账单里的问题,突然变得非常醒目。

大模型进入Agent时代以后,我们可能也需要重新理解“模型价格”这四个字。

模型多少钱是一回事,怎么使用模型,是另一回事。

Claude开始给文字加“隐形水印”,它写的代码也有吗?

这两天,Anthropic公布了一项很容易被忽略、但可能影响所有Claude用户的变化:Claude开始引入文本数字水印。更准确地说,Anthropic在8月14日宣布,未来Claude模型生成的文本将带有水印,旧模型则会在未来几个月逐步加入。直接原因是欧盟《AI Act》第50条已经从8月2日起适用,要求生成式AI提供商为AI生成或修改的内容加入机器可读标记;Anthropic决定在推出时全球应用。

看到“数字水印”,很多人的第一反应,大概是Claude会不会偷偷往文字里塞一些看不见的字符。但对我来说,更有意思的是另一个问题:Claude生成的代码也有水印吗?现在大量开发者已经把Claude Code直接放进真实的软件开发流程。如果代码也带着Claude的“指纹”,会不会影响代码质量,提交到GitHub以后,别人又能不能反查出是谁生成的?

答案是:Claude生成的代码也处在这套水印机制之下,但代码里的水印通常比自然语言少得多。理解为什么,其实也就理解了SynthID-Text到底是什么。

一、Claude的水印,不在文字里,而在“为什么选这个词”里

Anthropic没有重新发明一套水印,而是明确采用Google DeepMind在2024年发表的SynthID-Text方法的一个版本。它不会在文本里插入零宽字符,不增加额外Token,也不是等Claude写完以后,再在里面附上一串隐藏编号;水印发生在模型生成文字的过程里。

大语言模型写一句话,本质上是在不停预测下一个Token。比如Claude已经写出“今天的天空有些……”,后面接“阴沉”“灰暗”“多云”可能都说得通。正常生成时,模型会按照这些Token的概率进行采样;SynthID-Text做的事情,是在几个答案都合理的时候,改变这种随机选择的来源。Anthropic用了一个很形象的比喻:平时玩棋盘游戏靠掷骰子决定走几步,加入水印以后,不再真的掷骰子,而是从圆周率的小数位里依次取数字。对玩家来说仍然像随机数,不影响游戏,但如果事后拿到足够长的一串结果,又知道这套规则,就可能判断这局游戏是不是用了圆周率。Claude的文本也是一样,单独看一个词没有意义,但大量选择积累在一起,就可能形成只有掌握密钥才能检测的统计规律。

这套方法最巧妙的地方,是尽量不改变用户看到的结果。Google DeepMind曾在真实Gemini流量中比较约2000万条带水印和不带水印的回复,点赞率只差0.01%,点踩率差0.02%,差异都没有统计显著性。至少从这项大规模实验看,用户基本感受不到背后的那颗“骰子”被换了。

二、Claude写的代码也有水印,但代码恰恰最难留下水印

这是Anthropic在官方说明中专门回答的问题。SynthID-Text能够工作的前提,是Claude拥有“怎么选都差不多”的空间;如果只有一个明显正确的答案,水印不能为了留下痕迹而故意把答案改掉。比如“2+2=”后面正常答案就是4,代码更是如此:if不能为了留下水印换成不存在的关键字,固定API名称不能随便改,函数参数或者协议字段也不能因为水印而破坏程序。Anthropic明确表示,当替换Token会造成事实错误或者让代码出错时,水印不会施加这种影响。

所以Claude生成的代码不是完全没有水印,而是通常比文章、邮件、故事这些自然语言包含更少的水印信号。真正有发挥空间的地方,例如代码注释,或者某些有多个同样合理表达方式的位置,仍然可能留下水印;但Anthropic认为这种机制对实际生成代码的影响可以忽略。 这其实揭示了SynthID-Text最重要的特点:它不是为了加水印而改变内容,而是在Claude本来就有多个合理选择的时候,顺便利用这些选择留下统计信号,没有选择就不强行留下。

从这个角度再看不同场景就很好理解了。写长文章时,每句话都有大量可以换一种说法的地方,水印容易累积;Claude翻译文章时,输出仍由Claude重新选择,因此Anthropic明确说翻译文本也会带水印;但如果只让它改几个错别字和标点,大部分文字并不是Claude重新生成的,最后可能少到无法可靠检测。事实性回答和代码也是同样的道理:越接近“只能这么写”,水印留下的空间就越小。

对于Claude Code用户,这个结论其实很重要:即使一段代码完全由Claude生成,也不意味着它一定能像一篇长文章那样被稳定识别出来。

三、有水印,也不等于能证明“这是Claude写的”

SynthID-Text和传统AI检测器还有一个根本区别。很多AI检测工具是在文章生成以后,根据句式、词频和语言习惯去猜“像不像AI写的”;SynthID-Text则是模型在生成时主动留下一个只有相应密钥才能验证的统计信号。

但主动留下信号,也不代表它能给一篇文章或者一段代码盖上“Claude原创”的章。Anthropic明确表示,水印最多只能帮助判断Claude是否可能参与过内容生成,不能区分“Claude从头写”和“人写完后让Claude大幅改写”。它也不包含用户、组织或具体聊天的信息,不能通过水印反查是谁生成的,更不能还原Prompt,也不会改变内容所有权。

水印同样不是不可破坏的。轻度编辑通常不会完全消除它,但如果整篇文字彻底重写,水印会消失;Google DeepMind也一直强调,SynthID不是识别AI内容的万能方案。 对代码来说,这个限制更加明显:代码本来就比文章更缺少自由选择,再经过开发者重构、格式化、替换实现以及与其他代码合并之后,想单凭水印准确回答“这段代码是不是Claude Code写的”,会更加困难。

四、真正改变的,不是我们怎么用Claude,而是内容离开Claude之后会发生什么

从普通用户的角度,这次变化几乎是无感的。Anthropic表示,水印不会增加Token,价格不变,对生成速度的影响也可以忽略;Claude Code用户没有必要为了水印改变开发流程,更不用担心Claude为了“留指纹”故意生成另一套更差的代码。

真正值得关注的,是这些内容离开Claude之后。欧盟《AI Act》已经要求生成式AI提供商加入机器可读标记,Anthropic也表示将提供自己的水印检测API。未来学校、媒体、企业或者内容平台,至少从技术上多了一种不同于传统AI Detector的判断方式:不是根据语言风格去猜,而是检查模型在生成时主动留下的信号。

但这里仍然有一道重要边界。检测到Claude参与,不等于证明一篇文章没有人的原创思考;检测到一段代码里存在Claude水印,也不能证明整个软件都是AI写的。一个人自己确定观点、结构和事实,只让Claude润色,与让Claude从头生成文章,在创作责任上显然不是一回事,但水印无法替我们完成这种判断。

过去几年,我们一直在讨论AI能生成什么:文章、图片、视频、代码,越来越像人,也越来越难单纯从结果上区分。现在行业开始补另一层基础设施——这些内容从哪里来,AI到底有没有参与。SynthID-Text远远谈不上解决AI内容识别问题,尤其对代码这种高度受约束的内容更是如此,但Claude开始采用它,还是意味着一个值得关注的变化:AI生成内容开始拥有一种以前纯文本并不具备的“来源信号”。

所以,Claude写的代码有数字水印吗?更准确的答案是:有留下水印的机制,但很多代码能够承载的水印很少,远没有一篇长文章那么容易检测。对于开发者来说,它今天几乎不会改变写代码这件事;但对整个互联网来说,“这段内容有没有AI参与”,正在慢慢从根据文风和感觉的猜测,变成一个可以由生成模型自己提供线索的技术问题。