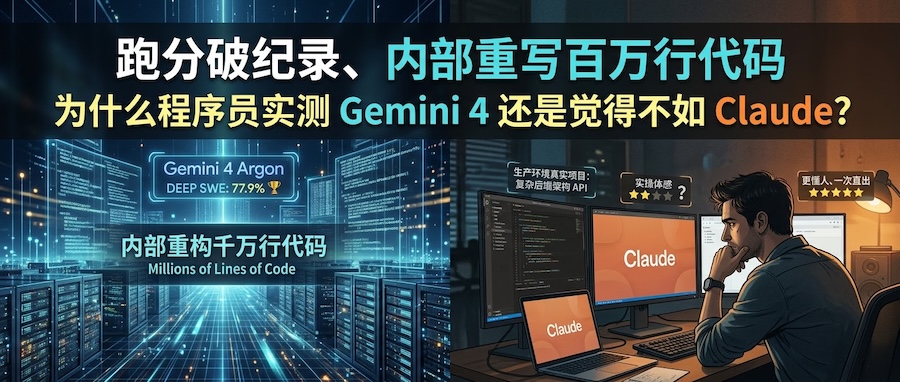
跑分破纪录、内部重写百万行代码,为什么程序员实测 Gemini 4 还是觉得不如 Claude?
Gemini 4 Argon跑分登顶,实测单次编码却逊于Claude。这源于路线分化:后者胜在单次直出精度,而百万输出、低价缓存的前者专为多轮验证流水线打造。建议用Claude攻坚复杂架构,让文风清爽的Argon接管长文档与日常工作。
AI 有没有意识还没定论,Anthropic 为什么先限制虐待它?
Anthropic 将持续且无必要的模型虐待写入新版使用政策,AI 意识仍无定论。沿着模型福利研究、退出对话功能到用户规则的路径,分析有限预防的理由、证据局限及用户需要关注的执行边界。
看完Anthropic那份154页威胁情报报告,Claude你还敢用吗?
Anthropic最新报告让我重新审视Claude Code:它获得的权限越多,用户暴露给云端模型的数据边界就越大,而Anthropic也具备调查真实用户行为的能力。随着开放权重模型和Harness工具成熟,我会逐渐减少Claude使用,敏感项目更不会再交给它。
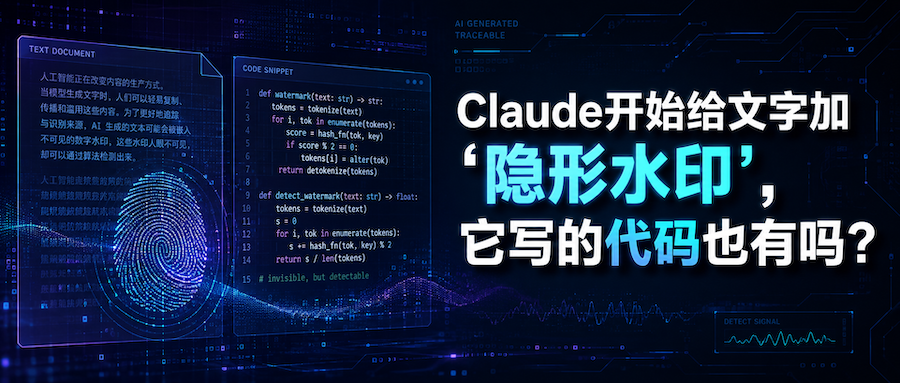
Claude开始给文字加“隐形水印”,它写的代码也有吗?
Anthropic开始为Claude引入基于SynthID-Text的隐形水印。它不藏字符,而是在生成时留下统计“指纹”。文章、翻译更容易检测,代码因选择空间更小,水印通常更弱。对用户几乎无感,但AI参与内容开始变得更可追溯。

Kimi、GLM和Claude的差距,为什么每个人感受完全不同?
Kimi、GLM与Claude的能力差距真实存在,但不会平均体现在所有任务中。任务越模糊、链条越长、越依赖模型自主判断,Claude优势越明显;任务拆解越充分、Agent与人工控制越成熟,国产模型的实际差距就越容易缩小。

Claude Opus 5发布,但为什么Anthropic越来越招人厌了
Claude Opus 5依然强大,但Anthropic限制第三方工具、封号与客服问题,暴露出更深层的自我正确性:它相信自己最理解AI风险,也最适合掌握权力。当闭源与开放权重模型追上,用户终将因失去信任而离开。

这次真不慌了,Claude随时可以取消订阅
过去一年,Claude大概是AI Coding领域存在感最强的名字之一。 Claude 3.7之后,Claud […]

Kimi卖爆之后,我发现AI可能不是一门互联网生意
Kimi K3发布之后,市场反响非常热烈,发布仅几天,Kimi就宣布暂时暂停新用户订阅,原因是过去48小时的需 […]

最强的模型,不一定能赢:AI Coding开始拼“好用”了
最近几天,AI Coding领域最热闹的事情,除了GPT-5.6发布,就是OpenAI不断为Codex和Cha […]