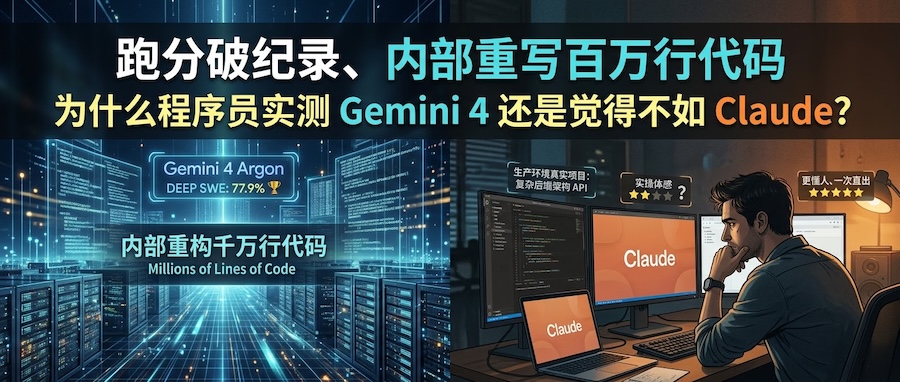
跑分破纪录、内部重写百万行代码,为什么程序员实测 Gemini 4 还是觉得不如 Claude?
Gemini 4 Argon跑分登顶,实测单次编码却逊于Claude。这源于路线分化:后者胜在单次直出精度,而百万输出、低价缓存的前者专为多轮验证流水线打造。建议用Claude攻坚复杂架构,让文风清爽的Argon接管长文档与日常工作。
中美AI竞争真正的胜负手,不是谁的模型更强,而是谁先让AI研究AI
中美AI竞争正在从模型能力转向研发速度。AI已开始参与下一代AI的研发,但完整RSI尚未实现。真正的胜负,不只是谁先让AI研究AI,更是谁能把这种技术加速度转化为产业生产率和经济增长。
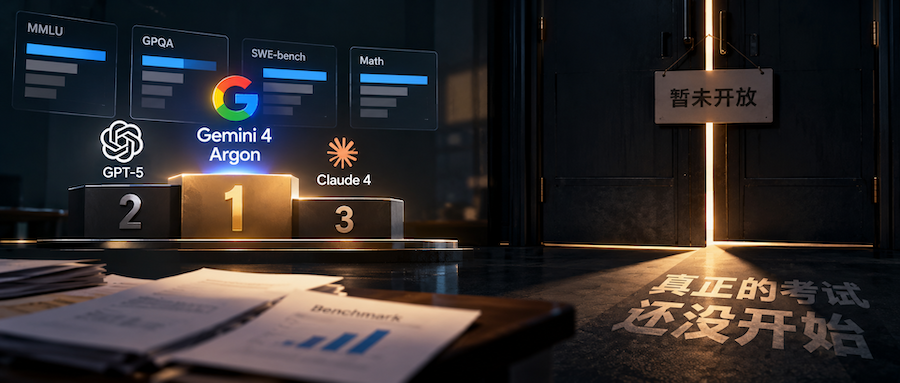
Gemini 4 Argon已经开始赢跑分了,但真正的考试还没开始
Gemini 4 Argon在多项Benchmark中进入第一梯队,却尚未向普通用户开放。Google称这是出于安全考虑,但在GPT和Claude密集更新的竞争压力下,这种“先发布、后开放”的方式也值得关注。跑分已经赢了一部分,真正的考试仍要等到真实用户手里。

Google发现卖铲子比自己挖金矿更赚钱之后,DeepMind怎么办?
Google Cloud高速增长,让Google即使不靠Gemini长期保持第一,也能从AI浪潮中赚到钱。但相比模型排名和云收入,DeepMind更重要的价值或许是AlphaFold这样的长期科学突破。Google可以卖好“铲子”,但仍应给DeepMind留下人才、算力和时间,继续解决疾病与基础科学问题。

谢尔盖·布林重新回到Google AI权力中心,DeepMind为什么必须退半步?
Google重组AI权力结构,布林重新回到核心,Koray负责加速Gemini产品竞争,Demis则转向长期科学研究。这不是DeepMind的失败,而是Google试图同时解决两种时间尺度的问题:既要赢下今天的AI竞争,也不能失去面向未来的研究能力。

DeepSeek V4 Flash只差GPT-5.6 Luna 1分,价格却低了一大截,AI模型开始争夺“用得最多”
DeepSeek V4 Flash以接近主流闭源模型的能力和更低价格,切入Agent执行层。它未必是最强模型,却可能凭借低成本、开放权重和高频调用,成为AI时代用得最多的模型之一。

AI模型开始不拼最强了,Google正在把竞争拉回成本和规模
Gemini 3.6 Flash延续了速度快、成本低、Token消耗少的优势。进入Agent时代,模型竞争正从“谁最强”转向效率与规模:最强模型决定AI上限,而足够聪明、更快、更便宜的模型,可能真正决定市场规模。