标签: Google

错失 ChatGPT 的前夜:Google 为什么亲手杀死了自己的 LMChat?

我最近看了前 DeepMind 工程师、后来加入 OpenAI 的 Thibault Sottiaux(Tibo)的一次访谈。里面有一段关于 LMChat 的回忆,我觉得比很多关于 Google“为什么错失 ChatGPT”的分析都更有意思。

大约在 ChatGPT 发布前一年,DeepMind 的语言模型团队已经做出了不错的效果。团队很自然地想到:能不能把它做成一个可以直接聊天的东西?于是有了内部的 LMChat,而且一度希望把它变成面向公众的产品。

Tibo 回忆,LMChat 最开始“好笑多过有用”,但后来逐渐变得越来越有帮助。

Tibo 说,当时的 DeepMind“并不是一个为交付产品而设计的组织”。他此前还公开提到,Google 对发布 LMChat“过于紧张”,而 DeepMind 也受到限制,不能轻易推出可能颠覆 Google 现有业务的产品。

今天回头看,很容易说:如果 Google 当年把 LMChat 推出去,ChatGPT 的历史可能就会改写。但我觉得真正值得讨论的,不是“Google 为什么这么蠢”。恰恰相反,很多决定从一家成熟公司的角度看都很合理,问题也正在这里。

Google 不是没有看到,而是很难把它变成产品

关于 Google 错失生成式 AI,最常见的说法是:Google 有 Transformer、有最好的 AI 科学家、有 TPU,却没有意识到大语言模型的重要性。

LMChat 的存在恰好说明,这个解释并不成立。

DeepMind 不仅看到了语言模型的潜力,而且已经做出了可以聊天的内部原型。Google 缺的不是发现趋势的能力,而是从研究原型走到消费产品的那一段。

当时的 DeepMind 是一个非常有创造力的研究组织,但并不是围绕消费产品交付建立起来的。研究团队可以把模型能力做出来,但要把它真正交给几亿用户,中间还有产品、安全、基础设施、品牌和商业模式等一整套问题。

DeepMind 也并非完全不做产品化,但更多是把研究能力带进 Google 已有产品,而不是自己从零做一个直接面向用户的新入口。

LMChat 麻烦的地方就在于,它不是给 Search 增加一个功能。

它本身就是另一种获取信息的入口。

一旦要公开 LMChat,问题马上变成:它和 Search 是什么关系?谁为错误回答负责?广告怎么办?这些问题每一个都合理,但叠在一起,一个新产品就很容易永远停留在内部。

Google 最难回答的问题,其实是搜索

我觉得 LMChat 真正撞上的,是 Google 最难处理的一类创新:它不是帮助原有业务做得更好,而是可能改变原有业务为什么存在。

2021 年 Alphabet 全年营收约 2576 亿美元,其中 Google Search & other 接近 1490 亿美元,占总营收约 58%;整个 Google 广告业务约 2095 亿美元,占总营收超过八成。

传统搜索的商业模式已经运行二十多年:用户提出问题,Google 返回结果,用户点击链接,在这个过程中完成广告变现。

而聊天式 AI 的逻辑正好相反:用户提出问题,AI 尽量直接给出答案。

如果答案已经在对话框里完成了,用户为什么还要点击十个蓝色链接?

更麻烦的是,当时大语言模型的推理成本远高于一次传统搜索请求。于是从财务模型看,这是一笔很别扭的账:Google 要用一个成本更高、商业模式还不清晰的新产品,去影响自己已经非常成熟的搜索广告业务。

我们今天当然可以说,公司应该勇于自我颠覆。但真正坐在那个位置上,没有这么简单。

Search 部门很难主动支持一个可能减少搜索点击的产品;财务部门也很难为一个成本更高、短期没有成熟收入模式的新业务给出漂亮的 ROI。所以我更愿意把它理解为结构性矛盾,而不是保守或者愚蠢。

越成功的业务,越难被自己颠覆。

这也是《创新者的窘境》最重要的那类问题:很多优秀公司失败,不是因为管理太差,而是因为它们太擅长围绕现有客户、利润和投资回报做出“正确决策”。

LMChat 恰好撞上了 Google 最成功的那套正确决策。

OpenAI 真正不同的,是先把东西交给用户

再看 OpenAI,情况完全不同。

2022 年 11 月 ChatGPT 上线时,远远谈不上完美。OpenAI 在发布公告里就承认,它会生成听起来合理但实际错误的回答,也会受到提问方式影响。它没有把 ChatGPT 当成完成品,而是明确称为一次 research preview,希望通过真实用户了解模型的优势和弱点。

区别不在于 OpenAI 不在乎风险,而是它更愿意先把一个“不完整但已经有价值”的东西交给用户,再从真实反馈中继续迭代。

Tibo 在访谈里用了两个词。

一个是 Bias to Ship,偏向交付。

另一个是 Stop Energy

他并不是说 Google 当年内部有一个叫“Stop Energy”的机制,而是在形容 OpenAI 的文化:新产品想法出来之后,团队可以很快做出来、发布出去,内部对新想法的阻力很小。研究团队和产品团队也会一起构思、一起设计。

这背后的差别,不是谁更聪明,而是谁更容易形成真实用户的反馈闭环。

Benchmark 能告诉你模型在一道题上得多少分,却很难告诉你普通用户到底会拿它来做什么。ChatGPT 上线以后,用户开始用它写邮件、改代码、总结资料,也不断暴露之前没有被发现的问题。

这些使用行为不会让模型自动实时学习,但会影响后续的评测、训练、对齐和产品设计。

我觉得这才是 ChatGPT 当年最重要的意义:它不只是发布了一个模型,而是让大语言模型真正进入了用户反馈循环。

Google 有 LMChat,却没有走完这一步。

Google 错过的,其实不是 AI

如果只看后来的结果,很容易把这个故事讲成“Google 发明了一切,最后什么也没得到”。这也不准确。

Google 并没有因为错失 ChatGPT 就退出 AI 竞争。后来 Google 合并 Brain 和 DeepMind,Gemini 也重新回到了前沿模型竞争的中心。

所以 Google 真正错过的,并不是 AI 本身。

它错过的是定义第一代生成式 AI 大众产品的机会

技术领先可以追回来,Benchmark 也可以反超,但用户第一次建立起“AI 就应该这样用”的认知,往往只有一次。

ChatGPT 出现之后,很多人第一次意识到,获取信息不一定非要先搜索网页,也可以直接和 AI 对话。

这个产品认知原本有机会由 Google 建立,最后却被 OpenAI 抢先完成了。

它提醒所有已经成功的公司:真正困难的从来不是看见下一代技术,而是在下一代技术开始威胁今天的成功时,你还愿不愿意把它交给用户。

而这件事对 OpenAI 同样成立。

今天的 OpenAI 已经有 ChatGPT、有企业客户、有 API、有开发者生态,也开始拥有不能轻易被打破的东西。

当一家公司开始拥有自己的“搜索广告业务”——不一定真的是广告,而是任何必须保护的核心收入和产品——Stop Energy 就会自然出现。

所以 LMChat 的故事并没有结束。

Google 当年回答错的那道题,迟早也会摆到每一家成功的 AI 公司面前:

当下一代产品开始威胁今天最赚钱、最成功的产品时,你还敢不敢把它做出来?
Jeff Dean离开Google后首次公开访谈:AI真正值得自动化的,可能不是工作

8月7日,Jeff Dean参加了斯坦福AASF 2026的一场Fireside Chat,这是他正式离开Google之后的第一次公开访谈。就在前一天,他结束了自己在Google长达27年的工作,与Sanjay Ghemawat、Quoc Le和Oriol Vinyals一起创办了Discovery Loop。

Jeff Dean在Google的地位比较特殊。从Google早期的MapReduce、BigTable等分布式计算基础设施,到后来Google Brain、TensorFlow、TPU,再到Gemini,他几乎参与了Google过去二十多年最重要的几次技术变化。所以他在这个时间选择离开Google,自然是这次访谈最受关注的问题。

Jeff Dean对此倒没有给出一个很戏剧性的解释。他仍然看好Google和Gemini,也没有把离职描述成与Google之间存在什么路线分歧。他认为现在云计算已经让小公司也可以获得过去只有大公司才能拥有的计算资源,而一个十个人左右的小团队,可以把所有精力都集中在同一个问题上。Google最终也成为Discovery Loop的投资者和Cloud合作伙伴,并为其第一年提供计算资源。

不过整场访谈看下来,我反而对Discovery Loop想做的事情更感兴趣。

这家公司想解决的问题是:能不能用AI把科学研究中的实验过程自动化。

从自动化工作,到自动化实验

过去几年,AI商业化最主要的方向,都是提高已有工作的效率。

Coding Agent帮助程序员写代码,客服Agent回答用户问题,Sales Agent寻找客户,Research Agent查找资料,现在Computer Use又开始直接操作浏览器和各种软件。

这些产品为什么容易找到商业价值,其实很好理解。原来一个任务需要10个人,现在5个人就能完成;过去需要一天的工作,现在一个小时做完。企业很容易计算用了AI以后节省了多少成本,所以这也是目前AI最容易形成商业闭环的地方。

我自己平时开发软件已经大量使用AI Coding,所以对于这部分价值,我没有什么怀疑。现在很多软件开发工作已经可以让AI完成,而且随着Coding Agent能力继续提高,这个比例还会越来越高。

但Discovery Loop考虑的是另外一种可能。

科学研究同样存在大量重复工作。一个研究人员提出一个假设,然后需要设计实验、写代码、运行实验、观察结果,再根据结果决定下一步做什么。Discovery Loop认为,现在很多科学研究的瓶颈,就在于这些实验仍然主要依靠人一个接一个地完成,速度很慢,也很难大规模并行。

他们希望利用前沿AI模型和大规模计算基础设施,把这整个实验循环自动化,让AI可以提出实验、执行实验、分析结果,再根据结果继续下一轮,并且同时运行数千个实验。

如果只是把这些事情理解成“AI帮助科学家提高工作效率”,其实和Coding Agent也没有太大区别。

但当实验数量可以从一个人一天做几个,变成AI同时做几千个以后,变化可能就不只是效率提高了。

很多以前根本没有时间尝试的方向,现在可以尝试;很多因为搜索空间太大而不得不依靠经验提前放弃的方案,也可以真正跑一遍看看结果。

这也是我觉得Discovery Loop比较有意思的地方。

过去十几年,我们一直在Scale Intelligence

如果把2012年以来这一轮AI的发展简单概括一下,我觉得大致可以理解为:

Scaling Compute → Scaling Models → Scaling Intelligence

这当然不是一个严格的技术发展阶段,只是方便理解过去十几年AI行业到底在做什么。

从GPU开始,到后来Google的TPU,再到今天动辄几十万张GPU的数据中心,整个行业一直在投入更多计算资源。更大的算力让我们能够训练更大的模型,而模型能力又随着架构、数据和训练方法的改进不断提升,最终才有了今天的大语言模型。

Jeff Dean在这次访谈里回忆,当年Google做语音识别时,他们把神经网络扩大大约50倍,一次实验带来的性能提升,就可以和这个领域过去几年积累的进步相比。这也是为什么后来Google非常重视Scaling。

当然,大模型能力提升并不只是因为模型变大。Transformer、Mixture of Experts、数据质量、后训练、强化学习等都发挥了重要作用。但从产业投入的角度看,过去十几年确实有一条非常明显的主线:不断把更多Compute转换成更多Intelligence。

现在这件事情已经发展到了一个比较有意思的阶段。

模型已经可以写代码、推理、调用工具,也开始能够连续工作几个小时。虽然距离真正可靠的自主Agent还有不少问题,但至少我们已经拥有了过去很难想象的大量“机器智能”。

所以接下来有一个问题就变得越来越重要:

这些已经获得的Intelligence,最终可以用来做什么?

Discovery Loop给出的答案,是继续把它转换成更多实验。

Scaling Experiments

Discovery Loop准备先从机器学习研究开始,而且首先拿自己做实验。

比如研究一个新的模型架构,过去研究人员需要先想方案,再修改代码、训练模型、跑Benchmark,然后根据结果决定下一步。如果一个方案效果不好,再换一个方向继续尝试。

这个过程很适合AI,因为结果相对容易验证。

AI完全可以同时提出大量架构或者训练方案,自动生成代码,调用计算资源进行训练,然后根据Benchmark结果选择下一轮更值得投入的方向。

WIRED在采访Discovery Loop四位创始人时,Quoc Le甚至提到,这样的系统未来也许能够找到一种不同于Transformer的新架构。公司计划先通过自动化机器学习研究来改进自己的AI能力,然后再把同样的方法扩展到芯片设计、生物、药物和材料等领域。

所以如果沿着过去十几年Scaling的逻辑继续往下看,我觉得可能会出现另外一条链路:

Scaling Intelligence → Scaling Experiments → Scaling Discovery

以前增加更多算力,主要是为了得到一个能力更强的模型。

如果Discovery Loop这条路能够成立,以后同样的算力还可以被用来同时探索成千上万个不同的假设。

这时候被放大的,就不只是模型的能力,还包括人类探索未知问题的速度。

我觉得这可能是AI接下来一个很值得关注的方向。

为什么科学研究很适合Agent

这也让我重新思考了现在大家都在做的AI Agent。

目前绝大部分Agent,本质上还是人先给出一个目标,然后AI完成执行。让它写一个程序、查一份资料、分析一张表格,或者帮你订一张机票,目标通常都是人定义好的。

科学研究会更进一步,因为实验做完以后,还需要根据结果决定下一步做什么。

一个方案失败了,是继续修改,还是换一个方向?一个异常结果是噪声,还是值得继续研究?有限的计算资源应该分配到哪些实验上?

这实际上形成了一个完整的反馈循环:

提出假设 → 实验 → 得到结果 → 再提出新的假设。

Coding Agent现在之所以发展得比较快,也和这个特点有关。程序写完以后,可以编译,可以运行测试,有非常明确的外部反馈告诉AI刚才做得对不对。

科学实验当然复杂得多,但如果一个研究领域同样能够提供比较清楚的反馈,它就很适合形成这样的Agent Loop。

Discovery Loop在官网上也专门强调,他们目前关注的是具有“可衡量结果”的Learning Loop。

这个限定其实很重要。

科学发现没有那么容易自动化

机器学习研究是比较理想的场景,因为很多实验只需要计算资源,结果也可以通过Benchmark快速验证。

但到了药物、生命科学或者材料研究,情况会复杂很多。

很多实验需要真实的实验设备,一次实验可能需要几天甚至几个月,结果也会受到大量现实因素影响。AI可以在一个小时里产生一万个药物分子,但这并不意味着现实中的实验室可以在一个小时里完成一万次验证。

所以我并不认为,只要模型再强一点、GPU再多一点,就可以把整个科学研究自动化。

另外还有一个我觉得更重要的问题。

如果未来AI真的能够非常便宜地产生大量假设和实验方案,那么真正稀缺的能力可能会继续往上移动。

什么问题值得研究?为什么这个结果值得关注?哪个看起来失败的实验其实隐藏着新的方向?一个结果到底只是统计意义上的提升,还是具有真正的科学价值?

这些问题未必能简单通过增加实验数量解决。

所以未来科学家的工作可能会发生变化,但很难简单理解为“AI把科学家替代了”。实验执行成本下降以后,问题定义、方向选择和判断的重要性反而可能进一步提高。

AI可以创造的价值,也许还有另外一种

过去几年,我们讨论AI对经济和就业的影响,经常会落到一个问题上:它最终能够替代多少工作?

这个问题当然很重要,因为企业现在投入AI,很大一部分目的就是提高生产率、降低成本。这也是AI能够快速商业化的基础。

但如果把时间拉得更长一点,我还是觉得,AI能够产生的价值不应该只用“减少多少人”来衡量。

过去100个人完成的工作,现在20个人完成,是很大的生产率进步。

但如果AI能够帮助科学家找到过去找不到的新药,设计过去无法设计的材料,或者让一个过去需要十年才能探索的问题,在更短的时间里找到答案,它产生的是另外一种价值。

后者并不一定比前者更容易实现,甚至可能困难得多。但从人工智能这项技术最终能够给人类带来什么来看,我还是更期待这样的应用。

Jeff Dean过去二十多年参与做的事情,很大程度上是在解决怎样把更多Compute变成更多Intelligence。从分布式计算、TPU、TensorFlow,一直到今天的大模型,都可以放在这条线上理解。

现在离开Google以后,他选择继续往后走一步,尝试把已经得到的Intelligence转换成更多Experiment,再看看这些Experiment最终能不能转换成更多Discovery。

这件事情最后能做到什么程度,目前还不知道。Discovery Loop也才刚刚成立,很多愿景距离真正落地还有很远。

但相比AI还能替我们完成多少已有的工作,我觉得这个问题确实更值得期待:

当我们已经拥有越来越多机器智能以后,能不能用它去解决一些过去人类没有能力解决的问题?

如果可以,AI下一阶段值得Scale的东西,就不只有模型和算力了。

科学发现本身,也可能成为Scaling的一部分。

AI是真的,泡沫也可能是真的:诺奖得主为什么不相信硅谷的叙事

过去几年,如果只看AI模型能力的进步,很容易相信我们正站在一场新工业革命的起点。

从ChatGPT出现,到今天AI可以写代码、制作视频、完成研究、调用工具,甚至独立执行越来越复杂的任务,技术进步几乎肉眼可见。与此同时,OpenAI、Anthropic、Google等公司不断把未来指向AGI,科技巨头投入AI基础设施的资金也从几百亿美元迅速增长到数千亿美元。Google DeepMind CEO Demis Hassabis甚至形容,AI带来的变化可能比工业革命大10倍、快10倍。

但如果AI真的正在以这样的速度改变世界,我们应该已经开始在经济数据里看到些什么。

2024年诺贝尔经济学奖得主、MIT教授达龙·阿西莫格鲁(Daron Acemoglu)对此相当谨慎。在论文《The Simple Macroeconomics of AI》中,他估算未来十年AI带来的全要素生产率增长累计可能只有0.53%—0.66%左右,GDP累计增长在不同假设下约为0.93%—1.56%。

这并不是说AI没有价值。真正的问题是:技术能力的快速提升,并不会自动变成同等规模的经济价值。

一、AI效率提高了,为什么生产率没有起飞?

过去需要一个小时整理的信息,现在可能十分钟完成;一些程序员一天才能完成的工作,现在几个小时就可以交付。类似体验越来越普遍,很容易让人产生一种感觉:AI生产率革命已经发生了。

但阿西莫格鲁认为,从个人效率提升推导到整个经济的生产率爆发,中间还有很长的距离。

今天AI最擅长的,往往是任务边界清楚、结果容易验证、训练数据丰富的工作。一封邮件写得好不好、一段代码能不能运行、一份文档能不能总结,都比较容易判断。但真实经济中的大量高价值工作并非如此。医生处理复杂病例、工程师解决现场故障、管理者判断一个项目是否继续,都包含大量环境信息、隐性知识和责任判断。

即使AI技术上能够完成其中一部分,企业还要考虑数据准备、系统集成、监督以及错误成本。因此,“某项工作快了三倍”和“整个公司生产率提高三倍”从来不是一回事。

按照阿西莫格鲁的估计,目前真正具有经济意义、能够有利可图地实现AI自动化的任务,大约只有整体任务的5%。这个数字未来当然可能继续提高,但至少说明,今天许多宏观预测实际上隐含了一个很强的前提:AI必须很快进入大量现实世界中的复杂任务。

如果这个前提没有兑现,AI依然会是一项非常重要的技术,只是经济价值兑现的速度,可能没有资本市场想象得那么快。

二、工业革命真正的教训,不是“最后大家都会受益”

硅谷很喜欢把AI比作工业革命,这个类比并没有错。但我们今天回望工业革命,往往只看到结局:蒸汽机、铁路和机械化最终大幅提高生产率,人类生活水平也远高于两百年前。

容易被忽略的是,这个过程并没有迅速惠及所有人。

经济史上有一个著名的“恩格斯暂停”(Engels’ Pause):工业革命早期,英国劳动生产率已经明显提高,但普通工人的实际工资在几十年间增长非常缓慢。机器提高了产出,并不意味着技术收益会自动流向劳动者。

后来随着资本积累、劳动力市场变化,以及工会、劳动立法和公共制度逐渐完善,生产率提升才越来越广泛地转化为生活水平改善。

这段历史对今天AI真正有意义的启示,不是“机器以前也抢过工作,所以不用担心”,而是:技术能够创造多少财富,与这些财富最后由谁获得,是两个不同的问题。

阿西莫格鲁尤其担心,今天AI的发展越来越集中于Automation,也就是用机器完成原本由人完成的工作。自动化当然能够降低成本,也能够提高生产率,但如果创新主要围绕“如何用更少的人完成同样的事情”,企业得到的主要是成本下降,而不是新的产品、服务和需求。

今年他与David Autor、Simon Johnson提出“Pro-worker AI”,强调另一条技术路线:AI不仅替代已有任务,更应该让普通人获得过去只有专家才能拥有的能力,并创造新的工作和任务。

这也是过去真正重要的通用技术产生巨大经济价值的方式。汽车最大的价值不是让马车夫效率更高,而是创造了制造、维修、公路、物流等整个产业;互联网最大的价值也不是让人写信更快,而是后来出现了搜索、电商、云计算和移动支付。

如果AI最后最大的用途只是“让五个人完成过去十个人的工作”,它当然仍然有价值,但可能远远没有发挥这项技术真正的潜力。

三、GPU不是光纤,AI泡沫和互联网泡沫并不完全一样

对于今天巨大的AI资本投入,一个常见的辩护是互联网泡沫。

2000年前后,大量公司同样疯狂投资网络基础设施,电信企业铺设了远超当时需求的光纤。泡沫最终破裂,无数公司倒闭,但互联网没有失败。相反,当年留下的一部分基础设施后来继续被使用,最终支撑了搜索、电商、视频和云计算的发展。

于是有人认为,即使今天AI也存在投资泡沫,只要技术方向是对的,现在多建设一些数据中心、多购买一些GPU,未来迟早都会用上。

阿西莫格鲁在访谈里提醒了一个很容易被忽略的问题:GPU不是光纤。

当年埋到地下的光纤,即使建设它的公司破产,仍然可以使用很多年。但GPU属于另一类资产,它不仅存在物理折旧,还有非常明显的技术折旧。新一代芯片性能更高、功耗更低,同样完成一次训练或者推理任务,成本可能越来越低。于是旧GPU即使还能正常工作,它的相对经济价值也可能迅速下降。

这意味着,如果今天整个行业高估了未来几年的算力需求,留下来的未必是一批可以低成本使用十几年的基础设施,其中相当一部分可能是正在快速失去成本竞争力的计算设备。

这并不意味着今天建设数据中心是错的,旧GPU也不会几年后就全部失去价值。但它改变了一个重要的投资逻辑:AI基础设施必须更快产生足够大的商业回报。

而这恰恰是今天AI行业最值得讨论的问题。

AI商业化当然已经发生,模型公司收入也在快速增长。真正的问题不是“AI有没有收入”,而是这些收入未来能不能支撑整个行业数千亿美元规模的资本投入,并最终产生与之匹配的利润和生产率。

互联网最后成功了,并不代表2000年投资互联网的每家公司都成功。当年的技术革命是真的,投资泡沫也是真的。

AI完全可能重复这种情况。

AI是真的,泡沫也可能是真的

我们经常把“AI是不是泡沫”理解成一个非黑即白的问题。相信AI最终改变世界,似乎就必须同时相信今天的资本开支、公司估值和AGI时间表都是合理的;如果质疑今天的投资规模,又很容易被认为是在否定AI。

其实完全没有必要。

AI可以是一项改变世界的技术,同时资本市场也可能高估了它产生经济回报的速度。判断这件事情最终只有一个很朴素的标准:今天投入进去的这些钱,未来究竟能够产生多少真实的收入、利润和生产率。

如果AI真的能够迅速进入医疗、制造、科研和大量复杂工作,让整个经济生产率出现大幅增长,那么今天数千亿美元的投资也许只是开始。但如果阿西莫格鲁的估算更接近现实,未来十年的生产率提升依然相当有限,那么很多按照AGI快速到来进行的投资,就需要重新计算回报。

这也是我认为阿西莫格鲁的观点真正值得讨论的地方。

技术价值、生产率价值和投资价值,本来就是三件不同的事情。

AI越来越好用,并不意味着它马上能够改变整个经济;它最终能够改变整个经济,也不意味着今天投入其中的每一美元资本都能够赚回来。

而比判断有没有泡沫更加重要的问题,是我们最终准备把AI用在哪里。如果AI只是帮助企业用更少的人完成同样的事情,我们得到的可能主要是成本下降;如果AI能够让医生解决过去解决不了的问题,让工人掌握过去只有专家才有的能力,让科学家发现新的药物和材料,它才真正可能创造过去不存在的价值。

到那个时候,AI带来的经济增长也许会远远超过阿西莫格鲁今天那个保守的预测。

但这仍然不能证明今天所有关于AGI、资本开支和估值的故事都是对的。

互联网时代已经证明过一次:

技术革命是真的,泡沫也可以是真的。

Google发现卖铲子比自己挖金矿更赚钱之后,DeepMind怎么办?

这几天,Google对DeepMind进行了一次很大的调整。Demis Hassabis不再负责日常运营,转任Google DeepMind董事长和Alphabet首席科学家;原CTO Koray Kavukcuoglu接手Gemini模型、前沿AI研究、Gemini App和开发者团队。Jeff Dean和Sanjay Ghemawat也离开Google。Google说这是为了让Demis把更多精力放在AGI和科学上,但SemiAnalysis最新的文章《Gemini is Cooked but GCP is Cooking》却给出另一个解释:Gemini可能正在失去前沿优势,而Google Cloud正成为越来越确定的商业回报。

这让我想到那个老套的淘金故事。当所有人都在山里找金矿时,最稳定的生意往往不是自己挖到金子,而是卖铲子。Google现在似乎发现,它甚至不需要Gemini永远最强,只要AI公司都需要TPU、数据中心和云服务,Google就有机会从整个产业增长中赚钱。问题也因此变得有意思:当卖铲子已经是一门足够好的生意之后,Google还会不会继续给DeepMind留下足够资源,去寻找那些不知道什么时候才能挖出来的金矿?

一、Gemini可以不是第一,但Google未必会输

过去两年,我们习惯于用模型排行榜理解AI竞争,但Google早已不只是一家模型公司。Alphabet今年第二季度财报显示,Google Cloud收入达到248亿美元,同比增长82%;营业利润达到88亿美元,利润率提高到35.6%,Cloud backlog达到5140亿美元。更值得注意的是,Google第一次明确披露,已经开始把完整的TPU系统卖到客户自己的数据中心,现有TPU系统销售协议的大部分收入预计将在2027年确认。Google正在从“出租算力”,进入直接销售AI基础设施的生意。

SemiAnalysis甚至估算,未来Google会把相当大比例的TPU提供给Anthropic等外部AI公司。数字来自它自己的模型,不能当成Google已经确认的事实,但商业逻辑很清楚:如果Claude成为最强模型,却大量运行在Google Cloud上,Google并没有输;新的AI公司把融资花在Google的TPU和数据中心里,Google一样可以赚钱。OpenAI需要GPT赢,Anthropic需要Claude赢,但Google不一定需要Gemini每一代都赢。

二、当一块TPU可以直接赚钱,DeepMind面对的问题就变了

SemiAnalysis最值得关注的,并不是它断言“Gemini已经不行了”。这种判断太绝对,Google官方仍表示已经开始Gemini 4迄今最雄心勃勃的预训练。真正值得讨论的是,DeepMind和Google Cloud都需要同一种资源——算力。

一块TPU留给DeepMind,可以训练下一代Gemini,赌的是未来模型能力;交给Google Cloud,却可以很快变成合同、backlog和收入。Google在Q2财报中也明确表示,目前仍处于算力供应受限状态,外部Cloud客户和Google内部业务都在争夺容量。于是算力分配越来越像资本配置:同样一块芯片,是投入一个几年后可能成功的研究项目,还是现在就变成一份利润可见的云合同?

站在Google Cloud的角度,把TPU卖给Anthropic完全可以理解;但站在DeepMind的角度,你的竞争对手可能正在使用你所在公司的算力训练下一代模型。这是两种不同的商业逻辑。

三、DeepMind真正值得留下来的,也许从来不是Gemini

如果DeepMind存在的意义只是做一个更好的聊天机器人,这个问题并没有那么重要。即使某一天Gemini只能排第三、第五,用户可能也只是换一个应用、换一个API。

但DeepMind过去十几年真正让我觉得它值得存在的,并不是Gemini,而是AlphaFold。2020年,AlphaFold 2解决了困扰生物学界几十年的蛋白质结构预测问题。今天,AlphaFold数据库已经提供超过2亿个蛋白质结构预测,被190多个国家的300多万研究人员使用,其中超过30%的相关研究用于理解疾病。Demis Hassabis和John Jumper也因为蛋白质结构预测获得2024年诺贝尔化学奖。

这几年DeepMind又做出了AlphaMissense、AlphaGenome、AlphaProteo。今年推出的Co-Scientist,则试图把Gemini变成科学家的研究伙伴。在斯坦福的一项肝纤维化研究中,它提出的三个候选药物里有两个在实验中表现出抗纤维化效果,其中一个阻断了91%的相关损伤反应。

这些工作短期内很难像Cloud一样显示ARR,也很难用季度收入证明回报率,但它们可能改变药物研发、疾病研究乃至基础科学的速度。所以我并不认为DeepMind一定要在每一代Gemini上击败OpenAI和Anthropic,但我仍然希望Google把它真正保留下去。

四、这次调整,也可能不是坏事

把这次调整直接解释成Google为了赚钱开始放弃DeepMind,同样过度了。Google官方给出的解释恰恰相反:Sundar Pichai说,让Demis转任Google DeepMind董事长和Alphabet首席科学家,是为了让他把更多精力放在AGI和科学的未来;Demis自己的内部信也写得很明确,他一直相信AI的第一应用应该是改善人类健康,现在到了AI向世界证明其价值的时候,包括帮助人类最终攻克癌症这样的疾病。

从这个角度看,这次调整甚至可能是在把两件不同的事情拆开。Gemini已经是拥有9.5亿月活用户、API每分钟处理约220亿tokens的大规模产品,需要工程效率和商业执行;Demis真正感兴趣的AGI、生命科学和基础研究,则需要另一套时间尺度。

所以真正应该观察的,不是Demis的职位名称,也不是Gemini下一次在榜单上排第几,而是人才、算力和时间。Google是否还愿意把最好的研究人员留给没有直接产品目标的项目,是否愿意为科学研究提供足够的计算资源,是否允许一个项目几年都无法证明自己的商业回报。只要这三样东西还在,DeepMind就还是DeepMind。

五、Google可以卖铲子,但别停止寻找金矿

我能理解Google现在的选择。Alphabet已经把2026年资本开支预期提高到1950亿至2050亿美元,这些钱最终必须找到商业回报。Google Cloud高速增长、TPU能够卖出去,对Alphabet来说都不是坏事;而且只有一家企业能够持续赚钱,它才有能力长期承担那些高风险、低确定性的研究。

所以我真正担心的,从来不是Google开始用AI赚钱,而是当赚钱越来越容易以后,一家公司还有没有耐心继续做那些暂时不知道怎么赚钱的事情。如果当年的DeepMind在AlphaGo之后就被要求证明下一个项目能带来多少订阅和Cloud收入,后来有没有AlphaFold,很难说。今天回头看,它创造的价值也很难被放进Alphabet某一条财报科目里。

Google当然可以卖铲子,而且最好把铲子卖得足够赚钱。Gemini也不必永远排名第一,Google依然可能成为AI时代最大的赢家之一。但我还是希望DeepMind能够继续做那些不知道什么时候才能看到回报的事情,因为这个世界并不缺更好的聊天机器人,也不缺更便宜的token和更大的数据中心。真正稀缺的,是还有人愿意拿最好的AI、人才和算力,去解决疾病、生命、能源、材料这些人类至今没有解决的问题。

如果最后只满足于卖铲子,那才是真的把AI想小了。

谢尔盖·布林重新回到Google AI权力中心,DeepMind为什么必须退半步?

这几天Google AI最大的一次变化,不是新模型,而是人事。Demis Hassabis不再负责Google DeepMind的日常运营,转任DeepMind董事长和Alphabet首席科学家,把更多精力放到AGI、科学研究以及Isomorphic Labs;原DeepMind CTO、Google首席AI架构师Koray Kavukcuoglu接过日常管理。与此同时,谢尔盖·布林出现在Google AI的权力中心。

严格来说,布林并没有获得“Google AI负责人”的正式头衔,Koray是日常执行者。但《金融时报》报道,Koray去年已从伦敦搬到Mountain View,现在就在布林旁边办公;此前《The Information》也报道,当布林需要为AI团队协调算力、招聘或人员调动时,找的人就是Koray。布林从ChatGPT出现后回到Google,也早已不是偶尔参加会议,而是直接参与Gemini的训练和产品讨论。

所以,如果只把这次变化理解成一次管理层换届,可能低估了它的意义。Google真正要解决的是:DeepMind过去十几年形成的研究文化仍然很重要,但在今天与OpenAI、Anthropic、xAI进行近乎按月计算的模型和产品竞争时,仅靠这种文化已经不够了。

DeepMind没有失败,只是AI竞争换了游戏

我一直很喜欢DeepMind。它最吸引我的地方,从来不是做出更聪明的聊天机器人,而是相信AI最终应该去解决那些人类长期解决不了的问题。AlphaFold就是最好的例子:今天它已经提供超过2亿个蛋白质结构预测,被全球190多个国家的300多万研究人员使用,超过30%的相关研究与疾病有关。这样的成果,很难用季度收入衡量。

DeepMind之所以能做出这些东西,也因为它长期保持着接近研究机构的文化,允许科学家研究短期看不到商业回报的问题。但ChatGPT之后,前沿研究第一次和大规模商业竞争几乎重叠在了一起。今天一个模型训练完成,还要迅速完成评测、安全、API、开发工具、Agent能力和产品集成;Anthropic靠Claude Code建立开发者优势,OpenAI不断用新模型和Agent改变产品形态,xAI也在快速追赶。在这样的竞争里,两三个月都可能改变开发者的使用习惯。

Google应该很清楚这一点。Transformer论文来自Google,但后来真正把大语言模型变成大众产品的却是OpenAI。研究领先和市场领先,从来不是一回事。

Google现在最缺的,可能不是技术,而是组织速度

我不太认同“Google调整DeepMind,是因为Google AI已经落后”这种说法。从数据看,Google一点都不弱:今年第二季度Gemini App月活已经达到9.5亿,Google Cloud收入同比增长82%,Search仍增长17%;Alphabet还把2026年资本开支指引提高到1950亿至2050亿美元。Google拥有其他AI公司很难同时具备的算力、产品和分发体系。

问题可能恰恰出在资源太多。一家创业公司做出新模型,核心团队很快就能决定上线;Google发布旗舰模型,却要同时考虑Search、Cloud、Android、YouTube、开发者、安全、法律和几十亿用户。每个部门都有合理诉求,最后叠在一起,就可能拖慢组织速度。

Gemini 3.5 Pro的延期是一个很现实的例子。Google在5月曾表示Pro版本预计6月推出,但到现在仍在测试。报道显示,它尤其在Coding能力上没有达到内部目标,多层利益相关方参与发布也增加了协调成本。当然,这不能简单证明“DeepMind研究文化导致延期”,但至少说明Google今天需要的不只是更好的研究,还需要缩短研究到产品之间的距离。

Koray的重要性也正在这里。他过去几年一直负责组织Gemini研究团队,去年成为Google首席AI架构师后,又负责把Gemini推进整个Google。《The Information》把他称为Google AI内部的“fixer”。这次调整,与其说Google把DeepMind交给了一个“更商业的人”,不如说是把日常执行交给了一个更擅长穿透组织的人。

布林真正带回来的,可能不是技术,而是权力

我不太愿意把这件事写成“Pichai不行,所以创始人回来救公司”。过去几年Google合并Brain和DeepMind、大幅增加AI投入,都说明Pichai并不保守。但职业经理人和创始人在巨型公司里的作用确实不同。Pichai需要对整个Alphabet负责,要平衡搜索广告、Cloud、监管和资本回报;布林却可以只盯着一件事:Google不能输掉这一轮AI。

更重要的是,他拥有普通高管很难拥有的跨部门权威。算力给谁、哪个团队应该合并、哪个研究员必须留下、什么项目应该提高优先级,这些在大公司里往往不是技术问题,而是组织问题。技术范式剧烈变化时,大公司最稀缺的有时不是流程,而是有人能越过原有利益边界重新排序资源。

因此,布林与Koray的组合才值得关注:一个拥有足够的组织影响力,一个擅长把复杂事情真正推进下去。《金融时报》认为这次调整进一步强化了布林在Google AI中的影响力,这比“布林正式接管Google AI”准确得多。

但DeepMind只能退半步,不能退出

如果因为商业竞争激烈,就把DeepMind彻底变成Gemini产品部门,我反而认为会是Google的损失。今天大家讨论AI,注意力很容易被Benchmark、Coding和Agent吸走,但如果十年以后回头看,AI给人类带来的最大价值,也许不是帮我们多写了多少代码,而是有没有解决疾病、衰老、能源、材料这些过去解决不了的问题。AlphaFold已经证明,这条路值得有人长期坚持。

所以我更愿意把Demis这次变化理解成“退半步”。他不再承担Gemini每天面对的产品、进度和组织管理,把这些交给Koray;同时成为Alphabet首席科学家,继续把精力放到AGI、AI for Science和Isomorphic Labs。现有报道也显示,这次调整并不等于Google放弃长期研究,而是让Demis重新聚焦自己最独特的能力。

如果Google能把这套结构运行起来,它实际上是在建立两种时间尺度:一边是布林和Koray,需要几个月交一次答卷,让Gemini在Coding、Agent、API和产品上保持竞争力;另一边是Demis和DeepMind的科学研究,允许一些项目五年、十年以后才看到结果。Pichai则负责让两套体系都能获得足够资源。

这比“商业派战胜研究派”更接近Google需要的答案。我也因此更加期待Gemini 3.5 Pro,以及已经开始推进的下一代Gemini模型。Google已经表示,新的预训练正在进行,而且是迄今“最雄心勃勃”的一次。3.5 Pro能不能把Coding和Agent的短板补上,下一代Gemini能不能重新建立明显领先,会成为这次调整最直接的检验。

Google过去最宝贵的能力,是DeepMind愿意研究十年以后的问题;今天最紧迫的任务,却是Gemini必须几个月就交一次答卷。这两件事都重要,也不该让任何一件吞掉另一件。

所以我真正期待的,不是布林回来后把DeepMind变成只追逐模型榜单的AI公司,而是让Google跑得更快,同时让Demis继续有空间去做那些短期没有收入、却可能真正改变人类未来的研究。如果这件事能做到,那么DeepMind这次退的半步,也许会让Google的AI走得更远。

Google首席科学家Jeff Dean离职创业,他把“AI成功率1%”的选题法用在了自己身上吗?

在宣布离开Google创业之前,Jeff Dean其实已经把自己的创业逻辑讲了出来。

7月25日,在Y Combinator的Startup School现场,面对约6000名创业者,他被问到:当基础模型越来越强,创业公司还能选择什么方向?Jeff Dean的回答有些反直觉。他建议创业者不要优先寻找模型已经能够完成20%的任务,而应该寻找模型目前只能成功0%或1%的问题。因为如果模型已经能做20%,说明这种能力已经开始出现,随着训练数据和模型规模继续增长,它很可能很快变得更好。

十天之后,Jeff Dean宣布结束自己在Google近27年的职业生涯,与Sanjay Ghemawat、Oriol Vinyals和Quoc Le共同创办Discovery Loop。这家公司不是再做一个聊天机器人,而是尝试自动化科学与工程研究的完整循环:提出实验、运行实验、评价结果,再根据反馈进入下一轮。

这里要先澄清,“成功率1%”说的不是创业公司的成功概率,而是通用模型完成某类任务的成功率。Jeff Dean不是鼓励创业者去赌一个几乎不可能成功的项目,而是在提醒他们:基础模型进步越快,最容易做出来的AI产品,越可能最先被模型本身吞掉。

一、AI已经能做20%,为什么反而可能更危险?

传统软件创业,往往从一个已经被证明可行的需求开始。技术能解决20%,创业公司补齐剩下的80%,再通过产品、渠道和服务建立优势。这套逻辑能够成立,是因为底层技术一般不会在几个月内突然完成一次能力跃迁。

基础模型改变了这种节奏。模型能够完成20%,有时并不意味着创业窗口已经打开,反而意味着这个任务已经进入模型能力的覆盖范围。创业公司可能花一年时间优化提示词、补充工作流和产品界面,下一代模型更新以后,原来最核心的功能就变成了标准能力。

所以,“1%选题法”真正关心的不是难度,而是耐久性:创业公司究竟是在利用模型,还是把自己的命运完全交给模型供应商?如果产品价值主要来自模型暂时不稳定的能力,那么模型越强,产品的护城河反而越薄。

这不意味着所有模型已经能做20%的方向都不值得进入。消费产品仍可依靠品牌和分发建立价值,企业应用也可能掌握模型厂商拿不到的数据与流程。更准确的问题是:即使明天模型能力提升一倍,这家公司是否仍有独立存在的理由?

二、Discovery Loop几乎就是这套方法的标准答案

今天的AI已经能够读论文、生成假设、编写实验代码,也可以帮助分析数据。但让一个系统独立完成开放式科学研究,持续提出值得尝试的新方向,正确运行实验、识别失败原因,再将结果用于下一轮决策,仍然远未成为可靠能力。Discovery Loop选择的不是其中某个环节,而是试图把它们连成一个持续运行的闭环。

公司的路线是先把自己作为第一个客户,从机器学习研究开始,让系统自动提出、执行和评价大量实验,用这些实验改进自己的模型和算法,再扩展到芯片设计、生物、药物和材料等领域。Oriol Vinyals也承认,当前模型并不擅长提出真正新颖的想法,因此最初仍会由人与AI共同选题。

四位创始人的能力也与这条路线高度匹配:Jeff Dean与Sanjay Ghemawat长期负责Google的大规模计算和搜索基础设施,Oriol Vinyals曾是Gemini的重要技术负责人,Quoc Le参与创建Google Brain,并参与了自动发现机器学习算法的AutoML-Zero。后者早在2020年就尝试让系统从基本数学操作出发,自动发现完整的机器学习算法。

Discovery Loop采用公共利益公司结构,获得Khosla Ventures、Radical Ventures等机构支持,融资金额与估值尚未公开。Google虽然失去四位核心科学家,却没有与他们切割,而是成为创始投资者和云合作伙伴,并将在第一年提供计算资源。

Jeff Dean选择的不是“AI已经能做,只是体验还不够好”的产品,而是“AI目前还不能可靠完成,但一旦形成闭环就可能产生巨大价值”的问题。Discovery Loop即使不是按一条公式算出来的项目,也几乎是“1%选题法”的一次自我示范。

三、真正值钱的不是困难,而是能把失败变成反馈

仅仅选择一个AI不会做的问题,并不等于找到了创业机会。很多问题的成功率为0%,只是因为技术路径、数据条件和成本结构都不成立。

“1%问题”能够变成一家公司,关键是失败能否被快速验证,并转化为下一轮决策的反馈。结果需要能够评价,实验需要自动或半自动执行,单次尝试的成本要能够下降,实验结果还要重新进入系统。

这也是Discovery Loop先从机器学习研究开始,而不是直接进入新药研发的原因。机器学习实验天然数字化,模型结构、训练方法和性能指标都可以在计算环境中运行和评价;到了生物、药物和材料领域,许多实验仍需要真实实验室、漫长周期和监管验证,自动化难度会明显上升。

Google已有的AI Co-Scientist、ERA和AlphaEvolve也说明,这条路线并非空想。它们分别尝试生成可验证的科学假设、编写计算实验软件,以及把大模型生成代码、自动评价器和进化搜索结合起来。这些系统还不能独立完成完整科学发现,却证明了一个关键逻辑:只要评价标准清晰,模型偶尔产生的正确答案,就可以通过大规模实验被筛选和放大。

因此,Discovery Loop真正想建立的护城河,未必是某个单独模型更强,而是模型、实验环境、评价器、算力和领域知识组成的闭环。实验如何设计、结果如何评价、反馈如何进入下一轮,这些才可能成为长期资产。

四、Google自己已经在做,为什么还要离开?

这也是整件事最值得讨论的矛盾。Google并不缺少相关项目,也不缺模型、算力和人才。既然这些技术已经在Google内部出现,四位核心科学家为什么还要单独成立一家方向相近的公司?

现有信息不足以给出确定答案,但组织问题可能比技术问题更重要。Oriol Vinyals在采访中提到,大型组织总有很强的惯性,要推动激进变化需要克服很多阻力。Discovery Loop可以把“自动发现循环”设为唯一目标,让模型、基础设施、人才和产品围绕这一件事重新组织,而不必同时服务Google的多个业务。

Google成为投资者并提供算力,也让这次离开不像传统意义上的决裂,更像是把一项高风险、长期、难以按现有组织方式推进的研究放到外部公司。Discovery Loop获得创业公司的专注和速度,同时继续使用Google的资源;Google失去直接管理权,却保留投资关系和潜在回报。

这或许也是大公司越来越常见的一种创新方式。不是把所有前沿项目都留在内部,也不是等核心科学家彻底离开,而是允许一部分团队独立出去,用新的组织结构承担更高风险,同时通过投资、云服务和技术合作保留联系。对于Google而言,Discovery Loop既是一次人才流失,也可能是一次研究能力的外部延伸。

但现在还不能把它写成成功案例。Discovery Loop刚刚成立,没有公开产品、客户和研究成果,创始团队在公司公布时甚至尚未开始大规模招聘。顶级团队能够获得资金和算力,并不代表它一定能把AI变成真正的科学研究者。在提出原创问题、验证复杂因果关系,以及把计算实验转化为现实结果这些环节,当前模型仍有很长的路要走。

五、普通创业者不该照抄“1%”,但应该用它检查自己

Jeff Dean有资格选择一个模型成功率接近0%的问题,是因为他拥有可能最适合解决这类问题的团队,还有Google的计算资源和顶级投资机构支持。普通创业者如果只记住“越难越好”,得到的很可能不是护城河,而是一个永远无法交付的产品。

这套方法真正值得借鉴的,不是具体百分比,而是一次反向压力测试:如果下一代模型直接提供了你的核心功能,用户为什么还需要你的产品?你是否拥有模型厂商拿不到的数据、评价体系和真实工作流?用户使用后能否留下独有反馈?AI除了回答问题,能否进入业务中执行和验证结果?

大量AI产品争夺的是模型已经会做的事情,区别只是界面更漂亮、提示词更完整、某个流程暂时更顺畅。这些产品并非没有价值,但如果不能继续沉淀数据、工作流、评价标准和客户关系,模型升级越快,它们面临的替代压力也越大。

所以,Jeff Dean是否把“AI成功率1%”的选题法用在了自己身上?

目前没有公开证据证明,他依据这条规则决定创办Discovery Loop。但可以确认的是,他在YC现场描述“自动化科学方法”时,这家公司已经在秘密筹备;他提出的选题逻辑与Discovery Loop的方向,也来自同一种判断:不要只做AI今天已经能做一点、明天很可能会做得更好的事情,而要寻找AI仍然不会做,但你有办法让每一次失败都推动它向前一步的问题。

Discovery Loop最终能否成功,现在还无法判断。它甚至可能再次证明,自动化科学远比自动化写代码困难。但至少在选题上,Jeff Dean给出了一个清楚的答案:真正的“1%”,不是创业成功的概率,而是基础模型尚未占领的能力空间。

AI模型开始不拼最强了,Google正在把竞争拉回成本和规模

最近 Google 发布了 Gemini 3.6 Flash、Gemini 3.5 Flash-Lite 和 Gemini 3.5 Flash Cyber 三个模型。比较有意思的是,这次发布并没有像过去的旗舰模型一样,在社交媒体上形成一轮“谁是最强模型”的大讨论。很多媒体反而把注意力放在了另一个问题上:Gemini 3.5 Pro 为什么还没有发布。

Google 发布了 Gemini 3.6 Flash、Gemini 3.5 Flash-Lite 和 Gemini 3.5 Flash Cyber 三个模型

这也很正常。过去两年,我们已经习惯了一种评价 AI 模型的方式。一个新模型出来,先看 benchmark,再看 Coding 排名,然后问一句:它超过 GPT 了吗?超过 Claude 了吗?是不是现在世界上最强的模型?

但我自己最近越来越觉得,这种评价方式可能正在过时。

Google 这次发布 Gemini 3.6 Flash,真正值得关注的,并不是它又在某几个 benchmark 上提高了多少,而是 Google 开始把模型竞争重新拉回一个非常现实的问题:一个 AI 到底能不能更快、更便宜地完成任务,而且能够被大规模使用。

这件事,在 AI Coding 上已经非常明显了。

一、最强的模型,不一定是我最愿意用的模型

我现在同时使用几个主流的 AI Coding 工具和模型,一个很明显的感受是,不同模型之间最大的区别已经不只是“谁更聪明”,还有完成一个任务需要多少时间。

比如 Claude Opus 4.8 配合 Superpower,处理复杂问题确实很强,尤其是在理解代码、深入分析和长时间规划方面,它经常会考虑得非常完整。但代价也很明显,就是慢。在我自己的实际开发任务中,同一个级别的任务,Claude Opus 4.8 + Superpower 花费的时间,经常是 GPT-5.6 Sol + 原生 Plan 模式的数倍,有些任务甚至能达到一个数量级的差距。

Gemini 给我的感觉则完全不同。

从 Gemini 3.5 Flash 开始,我最大的感受就是快,而且不是聊天时快几秒钟这么简单,而是在 Coding Agent 连续执行几十个步骤之后,整个任务的完成时间明显缩短。对于很多日常开发任务,比如改一个页面、调整接口、增加字段、修改已有逻辑、修普通 Bug,甚至按照已经确定的方案批量修改代码,我并不需要模型每一步都进行非常深入的推理。很多时候,我需要的是它能够快速理解要求,然后准确执行。

Gemini 3.6 Flash 延续的其实就是这条路线。Google 官方数据显示,它相比 3.5 Flash 在 Artificial Analysis Index 上减少了约 17% 的输出 Token,同时在多步骤工作流中减少推理步骤和工具调用,API 输出价格也下降到了每百万 Token 7.5 美元。Google 给这个模型的定位非常直接,就是用于大规模运行 AI Agent。

我觉得这里真正发生变化的,不只是 Gemini 又快了一点,而是模型竞争的评价标准正在发生变化。

二、Agent改变了模型的经济账

以前使用 ChatGPT,一次对话就是一次模型调用。你问一个问题,模型思考几十秒还是一分钟,差别虽然存在,但还可以接受。在这种模式下,当然是模型越聪明越好,因为调用次数并不多。

Agent 完全不是这么回事。

一个 Coding Agent 接到任务之后,要先读取代码、搜索文件、理解架构、制定计划,然后修改代码、运行程序、发现错误、继续修改、执行测试,最后再检查结果。一个看起来不复杂的任务,背后可能已经调用模型几十次;复杂一点的任务,模型调用和工具调用可能达到上百次。

这时候,每一次慢一点,最后都会累积成非常大的差距。

如果一个模型每一步都比另一个模型多思考十几秒,执行五十步以后,差距就已经不是“回复稍微慢一点”,而是十几分钟甚至几十分钟。再加上模型可能因为推理路径更长而产生更多 Token、更多工具调用和更多修改循环,一个模型看起来单次能力更强,完成整个任务的效率却未必更高。

所以到了 Agent 时代,我们可能需要换一种计算方法。

过去大家关心的是每百万 Token 多少钱,以后真正重要的指标可能是:完成一个任务到底需要多少钱,需要多少时间。

Google 在介绍 Gemini 3.6 Flash 时,反复强调的恰恰不是单纯降低 Token 单价,而是更少的输出 Token、更少的推理步骤、更少的工具调用和更少的代码修改循环。在 DeepSWE 等测试中,Google甚至观察到部分场景 Token 使用量大幅下降。

这背后其实是一种完全不同的产品思路。模型不是为了在一道特别难的问题上证明自己有多聪明,而是为了让一个 Agent 连续工作几百次以后,仍然足够快、足够便宜。

三、很多开发任务,根本不需要每次都用最强模型

这也是我实际使用 AI Coding 之后越来越明显的感受。

我们很容易把“Coding 能力”理解成一种单一能力,然后去寻找一个最强的 Coding 模型。但真实的软件开发并不是这样。设计一个复杂系统架构,和把已经确定好的接口增加一个字段,显然不是同一种任务;排查一个非常隐蔽的并发 Bug,和按照设计稿调整页面样式,也没有必要使用相同级别的推理能力。

真正困难的任务,需要 Claude Opus 4.8、GPT-5.6 这类更强的模型深入分析。但软件开发中还有大量工作其实属于执行型任务。一旦需求明确、方案确定,接下来更重要的是执行速度、准确性和稳定性。

这也是我觉得 Gemini Flash 特别适合的地方。

Google 在今年 5 月发布 Gemini 3.5 Flash 时,就已经把它定位成面向 Agent 和 Coding 的主力模型,并强调它在保持较强能力的同时拥有更高的输出速度。到了 3.6 Flash,Google 又进一步减少 Token 消耗和执行循环。

换句话说,Google 似乎并不打算让每一个任务都去调用最强大的 Pro 模型。

这可能才是更合理的 AI 架构。

复杂任务先由强模型理解目标、设计方案和处理真正困难的问题,Flash 负责大量执行,Flash-Lite 再去承担分类、提取、转换、搜索和简单子任务。Google 这次同时发布的 3.5 Flash-Lite,速度达到每秒约 350 个输出 Token,价格只有每百万输入 Token 0.3 美元、输出 2.5 美元,它存在的意义显然也不是挑战“世界最强模型”,而是为了让大量 Agent 工作负载真正跑得起来。

这和云计算其实很像。没有人会因为某一种服务器性能最强,就把公司所有业务都部署到最昂贵的机器上。真正成熟的基础设施,一定会根据任务进行分层。

AI 模型最终可能也会如此。

四、速度正在从“体验”变成一种真正的模型能力

过去我们谈模型速度,很容易把它理解成用户体验。一个答案两秒出来还是十秒出来,当然是两秒更舒服。

但到了 Agent 时代,速度已经不只是体验问题,而是生产力问题。

一个人使用聊天机器人时,慢一点可能只是多等几十秒;一个 Agent 一天运行几百个任务时,速度直接决定它一天到底能完成多少工作;一家企业同时运行几千甚至几万个 Agent 时,延迟、Token 数量和工具调用次数最终都会变成服务器、GPU 和真金白银的成本。

这时候,模型能力就不能只看智力。

至少应该同时看四件事:能力、速度、成本和可靠性。

一个模型即使 benchmark 高 5%,但完成同样的任务慢几倍、成本高几倍,它也未必适合成为大规模 Agent 的默认模型。反过来,一个模型只要能力跨过了“足够好”这条线,速度更快、成本更低,就可能获得远远更多的实际调用。

这可能也是为什么 Google 现在如此重视 Flash。

媒体仍然在等待 Gemini 3.5 Pro,因为旗舰模型代表 Google 在前沿模型上的技术上限,Reuters 和 TechCrunch 对这次发布的报道,也都把 3.5 Pro 的延期作为一个重点。但从商业上看,真正贡献海量 Token 消耗和 Agent 工作负载的,未来未必是 Pro,而更可能是 Flash 这一层。

五、Google可能根本不想只赢“最强模型”这场比赛

过去两年,OpenAI、Anthropic 和 Google 都在争夺同一个位置:谁拥有世界上最聪明的模型。

这个位置当然重要,因为最强模型决定技术上限,也决定品牌影响力。但随着模型整体能力不断提高,我觉得另一个市场正在变得更大:大量原本根本不会交给 AI 的工作,现在开始可以被 Agent 自动完成。

到了这个阶段,竞争规则自然会变化。

一个模型偶尔解决一道世界上最难的问题,和一个模型每天被调用几百亿次,是两种完全不同的商业价值。前者证明技术高度,后者决定产业规模。

Google 的优势恰恰可能在后者。

Google 做搜索、广告、YouTube、Android 和云计算这么多年,本来最擅长的就不是只造一个最昂贵的产品,而是把一种技术降低成本,然后服务几十亿用户。当 AI 从聊天工具变成基础设施,这种能力可能会重新变得重要。

所以我觉得 Gemini 3.6 Flash 真正值得关注的地方,并不是它有没有超过 GPT-5.6,也不是它能不能打败 Claude Opus 4.8。

它代表的是另一种竞争思路。

过去两年,我们一直在问:谁能造出最聪明的 AI?

接下来真正决定市场格局的问题可能会变成:谁能让足够聪明的 AI,以足够低的成本、足够快的速度,被调用足够多次。

最强模型仍然重要,但它决定的可能只是 AI 的上限。

真正决定 AI 能走多远、进入多少行业、完成多少工作、最终形成多大市场的,可能是那些没有拿到“世界第一”头衔,却每天完成最多任务的模型。

从这个角度看,Google 这次没有拿出大家一直等待的 Gemini 3.5 Pro,当然有些遗憾。但 Gemini 3.6 Flash 所代表的方向,可能同样值得重视。

因为 AI 模型的战争,正在从一场跑分比赛,慢慢变成一场效率和规模的战争。

Google AdSense西联汇款收款

上两次收Google Adsense的汇款,都是采用支票的方式,时间长,而且在中国银行办理还需要50-60元的手续费,后来在网上看到Google AdSense可以采用西联汇款收款,我也把我Google AdSense帐户里的付款方式改为了西联汇款,帐户里够了100美金,上个月底就看到了付款详情,今天我到农业银行,提取了这笔汇款,没有手续费,我直接换成人民币现金取走。

在设置西联汇款的时候有几个地方注意,它页面上虽然写了“为了领取您的付款,您需要持有政府核发的与以下收款人姓名完全一致的有效证件。”,但是在填写收款人姓名的时候还是写英文,并注意姓名的顺序,比如你的名字是“张三”,那要在“收款人名”填写“San”,“收款人姓”填写“Zhang”,到时持你的身份证到银行取款,是没有问题的。

在国内,西联汇款的代理机构是农业银行和邮政储蓄,在http://www.westernunion.cn/sc/location_search.php可以查到代理的网点,但好像不太准,我今天去的江宁路农业银行在上面就没有,我想应该是大一点的分行或是支行都应该有这样的业务。

到农业银行后先填写两张单子,一个是西联汇款的收汇单,里面收汇人和发汇人姓名地址都写英文,也就是你Google AdSense里留的信息,汇款监控号码非常重要,这也是表示这笔汇款的依据,另一张单子是个人结汇申请书,结汇类型是“现汇”,结汇资金入账方式选“取现”,结汇资金来源就选“其他”,结汇用途写“零用”,其实可以随便写的,之后一些必要的签字等等,连同身份证交给柜台上之后会按照当前的汇率兑换为人民币,拿到人民币就OK啦。

用Google API来取得Google帐户的联系人列表

昨天写了一篇从Web Mail里取得用户通讯录的方法的文章,里面提到了Google的Account Authentication API,今天我们就用Account Authentication APIGoogle Contacts Data API来做一个取得Google帐户联系人的测试。

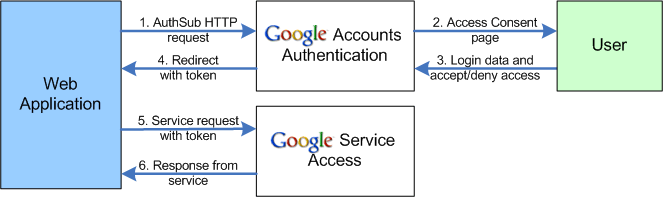
首先我们要看一下Account Authentication API,对于网络应用来说我们选择对网络应用程序的验证,对网络应用程序的验证也提供了 OAuthAuthSub 两种认证方式,我们选择AuthSub的认证方式,认证过程如下图

Google Authsub Diagram

用户在第三方Web应用上向Google Accounts Authentication发送AuthSub的HTTP请求,如果用户没有登录Google,则会显示登录页面,用户登录之后,会提示用户是否接受或拒绝这个第三方Web应用的访问请求,如果用户同意,Google就会生成一个token,转回第三方Web应用,第三方Web应用凭此token,可以请求Google的相关Sevice,比如联系人的服务,从而取得相关数据。

AuthSub有两种接口,一个是AuthSubRequest(A call to this method sends the user to a Google Accounts web page, where the user is given the opportunity to log in and grant Google account access to the web application. If successful, Google provides a single-use authentication token, which the web application can use to access the user’s Google service data.)另一个是AuthSubSessionToken(A call to this method allows the web application to exchange a single-use token for a session token),按照Google文档的理解,AuthSubRequest是一个单次的认证,AuthSubSessionToken应该是带会话(Session)的。

我们就举Google提供的例子

https://www.google.com/accounts/AuthSubRequest?
   next=http%3A%2F%2Fwww.yourwebapp.com%2Fshowcalendar.html
   &scope=http%3A%2F%2Fwww.google.com%2Fcalendar%2Ffeeds%2F
   &session=1
   &secure=1

https://www.google.com/accounts/AuthSubRequest就是AuthSub请求的地址,next表示认证之后要转回的地址,一般就是第三方Web应用的地址,也就是你网站的一个地址,Google会把token附带到这个地址后面,scope是你要请求的Google服务地址,这个例子里是要访问Google日历的数据,另外两个参数看Google的文档吧。

接下来,我们要取得Google帐户的联系人,我们先看看Google提供了多少可以访问的服务吧,访问Google数据API,Google提供的数据还着不少,有日历、文档、图书搜索、网路相册等等,当然也包括我们所需要的联系人的API,Google数据API要好好了解一下,总体来说Google提供一个Gdata的数据格式,和RSS的feed类似的格式,通过相关服务的访问地址,就可以返回Gdata数据,至于Gdata的读取,已经有了很多程序语言的封装好的程序(http://code.google.com/intl/zh-CN/apis/gdata/clientlibs.html),直接用就可以了,我们用PHP举例,PHP对Gdata的封装,是Zend Framework里的Gdata包,在http://framework.zend.com/download/gdata下载就可以了,但是现在Zend Gdata的包里没有直接的Google contacts的组件,但不要紧,通过Zend Gdata里基础数据的访问,可以取得Google contacts。

我们看看Google Contacts Data API的开发人员指南吧,取得联系人的Feed URL是

http://www.google.com/m8/feeds/contacts/userEmail/full 
或 
http://www.google.com/m8/feeds/contacts/default/full

那我们就用PHP来写一个取得联系人的程序吧

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
require_once 'Zend/Loader.php';
Zend_Loader::loadClass ( 'Zend_Gdata' );
Zend_Loader::loadClass ( 'Zend_Gdata_AuthSub' );
Zend_Loader::loadClass ( 'Zend_Gdata_ClientLogin' );
Zend_Loader::loadClass ( 'Zend_Gdata_Query' );
Zend_Loader::loadClass ( 'Zend_Gdata_Feed' );
 
$my_contacts = 'http://www.google.com/m8/feeds/contacts/default/full';
 
if (! isset ( $_SESSION ['cal_token'] )) {
	if (isset ( $_GET ['token'] )) {
		// You can convert the single-use token to a session token.
		$session_token = Zend_Gdata_AuthSub::getAuthSubSessionToken ( $_GET ['token'] );
		// Store the session token in our session.
		$_SESSION ['cal_token'] = $session_token;
	} else {
		// Display link to generate single-use token
		$googleUri = Zend_Gdata_AuthSub::getAuthSubTokenUri ( 'http://' . $_SERVER ['SERVER_NAME'] . $_SERVER ['REQUEST_URI'], $my_contacts, 0, 1 );
		echo "Click <a href='$googleUri'>here</a> " . "to authorize this application.";
		exit ();
	}
}
 
// Create an authenticated HTTP Client to talk to Google.
$client = Zend_Gdata_AuthSub::getHttpClient ( $_SESSION ['cal_token'] );
 
$gdata = new Zend_Gdata ( $client );
$query = new Zend_Gdata_Query ( $my_contacts );
//$query->setMaxResults(10);
$query->setMaxResults ( 2000 );
$feed = $gdata->getFeed ( $query );
 
foreach ( $feed as $entry ) {
 
	$parts = $entry->getExtensionElements ();
	foreach ( $parts as $p ) {
		$element = $p->getDOM ();
		switch ($element->tagName) {
			case 'email' :
				print ( "Email: " . $element->getAttribute ( 'address' ) . "<br/>" );
				break;
			case 'phoneNumber' :
				print ( "Phone: " . $element->nodeValue . "<br/>" );
				break;
			default :
				continue;
		}
	}
 
}

放在你服务器上运行一下吧(别忘了Zend Gdata包要加进去)。

从JavaEye上找的Google翻译JavaScript脚本

在Blog或新闻发布的时候,我们希望URL是一段有意义的字串,例如我Blog里的《Linux下切分Tomcat的catalina.out日志文件》文章链接是http://i.laoer.com/2009/02/18/rotating-catalina-out-in-tomcat-using-cronolog/,这样有利于SEO(搜索引擎优化),对于我们母语为中文的小虾,有时候要翻译标题还是有点头疼的,还好有了Google翻译,让翻译的事情变得简单了一点,但对于开发者,怎么使用户也方便的翻译,特别是在写Blog的时候就能把标题翻译好,还要动点脑筋,我看到JavaEye里发布新闻的地方有个“让Google帮助生成永久链接”的功能挺好的,看了一下他们的源码,得到以下这段,顺别也解释一下

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
<script type="text/javascript" src="http://www.google.com/jsapi"></script> //载入Google的jsapi
 
<script type="text/javascript">  
 
  function slugify(str) { //这个方法应该是将字符转为小写,并把一些特殊字符转为"-"
    return str.toLowerCase().replace(/[^a-z0-9-_]+/g, '-').replace(/^-|-$/g, '');
  }
 
  google.load("language", "1"); //载入Google的language Ajax库
 
  function translate_title() { //这里就是翻译文章标题了,里面的方法需要jQuery支持,之前要引入jQuery的包,这里就省略了
    if($F("news_title").blank()) {
      alert("请先填写标题");
      return;
    }
    $("news_slug_url").value = "正在翻译中...";
    google.language.translate($F("news_title"), "zh", "en", function(result) {
      if (!result.error) {
        $("news_slug_url").value = slugify(result.translation);
      }
    });
  }  
</script>

这里有个地方要说一下,Google的Ajax库API还是挺好的,可以load几种Ajax的库,另外Google的Web 工具包也可以看看。