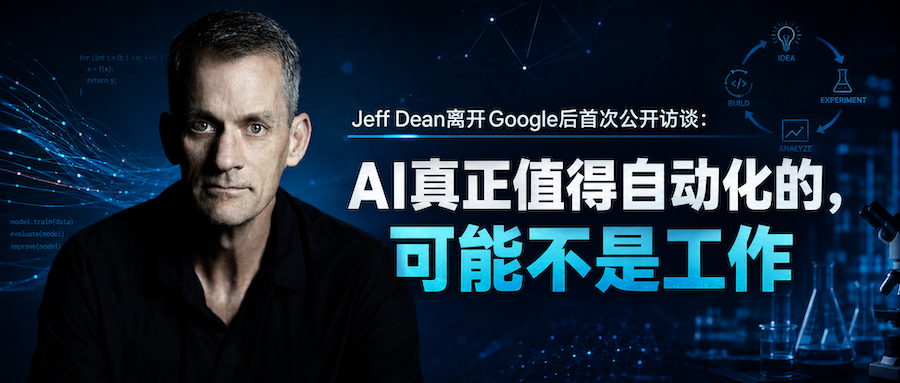
8月7日,Jeff Dean参加了斯坦福AASF 2026的一场Fireside Chat,这是他正式离开Google之后的第一次公开访谈。就在前一天,他结束了自己在Google长达27年的工作,与Sanjay Ghemawat、Quoc Le和Oriol Vinyals一起创办了Discovery Loop。
Jeff Dean在Google的地位比较特殊。从Google早期的MapReduce、BigTable等分布式计算基础设施,到后来Google Brain、TensorFlow、TPU,再到Gemini,他几乎参与了Google过去二十多年最重要的几次技术变化。所以他在这个时间选择离开Google,自然是这次访谈最受关注的问题。
Jeff Dean对此倒没有给出一个很戏剧性的解释。他仍然看好Google和Gemini,也没有把离职描述成与Google之间存在什么路线分歧。他认为现在云计算已经让小公司也可以获得过去只有大公司才能拥有的计算资源,而一个十个人左右的小团队,可以把所有精力都集中在同一个问题上。Google最终也成为Discovery Loop的投资者和Cloud合作伙伴,并为其第一年提供计算资源。
不过整场访谈看下来,我反而对Discovery Loop想做的事情更感兴趣。
这家公司想解决的问题是:能不能用AI把科学研究中的实验过程自动化。
从自动化工作,到自动化实验
过去几年,AI商业化最主要的方向,都是提高已有工作的效率。
Coding Agent帮助程序员写代码,客服Agent回答用户问题,Sales Agent寻找客户,Research Agent查找资料,现在Computer Use又开始直接操作浏览器和各种软件。
这些产品为什么容易找到商业价值,其实很好理解。原来一个任务需要10个人,现在5个人就能完成;过去需要一天的工作,现在一个小时做完。企业很容易计算用了AI以后节省了多少成本,所以这也是目前AI最容易形成商业闭环的地方。
我自己平时开发软件已经大量使用AI Coding,所以对于这部分价值,我没有什么怀疑。现在很多软件开发工作已经可以让AI完成,而且随着Coding Agent能力继续提高,这个比例还会越来越高。
但Discovery Loop考虑的是另外一种可能。
科学研究同样存在大量重复工作。一个研究人员提出一个假设,然后需要设计实验、写代码、运行实验、观察结果,再根据结果决定下一步做什么。Discovery Loop认为,现在很多科学研究的瓶颈,就在于这些实验仍然主要依靠人一个接一个地完成,速度很慢,也很难大规模并行。
他们希望利用前沿AI模型和大规模计算基础设施,把这整个实验循环自动化,让AI可以提出实验、执行实验、分析结果,再根据结果继续下一轮,并且同时运行数千个实验。
如果只是把这些事情理解成“AI帮助科学家提高工作效率”,其实和Coding Agent也没有太大区别。
但当实验数量可以从一个人一天做几个,变成AI同时做几千个以后,变化可能就不只是效率提高了。
很多以前根本没有时间尝试的方向,现在可以尝试;很多因为搜索空间太大而不得不依靠经验提前放弃的方案,也可以真正跑一遍看看结果。
这也是我觉得Discovery Loop比较有意思的地方。
过去十几年,我们一直在Scale Intelligence
如果把2012年以来这一轮AI的发展简单概括一下,我觉得大致可以理解为:
Scaling Compute → Scaling Models → Scaling Intelligence
这当然不是一个严格的技术发展阶段,只是方便理解过去十几年AI行业到底在做什么。
从GPU开始,到后来Google的TPU,再到今天动辄几十万张GPU的数据中心,整个行业一直在投入更多计算资源。更大的算力让我们能够训练更大的模型,而模型能力又随着架构、数据和训练方法的改进不断提升,最终才有了今天的大语言模型。
Jeff Dean在这次访谈里回忆,当年Google做语音识别时,他们把神经网络扩大大约50倍,一次实验带来的性能提升,就可以和这个领域过去几年积累的进步相比。这也是为什么后来Google非常重视Scaling。
当然,大模型能力提升并不只是因为模型变大。Transformer、Mixture of Experts、数据质量、后训练、强化学习等都发挥了重要作用。但从产业投入的角度看,过去十几年确实有一条非常明显的主线:不断把更多Compute转换成更多Intelligence。
现在这件事情已经发展到了一个比较有意思的阶段。
模型已经可以写代码、推理、调用工具,也开始能够连续工作几个小时。虽然距离真正可靠的自主Agent还有不少问题,但至少我们已经拥有了过去很难想象的大量“机器智能”。
所以接下来有一个问题就变得越来越重要:
这些已经获得的Intelligence,最终可以用来做什么?
Discovery Loop给出的答案,是继续把它转换成更多实验。
Scaling Experiments
Discovery Loop准备先从机器学习研究开始,而且首先拿自己做实验。
比如研究一个新的模型架构,过去研究人员需要先想方案,再修改代码、训练模型、跑Benchmark,然后根据结果决定下一步。如果一个方案效果不好,再换一个方向继续尝试。
这个过程很适合AI,因为结果相对容易验证。
AI完全可以同时提出大量架构或者训练方案,自动生成代码,调用计算资源进行训练,然后根据Benchmark结果选择下一轮更值得投入的方向。
WIRED在采访Discovery Loop四位创始人时,Quoc Le甚至提到,这样的系统未来也许能够找到一种不同于Transformer的新架构。公司计划先通过自动化机器学习研究来改进自己的AI能力,然后再把同样的方法扩展到芯片设计、生物、药物和材料等领域。
所以如果沿着过去十几年Scaling的逻辑继续往下看,我觉得可能会出现另外一条链路:
Scaling Intelligence → Scaling Experiments → Scaling Discovery
以前增加更多算力,主要是为了得到一个能力更强的模型。
如果Discovery Loop这条路能够成立,以后同样的算力还可以被用来同时探索成千上万个不同的假设。
这时候被放大的,就不只是模型的能力,还包括人类探索未知问题的速度。
我觉得这可能是AI接下来一个很值得关注的方向。
为什么科学研究很适合Agent
这也让我重新思考了现在大家都在做的AI Agent。
目前绝大部分Agent,本质上还是人先给出一个目标,然后AI完成执行。让它写一个程序、查一份资料、分析一张表格,或者帮你订一张机票,目标通常都是人定义好的。
科学研究会更进一步,因为实验做完以后,还需要根据结果决定下一步做什么。
一个方案失败了,是继续修改,还是换一个方向?一个异常结果是噪声,还是值得继续研究?有限的计算资源应该分配到哪些实验上?
这实际上形成了一个完整的反馈循环:
提出假设 → 实验 → 得到结果 → 再提出新的假设。
Coding Agent现在之所以发展得比较快,也和这个特点有关。程序写完以后,可以编译,可以运行测试,有非常明确的外部反馈告诉AI刚才做得对不对。
科学实验当然复杂得多,但如果一个研究领域同样能够提供比较清楚的反馈,它就很适合形成这样的Agent Loop。
Discovery Loop在官网上也专门强调,他们目前关注的是具有“可衡量结果”的Learning Loop。
这个限定其实很重要。
科学发现没有那么容易自动化
机器学习研究是比较理想的场景,因为很多实验只需要计算资源,结果也可以通过Benchmark快速验证。
但到了药物、生命科学或者材料研究,情况会复杂很多。
很多实验需要真实的实验设备,一次实验可能需要几天甚至几个月,结果也会受到大量现实因素影响。AI可以在一个小时里产生一万个药物分子,但这并不意味着现实中的实验室可以在一个小时里完成一万次验证。
所以我并不认为,只要模型再强一点、GPU再多一点,就可以把整个科学研究自动化。
另外还有一个我觉得更重要的问题。
如果未来AI真的能够非常便宜地产生大量假设和实验方案,那么真正稀缺的能力可能会继续往上移动。
什么问题值得研究?为什么这个结果值得关注?哪个看起来失败的实验其实隐藏着新的方向?一个结果到底只是统计意义上的提升,还是具有真正的科学价值?
这些问题未必能简单通过增加实验数量解决。
所以未来科学家的工作可能会发生变化,但很难简单理解为“AI把科学家替代了”。实验执行成本下降以后,问题定义、方向选择和判断的重要性反而可能进一步提高。
AI可以创造的价值,也许还有另外一种
过去几年,我们讨论AI对经济和就业的影响,经常会落到一个问题上:它最终能够替代多少工作?
这个问题当然很重要,因为企业现在投入AI,很大一部分目的就是提高生产率、降低成本。这也是AI能够快速商业化的基础。
但如果把时间拉得更长一点,我还是觉得,AI能够产生的价值不应该只用“减少多少人”来衡量。
过去100个人完成的工作,现在20个人完成,是很大的生产率进步。
但如果AI能够帮助科学家找到过去找不到的新药,设计过去无法设计的材料,或者让一个过去需要十年才能探索的问题,在更短的时间里找到答案,它产生的是另外一种价值。
后者并不一定比前者更容易实现,甚至可能困难得多。但从人工智能这项技术最终能够给人类带来什么来看,我还是更期待这样的应用。
Jeff Dean过去二十多年参与做的事情,很大程度上是在解决怎样把更多Compute变成更多Intelligence。从分布式计算、TPU、TensorFlow,一直到今天的大模型,都可以放在这条线上理解。
现在离开Google以后,他选择继续往后走一步,尝试把已经得到的Intelligence转换成更多Experiment,再看看这些Experiment最终能不能转换成更多Discovery。
这件事情最后能做到什么程度,目前还不知道。Discovery Loop也才刚刚成立,很多愿景距离真正落地还有很远。
但相比AI还能替我们完成多少已有的工作,我觉得这个问题确实更值得期待:
当我们已经拥有越来越多机器智能以后,能不能用它去解决一些过去人类没有能力解决的问题?
如果可以,AI下一阶段值得Scale的东西,就不只有模型和算力了。
科学发现本身,也可能成为Scaling的一部分。