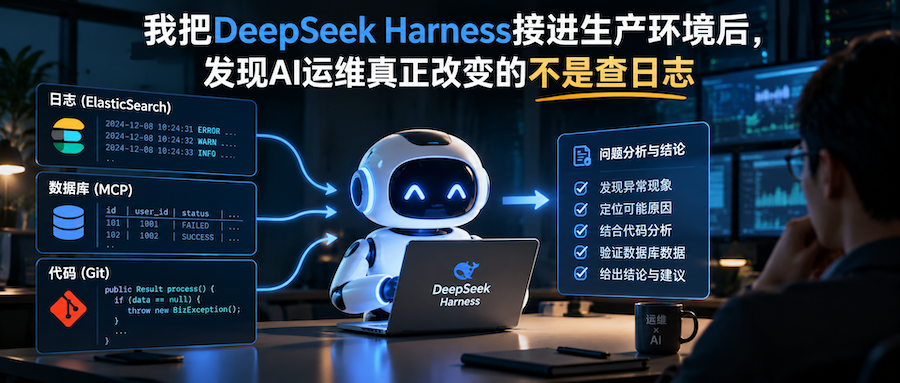
我最近在生产环境里做了一件以前不会太敢做的事情:给 AI 接上了线上日志、数据库和代码。
我的线上系统一直使用 ELK,应用日志最终都进入 Elasticsearch。平时出了问题,我会打开 Kibana,根据时间、接口、用户 ID 或关键字搜索日志。有时候日志只能告诉我“哪里报错了”,还得继续查数据库,看当时的数据状态;如果还不清楚,就再去代码仓库里找到对应的业务逻辑,一点点把问题串起来。
这其实是大多数程序员都很熟悉的排障方式。工具已经很好用了,日志也都在那里,但真正遇到线上故障的时候,还是得有一个人不断提出假设:先看看这个,再查查那个,然后根据得到的信息决定下一步去哪找。
最近我部署了 Elasticsearch 的 MCP 服务,又部署了数据库 MCP,同时在生产环境部署了 DeepSeek Harness,并给它一个只读账号读取 Git 代码仓库。
然后事情开始有点不一样了。
现在再遇到线上问题,我不一定需要先打开 Kibana。我可以直接在 DeepSeek Harness 里描述:“某个用户为什么调用这个接口失败?”或者“这个订单为什么一直停留在这个状态?”
接下来,它会自己去 Elasticsearch 找日志,发现某个业务 ID 后继续查询数据库,再根据异常位置去代码仓库看实现。如果原来的判断不成立,它还会回来重新查日志。
我自己的使用感受相当好。
一开始我以为,这只是把“人工查日志”变成了“AI 查日志”。用了几次以后,我发现真正省下来的并不是写几条 Elasticsearch 查询语句的时间,而是以前排障过程中最消耗人的那一段工作:不断寻找信息、建立关联、形成假设,再寻找新的证据。
这让我开始觉得,AI 对运维的影响,可能已经进入一个挺实际的阶段。
ELK已经把日志集中起来了,但调查故障的人一直没有变
很多公司这些年在可观测性上已经投入了不少钱。
应用日志进入 Elasticsearch,Kibana 用来检索;数据库有自己的管理工具;代码进入 Git;成熟一点的团队,还有 Prometheus、Grafana、APM、Tracing 和告警系统。
从“有没有数据”这个角度看,今天的软件系统其实已经比十年前透明得多。
可真正发生线上故障时,工作方式并没有发生同等程度的变化。
比如某个接口突然大量报错,我先在 Kibana 中按照时间范围查日志,发现错误可能和订单状态有关,再去数据库查这批订单。如果数据库中的某个字段异常,就回到代码看看这个字段在哪些地方会被修改,然后根据代码里的判断条件,再回 Elasticsearch 找另外一类日志。
这里面任何一个动作其实都不困难。
麻烦的是,没有一个系统知道下一步应该查什么。
Kibana 不知道数据库里某一行记录意味着什么,数据库也不知道哪段代码刚刚处理了它,Git 更不会因为看到一行代码,就主动跑去生产日志里验证自己的判断。
所以过去所谓的“可观测”,更多解决的是数据能不能被看到,却没有自动解决这些数据之间的关系。最后承担这个工作的,还是工程师的大脑。
这也是我这次使用 DeepSeek Harness 后最大的感受。
DeepSeek 官方把 Agent 描述为“Model + Harness”。模型负责理解和推理,Harness 则负责让模型使用工具、感知环境,并持续完成一个任务。
放到我的生产环境里很好理解:以前 AI 只能分析我复制给它的一段日志,现在它可以自己决定什么时候查 Elasticsearch,什么时候查数据库,什么时候去看代码。
这个差别其实很大。
MCP给AI增加的,并不只是更多上下文
很多人第一次接触 MCP,很容易把它理解成另一种插件系统:给大模型接几个工具,它就能查数据库、查 Elasticsearch。
这当然没错,但我觉得真正有价值的地方还在后面。
过去我把一段报错日志复制给 ChatGPT 或 DeepSeek,让它分析原因,模型只能在我提供的上下文里做判断。它如果缺少数据库状态,我要去查出来再复制进去;如果需要相关代码,我还要再把代码贴给它。
所以表面上是 AI 在分析,实际的调查流程依然是我在控制。
接入 MCP 后,关系变了。
我只需要提供最开始的问题,后续需要什么信息,可以由 Agent 自己决定。看到日志里的订单 ID,就调用数据库 MCP;怀疑某个条件判断有问题,就读取 Git 里的代码;代码里出现另一个关键字段,再回 Elasticsearch 搜索对应日志。
我更愿意把 MCP 在这里的作用理解为:它给了 AI 自己寻找证据的能力。
这也不是只有我在做这样的尝试。
Elastic 已经提供 Agent Builder 的 MCP Server,外部 Agent 可以直接调用 Elastic 的工具和数据;Grafana 也在通过 MCP 让 Agent 访问 dashboards、alerts、incidents 和数据源;Datadog 的 Bits Investigation 则会先形成关于故障原因的假设,再自动查询 metrics、logs、traces 和基础设施数据验证,如果证据不支持,就继续调整判断。
这条路线和过去“AI 帮我写一条查询语句”已经不是一回事了。
以前是人决定查什么,AI 帮忙执行;现在开始变成,人描述问题,Agent 自己决定需要哪些证据。
真正省下来的,是工程师寻找证据的时间
我以前排查线上问题,有一个很明显的感受:最花时间的往往不是解决问题。
很多时候,知道原因以后,真正的修改可能只有几行代码。
大量时间花在“不知道原因”。
你得先找到一条异常日志,然后沿着它往下追;发现一个字段不对,继续查数据库;看到一个状态异常,又去查这个状态由哪些代码修改;看到代码以后,再回过头验证线上究竟走了哪个分支。
资深工程师之所以通常比新人排障快,并不是因为他搜索 Kibana 的速度快几倍,而是因为他更知道下一步应该查哪里。
而这恰好是 Agent 很适合承担的一类工作。
Grafana 今年公开过一次内部真实事故,他们让 AI Assistant Investigations 和值班工程师同时调查。AI 大约 8 分钟找到根因,而工程师团队约 28 分钟后得出相同结论。
一个案例当然不能证明以后所有故障都能快 3.5 倍,但至少和我的实际体验能够互相印证:AI 在运维中最先有价值的部分,很可能就是第一轮 investigation。
我并不认为这意味着公司以后可以把 SRE 或运维团队裁掉。
运维还有发布、容量规划、架构治理、安全、应急决策,以及最重要的生产责任。这些都不会因为 Agent 会查日志就消失。
但如果一个资深工程师以前一次事故需要花半小时甚至几个小时搜集证据,而 Agent 能先完成其中相当一部分工作,那么节省下来的其实是很贵的人力时间。
至少在我自己的系统里,这已经不是一个概念了。
企业可能不需要再造一套“AIOps平台”
这次实践还有一点让我觉得挺有意思:为了让 AI 做这些事情,我其实没有重新建设自己的运维系统。
日志还是原来的 Elasticsearch,数据库还是原来的数据库,代码还是 Git。
我增加的只是 MCP 和 Harness。
这和过去很多企业做 AI 项目的思路不太一样。以前一说智能运维,很容易想到再建设一套 AIOps 平台,把各种日志和监控数据重新采集进去,再做分析、告警和预测。
Agent 这条路线更像是在现有基础设施上增加一个新的“使用者”。
原来的系统继续负责保存事实,MCP 把这些能力暴露出来,Harness 再决定什么时候调用哪个工具。
这可能会成为企业 Agent 落地一个很现实的方向。
很多企业其实并不缺数据。代码、客户、订单、日志、监控、知识库全部已经数字化了,只不过它们长期存在不同的软件里,而且这些软件过去主要是给人操作的。
当越来越多系统开始提供 MCP 或类似接口以后,企业未必需要先建设一套新的“AI 系统”。更现实的做法,可能是让 Agent 逐渐获得调用现有系统的能力。
生产运维只是其中一个很容易看到价值的场景。
我现在更愿意让AI“读生产”,而不是“改生产”
当然,这件事情还有一个不能绕过去的问题:权限。
我目前给 Elasticsearch、数据库和代码仓库的权限都尽量保持只读,这并不是偶然。
因为 Agent 一旦拥有生产系统权限,它犯错误的方式和普通聊天机器人已经完全不同。聊天机器人判断错了,最多告诉你一个错误答案;拥有数据库、Shell 或部署系统权限以后,一个错误判断可能真的变成生产事故。
DeepSeek 自己对此也说得很明确。目前 DeepSeek Harness 仍然是 developer preview,官方安全说明写明它还没有经过安全审计,不应被视为 production-ready;模型生成的命令、第三方插件,以及它能够访问的网络、文件和凭据,都可能带来风险。
所以我的实际使用,并不意味着我建议大家直接给 DeepSeek Harness 一个生产服务器的 root 权限。
恰恰相反。
至少现阶段,我更看好一种比较保守的 AI 运维方式:让 Agent 尽可能完整地“看”生产环境,但把“改”生产环境的权限留给人。
它可以读取日志、查询数据库、查看代码、分析监控、形成故障假设,最后告诉工程师:“我认为原因在这里,这是我找到的证据。”
至于是不是修改数据库、重启服务、回滚版本,还是由人确认。
这种方式听起来没有“全自动 SRE”那么性感,但我觉得更容易真正进入企业。
前几天再遇到一个线上问题时,我已经很自然地先打开了 DeepSeek Harness,而不是 Kibana。
这大概是我判断一个工具有没有真正改变工作方式时比较看重的信号:不是 Demo 看起来多厉害,而是发生问题时,我自己的第一反应开始变了。
ELK 这些年已经很好地解决了“生产环境发生了什么”。现在 MCP 和 Agent Harness 正在尝试解决下一件事:当所有证据都在那里以后,谁来把它们找出来并拼在一起。
过去这个人通常是一个有经验的工程师。
现在,至少第一轮调查,我已经开始愿意先交给 AI 了。
[…] 于是我让部署在生产环境里的 DeepSeek Harness 去查日志。现在我的运维方式已经和以前很不一样了,不需要先打开 Kibana,根据时间、用户 ID、关键字一点点搜索,而是直接告诉 Harness:客户消息发送失败,重点检查消息发送回调相关的日志。 […]
[…] DeepSeek Harness 提了一个要求:通过 MCP […]