GPT-6 Sol和Luna发布以后,我第一眼看的并不是Benchmark,而是价格。
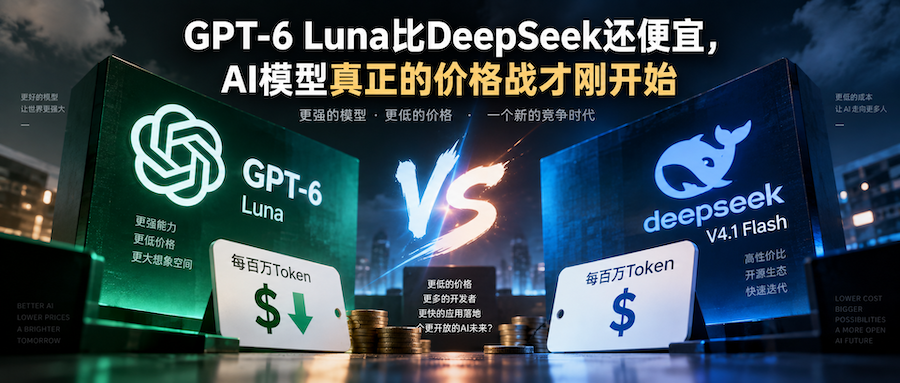
GPT-6 Luna,100万输入Token 0.1美元,输出0.5美元。
我又回头看了一下两周前刚刚发布的DeepSeek V4.1 Flash。即使按照空闲时段计算,缓存未命中的输入也要0.15美元,输出0.6美元;高峰时段则分别是0.3美元和1.2美元。换成人民币,DeepSeek空闲时段是每百万输入Token 1元、输出4元,高峰时段是2元和8元。
也就是说,至少按照最普通的API价格计算,GPT-6 Luna已经比DeepSeek V4.1 Flash便宜了。
这个结果挺出乎我意料。
过去两年,中国开放权重模型与OpenAI、Anthropic这些美国闭源模型之间,已经形成了一个很容易理解的市场印象:最好的模型还是美国公司做,但如果你需要大量调用、特别在意成本,DeepSeek、Kimi、GLM这一类中国模型会便宜很多。
现在OpenAI自己把这个价格差打掉了。
但我后来仔细算了一下,发现事情又没有“OpenAI终于比DeepSeek便宜”这么简单。因为当AI开始从聊天工具变成可以连续工作几个小时的Agent以后,我们以前习惯用来比较模型价格的“每百万Token多少钱”,可能已经不太够用了。
GPT-6这次最值得看的,其实是价格
9月22日,OpenAI发布GPT-6 Sol和Luna。Sol的API价格降到每百万输入Token 2美元、输出10美元;Luna则是0.1美元和0.5美元。OpenAI把这次调整概括为相比GPT-5.6促销价格大约降低一半,并明确提到,缓存和推理基础设施效率改善,让它可以把成本下降传递给用户。
这与过去几次新模型发布给我的感觉不太一样。
通常新一代模型出来,大家首先讨论的是又提高了多少Benchmark、数学题提高多少、代码能力超过谁。但GPT-6 Sol和Luna这一次,至少从第三方测试看,能力并没有出现与价格变化同等幅度的跃迁。
Artificial Analysis的测试中,GPT-6 Luna在Coding Agent Index上得到41分,比GPT-5.6 Luna还低2分;但它完成同一套测试的任务成本下降了大约60%。Artificial Analysis因此把这次发布最明显的变化总结为成本效率,而不是智能指标全面跃升。
这并不是说GPT-6没有进步。OpenAI自己的DeepSWE v1.1测试里,Luna在max effort下达到66.6%,Sol达到68.8%,已经是很能干的Coding Agent模型。
只是我更在意另一件事情:OpenAI开始主动把一个能力相当不错的模型,卖到了过去只有中国低价模型才会出现的价格区间。
这意味着“美国模型贵、中国模型便宜”这个过去相当好用的判断,已经开始失效。
0.1美元是真的,但“更便宜”没那么简单
如果只看官网价格表,Luna确实赢了。
GPT-6 Luna普通输入是0.1美元,DeepSeek V4.1 Flash空闲时段是0.15美元;输出则是0.5美元对0.6美元。到了DeepSeek高峰时段,差距还会扩大到0.1美元对0.3美元、0.5美元对1.2美元。
但Agent最有意思的地方,恰恰是大量输入并不是第一次出现。
比如一个Coding Agent工作时,会不断读取项目代码、系统提示词、工具定义、AGENTS.md、之前的对话和执行结果。这些内容下一轮往往还要继续使用,所以Prompt Cache,也就是把已经处理过的上下文缓存起来重复利用,会越来越重要。
这时候DeepSeek的优势又回来了。
GPT-6 Luna缓存读取的价格是每百万Token 0.01美元,而DeepSeek V4.1 Flash空闲时只有0.003美元,高峰也只有0.006美元。OpenAI还对第一次写入缓存收取普通输入价格的1.25倍,也就是Luna每百万Token 0.125美元。
长上下文也一样。GPT-6 Luna虽然提供105万Token上下文,但输入一旦超过272K Token,整个请求的输入和缓存价格都会变成两倍,输出价格则提高50%。
举一个很简单的例子。假设一个长任务需要100万输入Token,再生成10万Token,而且完全没有缓存命中,那么GPT-6 Luna大约需要0.275美元;DeepSeek V4.1 Flash空闲时大约0.21美元,高峰时则是0.42美元。
于是一个看似很简单的“谁便宜”,突然有了三个答案。
短任务可能Luna便宜;大规模长上下文任务,DeepSeek空闲时可能更便宜;到了高峰时段,结果又反过来。
这也是我觉得这次价格变化真正有意思的地方。以后再拿两个模型比较,只看官网上那两个醒目的input/output数字,很可能会越来越不准确。
Agent正在改变“模型价格”这件事
我现在日常开发里,95%以上的代码已经交给AI完成。之前做DoseLoop的时候,甚至做到了100%由AI生成代码,我自己没有手写。
这种使用方式和在ChatGPT里问一个问题差别很大。Coding Agent会自己读文件、搜索代码、调用工具、修改、运行测试,失败以后再回去检查,然后继续修改。一个任务跑几十轮并不奇怪。
所以我现在看模型价格,越来越少问“100万Token多少钱”,而是会问另一个问题:
这件事情让它做完,到底多少钱?
OpenAI这次发布GPT-6时公布了一个很能说明问题的数据:按照API价格折算,它内部研究人员使用Coding Agent产生的每日Token消费,中位数已经超过600美元,90分位超过7000美元。这里当然不是说OpenAI真的每天向员工收7000美元,而是用公开API价格衡量内部消耗量。它真正说明的是,当Agent开始持续工作后,单个用户能够消耗的Token规模和聊天时代完全不是一个数量级。
DeepSeek显然也看到了同一个问题。
V4.1 Flash用了552B参数的MoE架构,但输入阶段每个Token只激活约8B参数,输出阶段约16B;更关键的是,它把KV Cache对HBM的需求压到上一代的1/4,对SSD的需求压到1/8。DeepSeek自己解释得很直接:Agent场景中,缓存命中的费用往往占比较高,所以压缩KV Cache就是在降低Agent长期运行的成本。
两家公司走的技术路线不同,但最后解决的其实是同一道商业问题:怎样让AI持续工作变得足够便宜。
过去模型调用更接近买一次答案,现在越来越像租一名按计算量收费的数字员工。它可能连续干几个小时,中间不停读取上下文、调用工具和尝试解决问题。到了这一步,模型公司即使把每个Token的价格降一半,只要Token消费量扩大几倍,整个市场反而可能更大。
所以我并不认为OpenAI这次降价只是简单的价格竞争。它更像是在为Agent时代提前重新定价。
当“便宜”不再属于DeepSeek,开放权重反而要重新证明自己的价值
这件事情对DeepSeek也提出了一个挺有意思的问题。
如果以后OpenAI、Google这些公司都能把低成本模型做到每百万Token几毛钱甚至更低,那么开放权重模型还能靠什么竞争?
DeepSeek V4.1 Flash是一个552B参数、支持100万Token上下文的开放权重模型,采用MIT许可证,可以下载、自行部署和修改。
当然,这里也不能把“开放权重”理解成普通公司下载以后找几张GPU就能跑。552B参数仍然是一个很大的模型,DeepSeek自己在谈大规模部署时,甚至举过“2000张GPU加存储集群”的例子。
但开放的意义本来也不应该只等同于便宜。
它意味着企业可以决定模型运行在哪里,数据留在哪里,选择什么推理框架,怎样优化自己的Harness,以及未来要不要从某一家云和API服务商迁走。
过去这些价值很容易被“DeepSeek便宜十倍”这个更简单的故事盖住。现在如果闭源模型的Token价格也被压下来,开放权重真正的价值反而会变得更清楚。
API价格是最容易复制的竞争优势之一。今天DeepSeek降价,明天OpenAI可以降;OpenAI降完以后,Google也可以继续跟。
但控制权没这么容易复制。
下一轮价格战,要算的是“完成一件事多少钱”
所以GPT-6 Luna出来以后,我越来越觉得,AI模型接下来的价格比较需要换一个单位。
以后企业选模型,至少要同时看Token价格、一个任务需要多少Token、缓存命中率、长上下文收费、推理强度,以及最终任务成功率。
一个模型每百万Token只要0.1美元,如果它需要尝试五次才能把程序改对,未必比一个0.3美元、一次完成的模型便宜。反过来也一样,一个旗舰模型能力可能强10%,但价格高20倍,如果任务只是批量改代码、整理文档或者执行已经拆解好的步骤,这10%的能力未必值得。
这其实也是我自己使用AI Coding越来越明显的感受。我并不需要所有任务都交给最强模型。真正复杂的架构、判断和任务拆解可以用更强的模型,大量执行工作完全可以交给Luna、DeepSeek Flash这一类便宜得多的模型。模型越来越多以后,“选一个最好的模型”本身可能就是个错误问题,更现实的方式是按照任务动态分配。
回到最开始那个0.1美元。
GPT-6 Luna确实已经比DeepSeek V4.1 Flash普通Token的牌价更低,这件事情放在一年前,我大概很难想到。
但看完缓存、长上下文和Agent的实际消耗以后,我反而觉得,“OpenAI比DeepSeek便宜了”并不是这次变化最重要的结论。
它更像一个信号:当每百万Token的价格开始被压到足够低以后,单纯卖便宜Token会越来越难成为一家模型公司的长期优势。
接下来真正要比的,是同样花一块钱,谁能让AI完成更多真实工作。
如果这个变化继续下去,AI模型的价格战确实才刚刚开始。只是下一轮的价格标签,可能不会再简单写着“每百万Token多少钱”。