红果短剧月活4.1亿,为什么AI更容易做成流量生意?
最近看到QuestMobile的一组数据,我停下来想了很久。2026年8月,红果短剧(红果免费短剧)的月活跃用 […]
AI写代码已经不稀奇了,真正的变化是很多东西突然值得做了
AI写代码已经不稀奇,更大的变化是软件实现成本正在快速下降。过去因开发成本太高而“不值得做”的小需求,如今可能几小时就能变成可用工具。当“怎么做”越来越便宜,发现什么值得做、如何设定边界并判断价值,反而会变得更重要。
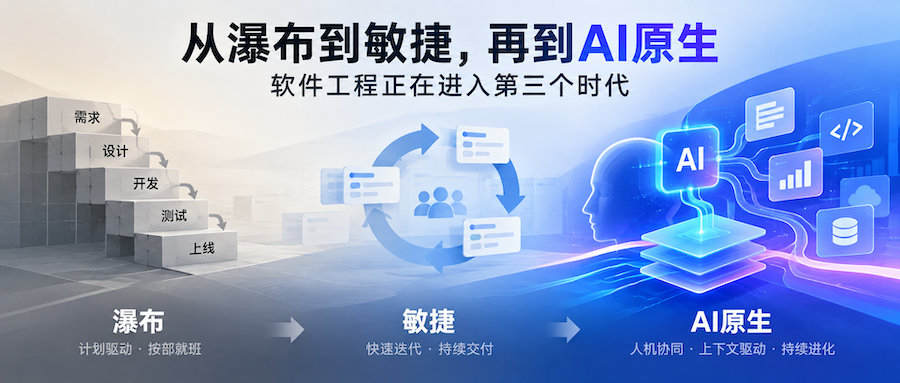
从瀑布到敏捷,再到AI原生:软件工程正在进入第三个时代
我做了20多年软件,经历瀑布和敏捷后越来越明显地感到:AI改变的并不只是Coding速度,而是整个软件工程。未来真正稀缺的,将是高质量Context、人的Judgment,以及可靠的Verification。
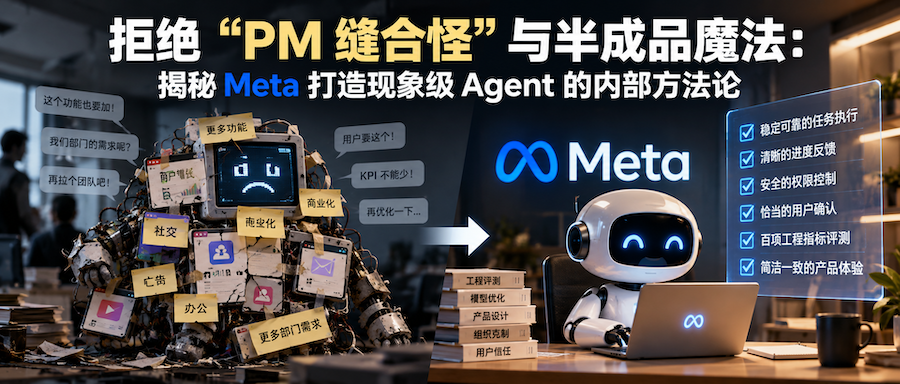
拒绝“PM 缝合怪”与半成品魔法:揭秘 Meta 打造现象级 Agent 的内部方法论
Meta 用七个月打磨 Muse 证明,个人 Agent 真正的门槛不是偶发的“魔法时刻”,而是把大模型的非确定性收敛进可控、稳定的工程体系。百项指标、严格评测、克制组织与统一产品审美,才是用户愿意持续托付真实任务的关键。
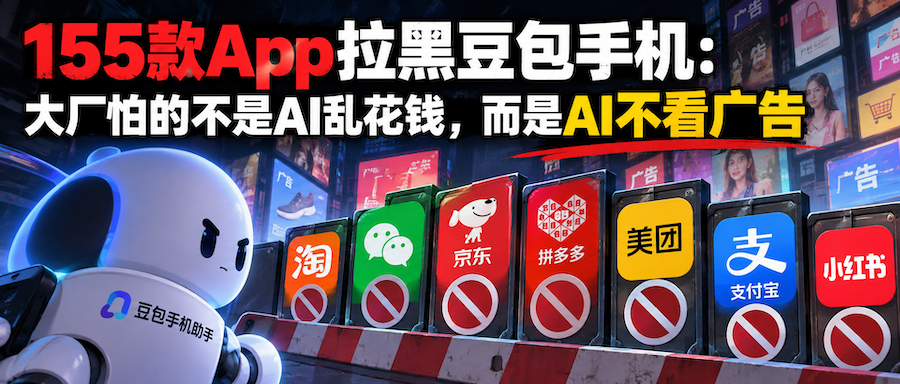
155款App拉黑豆包手机:大厂怕的不是AI乱花钱,而是AI不看广告
微信、淘宝等155款应用集体拒接豆包手机助手。尽管豆包SAEP协议已提供“只浏览不付款”的精细安全锁,巨头仍选择全盘拉黑。这揭示出大厂真正防御的并非交易风险,而是AI替人跳过浏览比价过程,直接抽空超级App的广告变现根基与流量主权。
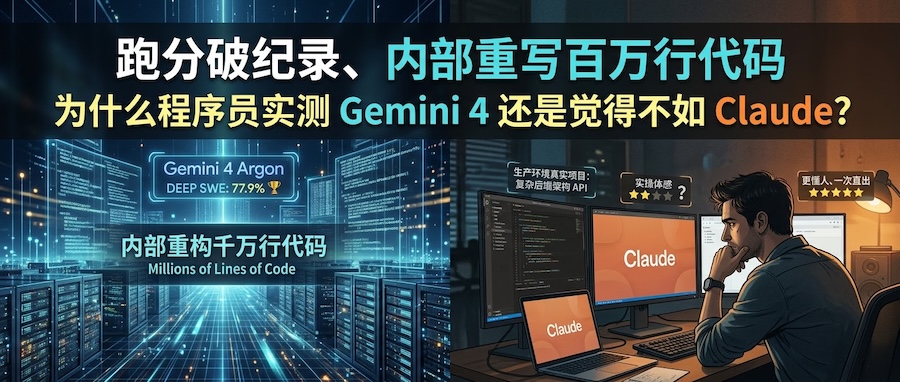
跑分破纪录、内部重写百万行代码,为什么程序员实测 Gemini 4 还是觉得不如 Claude?
Gemini 4 Argon跑分登顶,实测单次编码却逊于Claude。这源于路线分化:后者胜在单次直出精度,而百万输出、低价缓存的前者专为多轮验证流水线打造。建议用Claude攻坚复杂架构,让文风清爽的Argon接管长文档与日常工作。
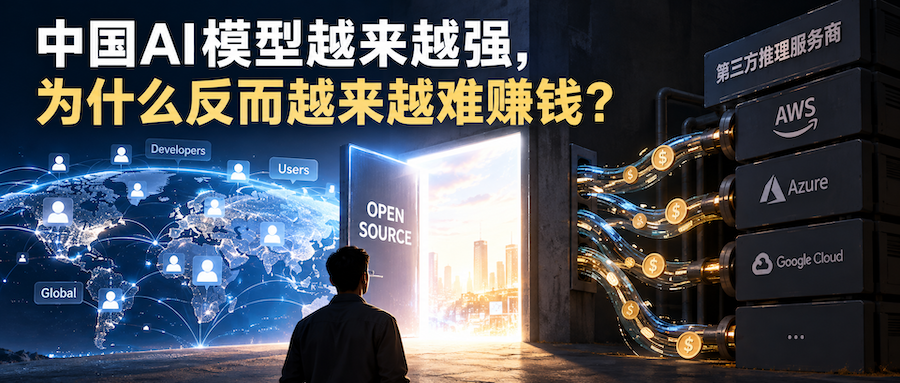
中国AI模型越来越强,为什么反而越来越难赚钱?
中国AI模型越来越强,商业化却未必更容易。Epoch AI数据显示,开放权重扩大了DeepSeek、GLM等模型的生态,也削弱了原厂定价权。大模型商业化真正的难题,是如何把使用量重新转化为收入。
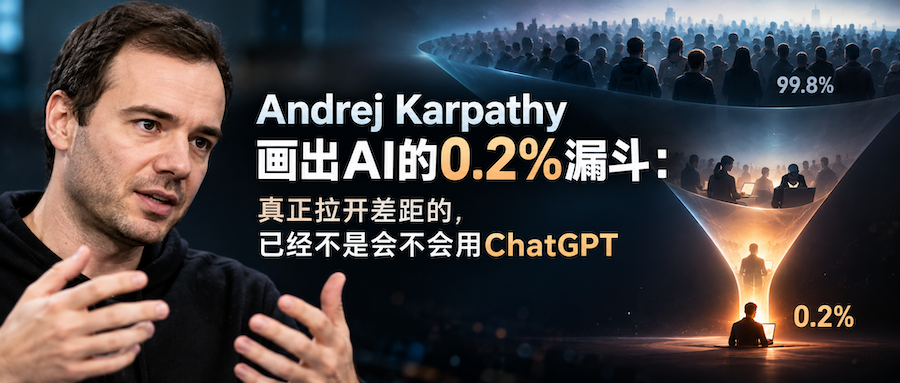
Andrej Karpathy画出AI的0.2%漏斗:真正拉开差距的,已经不是会不会用ChatGPT
Karpathy提出AI能力正在形成越来越尖锐的“漏斗”:多数人还把AI当聊天工具,少数人已用Agent重构完整工作流。真正拉开差距的,可能不再是会不会用ChatGPT,而是谁先形成AI Native思维,把更大的问题交给AI。
AI 有没有意识还没定论,Anthropic 为什么先限制虐待它?
Anthropic 将持续且无必要的模型虐待写入新版使用政策,AI 意识仍无定论。沿着模型福利研究、退出对话功能到用户规则的路径,分析有限预防的理由、证据局限及用户需要关注的执行边界。
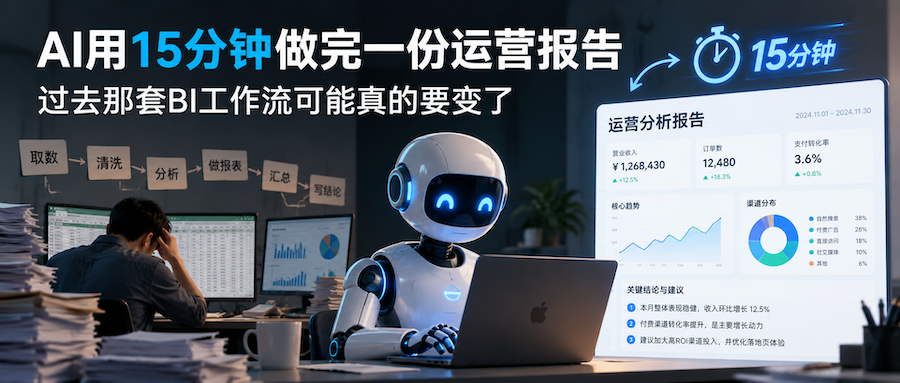
AI用15分钟做完一份运营报告,过去那套BI工作流可能真的要变了
AI数据分析正在改变传统BI工作流。我用DeepSeek Harness通过MCP连接生产数据库,15分钟生成了一份运营报告,并由此发现:最先被AI压缩的,可能是企业大量重复的报表生产工作。
中美AI竞争真正的胜负手,不是谁的模型更强,而是谁先让AI研究AI
中美AI竞争正在从模型能力转向研发速度。AI已开始参与下一代AI的研发,但完整RSI尚未实现。真正的胜负,不只是谁先让AI研究AI,更是谁能把这种技术加速度转化为产业生产率和经济增长。
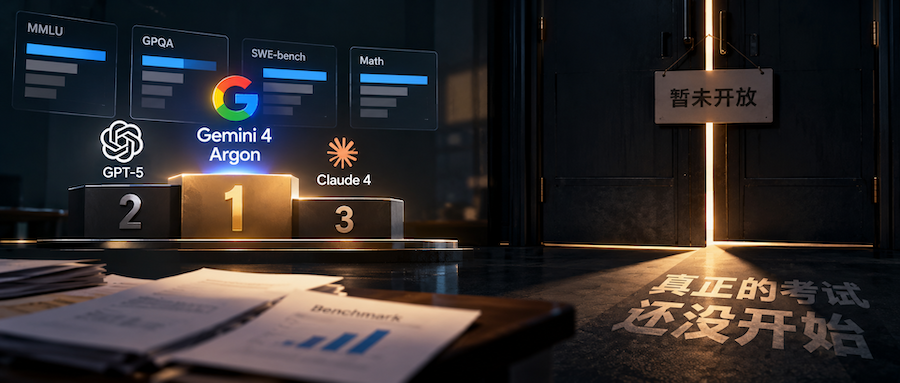
Gemini 4 Argon已经开始赢跑分了,但真正的考试还没开始
Gemini 4 Argon在多项Benchmark中进入第一梯队,却尚未向普通用户开放。Google称这是出于安全考虑,但在GPT和Claude密集更新的竞争压力下,这种“先发布、后开放”的方式也值得关注。跑分已经赢了一部分,真正的考试仍要等到真实用户手里。
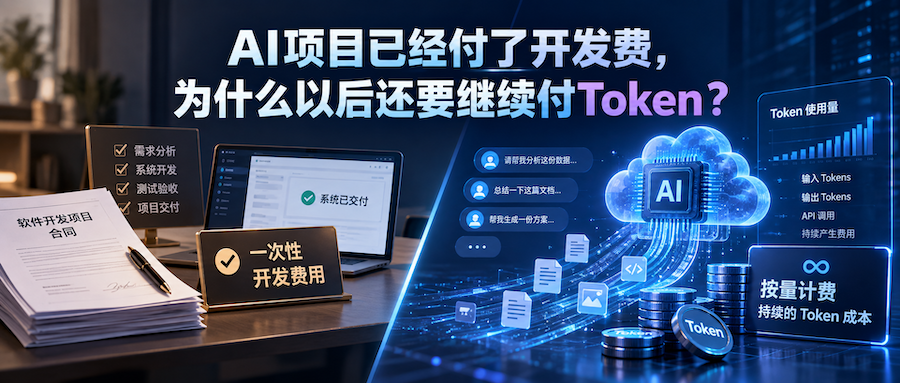
AI项目已经付了开发费,为什么以后还要继续付Token?
AI项目和传统软件最大的成本差异之一,是上线后还会持续产生模型调用费用。Token本质上是“智能使用量”的计量单位,企业真正需要理解的,不是Token本身,而是AI项目已经从一次性建设成本,变成“建设成本+持续智能成本”。
星宇股份劝退107名应届生,真正该为企业犯错买单的是谁?
星宇股份劝退107名应届生,引发的不只是劳动争议,更暴露了企业收益与风险分配的不对称:经营成功时,收益更多流向股东和管理层;决策失误时,普通员工却往往最先承担成本。真正成熟的市场规则,应让决策权、收益权与责任尽量匹配。