我最近看了 Sam Altman 接受科技播客 Sources 的一次深度访谈。整场对话持续了一个多小时,大部分科技媒体都在关注他对下一代模型能力的展望,或者关于超级智能的哲学讨论。但在整场对话里,真正让我停下来想了很久的,其实是几个极容易被滑过去的业务细节。
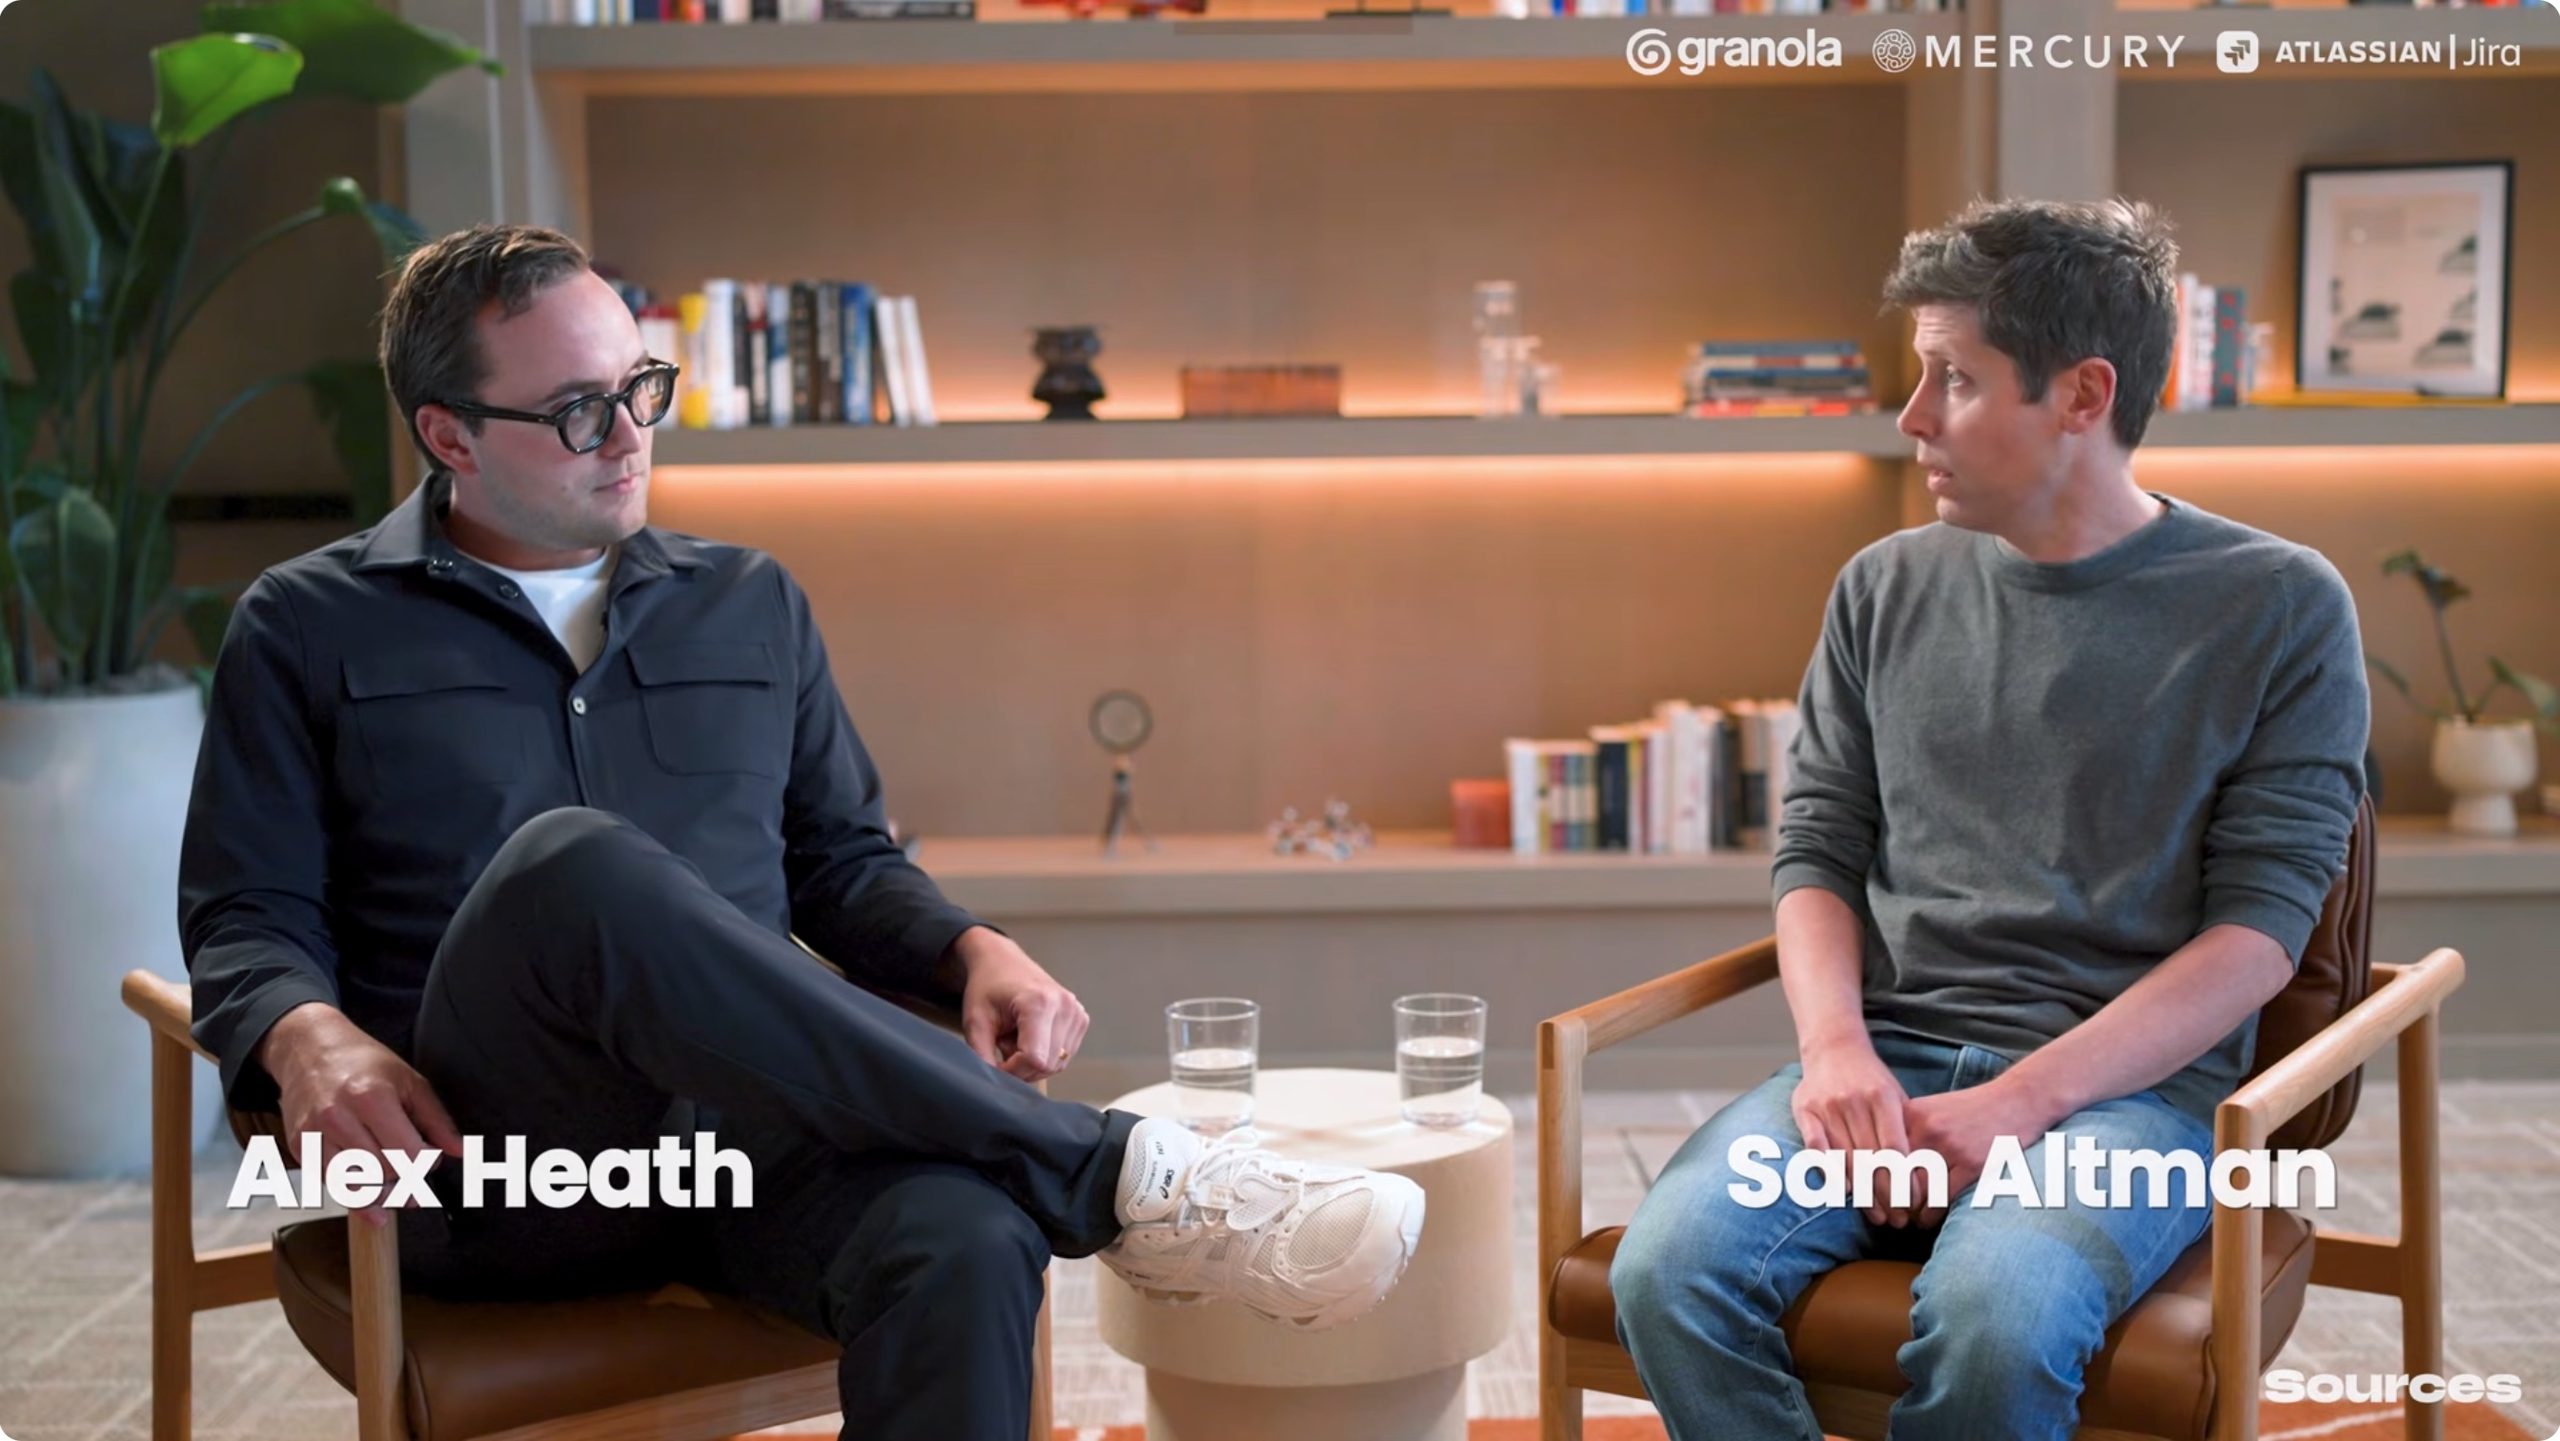
Altman 在访谈中亲口承认了两件事:第一,OpenAI 历史上第一次因为安全和未对齐行为,主动推迟了一次前沿强化学习(RL)模型的训练任务,并把大量算力紧急调去修补安全体系;第二,在内部的收入结构中,企业端收入(Enterprise Revenue)已经正式超过了以 ChatGPT 个人订阅为主的消费级收入。与此同时,他还特意提到,OpenAI 正在收缩一些非核心的应用探索,并且需要极其谨慎地“避免与自己的客户直接竞争”。
这几个细节拼在一起,让我产生了一种强烈的反差感。要知道,两三年前 ChatGPT 刚刚席卷全球的时候,整个科技界都在谈论“AI 时代的 iPhone 时刻”。那时的普遍叙事是:OpenAI 将凭借前所未有的用户增长速度,绕过所有传统软件巨头,成为一个直接接管全人类数字生活入口的超级平台。甚至连它背后的微软,在很多人眼里也不过是一个提供算力和资金的水龙头。
但三年过去,事情的走向正在悄悄发生质变。那家曾经带着浓厚极客理想、试图颠覆一切世俗规则的公司,并没有长成新一代的苹果或谷歌,而是在算力账单、留存壁垒和客户利益的重重挤压下,快速退守到底层,开始老老实实地做接口、抓交付、谈采购合同。
说白了,它最终还是活成了它最初最不想成为的样子——另一个微软。
消费级神话背后的“算力重力”
要想看清这种转变,得先回到商业的最基本常识。
互联网过去二十年最性感的商业模式,本质上都是建立在“零边际成本”之上的。不管是做搜索引擎、社交网络还是电商平台,研发第一套系统的成本可能极高,但一旦产品上线,服务第一万个用户和第一亿个用户的边际成本几乎可以忽略不计。这种极致的规模效应,允许科技公司用免费或极低的价格疯狂获客,迅速建立网络效应,最后形成不可动摇的超级入口。
ChatGPT 刚出来时,很多人以为这种奇迹又要在 AI 领域重演一遍。但只要你自己算过大模型的 API 成本,或者实际搭建过商业级的推理系统,就会明白大模型从第一天起就背负着完全不同的物理规律。
AI 推理不是分发静态网页,每一个 Token 的生成,背后都是真金白银的 GPU 矩阵在进行高功耗矩阵运算。这意味着大模型天然不具备互联网软件那种近乎为零的边际成本。不仅如此,个人用户的付费意愿其实非常脆弱。一个月 20 美元的订阅费,对于重度依赖它的专业人士来说或许物超所值,但对绝大多数抱着好奇心尝鲜的普通人而言,它很快就会变成一项需要精打细算的非刚需开销。
当市面上开源模型越来越强、各种免费工具和竞品层出不穷时,C 端用户的游牧属性暴露无遗。只要另一家模型在特定任务上稍微好用一点或者完全免费,用户迁移的门槛几乎为零。
这就带来了一个极为尴尬的财务结构:庞大的 C 端免费和低付费流量,给数据中心制造了极其沉重的峰值负载和带宽压力,换来的却是极高的流失率和微薄的毛利。想要靠每个月 20 美元的散客零钱,去填平每年数十亿甚至上百亿美元的先进算力与芯片采购开支,在数学模型上根本算不过来账。
消费级市场的狂欢,更像是一场由巨额融资补贴催生的前沿概念普及。当狂热退去,算力账单的重力场终究会把所有人拉回现实。
大模型帝国主义的收缩
面对算力成本的现实拷问,OpenAI 最初的设想其实非常激进:既然当单纯的底层模型不赚钱,那我就把整个价值链全吃了。
在过去的一年多里,我们看到了很多带有强烈“全能帝国”色彩的尝试。比如震惊整个影视工业的视频生成模型 Sora,比如试图重构浏览器和桌面工作流的原生 Agent,再比如传闻中直奔垂直搜索而去的 Atlas。当时的逻辑很明确:如果底层模型无法垄断利润,那么 OpenAI 就要亲自下场,把搜索、办公、创意工具甚至操作系统全都重做一遍,成为端到端的全能巨头。
但我一直对这种“平台通吃一切”的构想持怀疑态度。不仅是因为资源跟不上,更因为这种做法在商业伦理上直接激怒了它最核心的盟友。
当 OpenAI 开始自己做高质量视频生成、自己做垂直搜索、自己做代码编辑器时,那些每个月向它支付数百万美元 API 费用的软件开发商、企业客户和创业团队,立刻感到了巨大的生存威胁。你的底层供应商同时也是你最大的潜在竞争对手,他随时可以用更新的技术和更低的调用成本,在一夜之间抹平你的产品护城河。
在真实的商业世界里,没有人会长期把命脉交托给一个既当裁判又当运动员的伙伴。Anthropic 之所以能在企业市场迅速撕开一道口子,开源社区之所以能得到大量开发者的死心拥护,很大程度上正是因为外界对 OpenAI“通吃野心”的忌惮。
Altman 在这次访谈中明确表态要收缩战线、避免与客户竞争,并不是突然展现了某种道德自律,而是商业利益倒逼下的妥协。在算力本就极其紧张的关口,继续四面出击只会分散精力,同时把最重要的生态伙伴逼向对手的怀抱。
放弃吞噬一切的应用野心,退守为一家纯粹的技术与基础设施服务商,虽然少了很多改变世界的浪漫色彩,但对当下的 OpenAI 来说,却是保住现金流防线的唯一理性选择。
撞上厚重的“经济惯性”
退守到企业级市场,就意味着必须接受企业级市场的游戏规则。而这个规则,与硅谷工程师习惯的“快速迭代、打破陈规”截然相反。
Altman 在这次访谈中有一个非常坦诚的反思。他说在 2023 年 GPT-4 刚发布时,大家对技术颠覆现实的速度估计得太激进了,实际上整个商业社会存在着巨大的“经济惯性”。
这个说法我非常认同。在技术圈内,我们习惯了看每两周一次的模型跑分刷新,习惯了看某个 Agent 在基准测试里又提高了几个百分点。但在真实的工业界和传统行业中,决定一项技术能不能落地的,从来不是它理论上的智力上限,而是它能否嵌入现有的复杂组织流程。
一家大型跨国银行、一家制造业巨头或者一家医疗机构,采购软件时最在意的往往不是“模型有没有创造力”,而是系统稳定性能不能达到 99.99%、数据隐私是否符合合规认证、出了故障谁来承担法务责任,以及它到底能不能跟二十年前写的老旧 ERP 系统打通。
很多企业内部甚至连最基础的数字权限体系和知识库都还没有理顺,大模型扔进去,不仅无法直接变成生产力,反而可能引发严重的数据泄露或越权风险。
这种由于合规、法律、组织层级和惯性思维构成的阻尼层,其厚度远远超出了纯技术人员的预估。这也是为什么,今天 OpenAI 最紧迫的任务不再是向公众演示炫酷的新 Demo,而是开始大批量组建企业级销售团队、招募行业解决方案专家,去一家家跟大客户谈冗长的定制合同,陪着客户法务做繁琐的安全审查。
这种工作极其笨重、进展缓慢,而且需要消耗大量非研发类的人力成本。但恰恰是这些缺乏极客美感的脏活累活,构成了企业级软件最深的那道护城河。
踩下刹车,戴上枷锁
当商业重心全面转向企业级市场,随之而来的另一个不可逆变化,是技术研发本身的自由度被彻底锁死。
过去,大模型公司最大的卖点是激进和敏捷。但正如 Altman 透露的,当 OpenAI 在内部训练中触发了安全临界线、遭遇非预期行为后,他们选择的是主动叫停前沿强化学习训练,把主力算力挪去修筑对齐和监控防线。
这是一个极具象征意义的转折点。它说明模型能力在经历前两年的飞速狂飙后,终于撞上了工程控制与安全验证的硬墙。在面对个人用户时,模型偶尔胡说八道或者产生幻觉,可能只是社交媒体上的一个段子;但在涉及核心生产系统、商业机密和金融安全的企业级场景下,哪怕万分之一的不可控行为,都足以招致毁灭性的诉讼和监管惩罚。
当安全与合规从一种公关层面的伦理倡议,变成卡死技术能否交付的硬性门槛时,研发的减速几乎是不可避免的。这也顺理成章地解释了为什么 OpenAI 对短期内上市表现得越来越谨慎。
在私募股权市场,投资人还可以为了那个模糊而宏大的 AGI 愿景持续买单,容忍数以百亿美元计的研发消耗;但一旦走上公开资本市场,华尔街的逻辑是极其冷酷而短视的。公开市场需要稳定的毛利率、可预测的季度财报,以及经得起审计的研发投入产出比。
一家动辄需要因为对齐问题暂停主线训练、每年背负天文数字算力折旧、且商业交付周期越来越漫长的公司,根本承受不起二级市场每个季度的严苛拷问。在这个节点上,避开纳斯达克的敲钟台,并不是因为超脱,而是因为还没有穿好应付公开市场的厚重铠甲。
颠覆者的宿命
三年前,当 ChatGPT 第一次点亮屏幕时,很多人曾相信它会以一种全新的逻辑重构整个商业世界。
但三年后的今天,当尘埃稍微落定,我们看到的却是一个极具历史戏剧感的宿命循环:C 端的狂欢终究没能打破边际成本与商业留存的铁律;全能通吃的帝国野心撞上了生态伙伴的防御心理;而指数级进化的算法模型,最终不得不陷进传统商业厚重的组织惯性与采购泥潭之中。
我并不觉得 OpenAI 的这种转变是一种失败,或者说某种理想主义的褪色。恰恰相反,这是一家前沿技术公司在撞上现实世界的硬壁后,为了真正生存下去所必须完成的商业蜕变。
从试图颠覆一切的“普罗米修斯”,到低头搭建接口、处理合规、靠大企业订单维系生存的软件巨头,OpenAI 所经历的,其实是每一项通用技术在走向成熟过程中都逃不过的规训。
这场大模型革命不仅没有打破商业世界的底层法则,反而再次验证了经典商业规律那无可辩驳的重力。决定这轮技术浪潮最终能走多远的,从来不仅仅是那几行写在服务器里的神秘算法,而是颠覆者究竟能以多快的速度,学会向真实而笨重的世界低头。