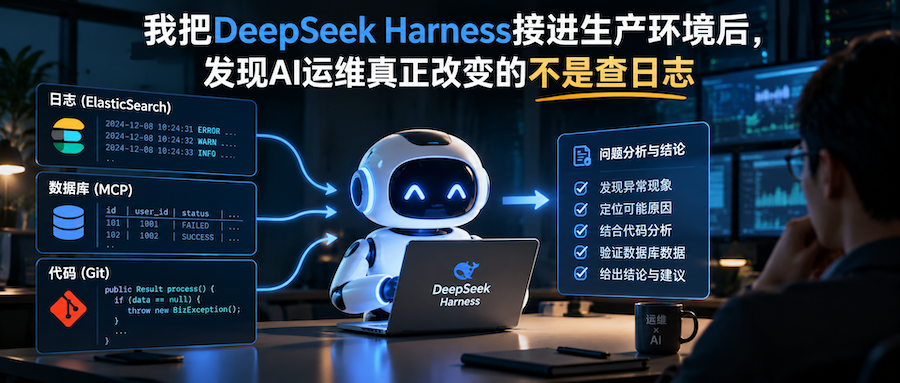
我把DeepSeek Harness接进生产环境后,发现AI运维真正改变的不是查日志
我把DeepSeek Harness接入生产环境,让它通过MCP读取日志、数据库和代码后,线上排障从“人找证据”变成了“Agent先调查”。AI运维真正开始落地的,可能不是自动修复,而是先自动完成第一轮故障分析。
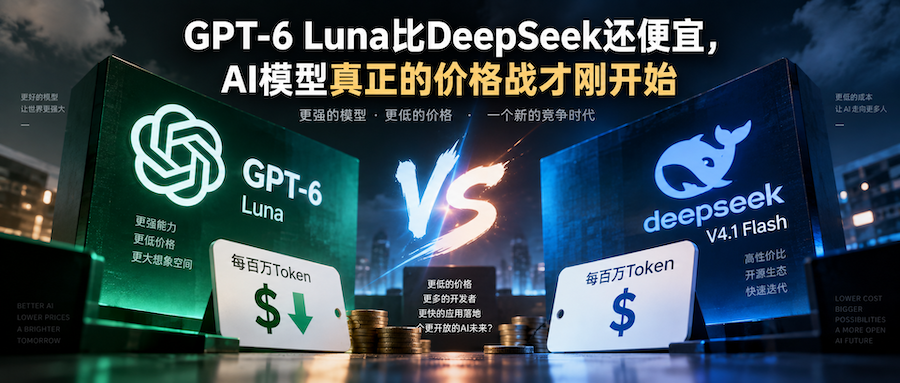
GPT-6 Luna比DeepSeek还便宜,AI模型真正的价格战才刚开始
GPT-6 Luna将普通Token价格压到DeepSeek V4.1 Flash之下,但缓存、长上下文和Agent运行成本让“谁更便宜”变得复杂。AI模型价格战正从每百万Token单价,转向完成一个真实任务到底要花多少钱。
DeepSeek终于能看图了,但真正补上的不是多模态
DeepSeek推出V4 Flash Vision,看起来只是补上了视觉能力,但真正重要的是,它开始让Agent具备感知环境、观察执行结果并继续行动的能力。从V4、Harness到Vision,DeepSeek正在把模型从“会回答问题”推进到“能真正把事情做完”。
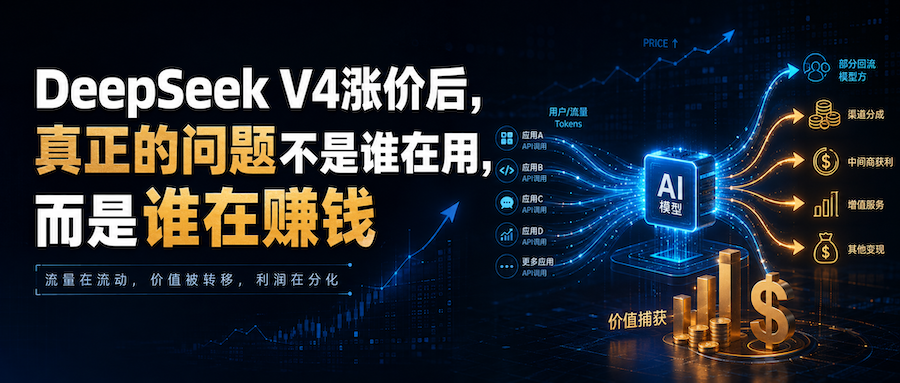
DeepSeek V4涨价后,真正的问题不是谁在用,而是谁在赚钱
DeepSeek V4涨价后,部分平台调用量明显下降,但模型仍占据高位。真正值得关注的,不是还有多少人在用DeepSeek,而是这些调用的钱最终流向谁。开放权重能迅速做大生态,却也让模型份额、官方API份额与公司收入逐渐分离。
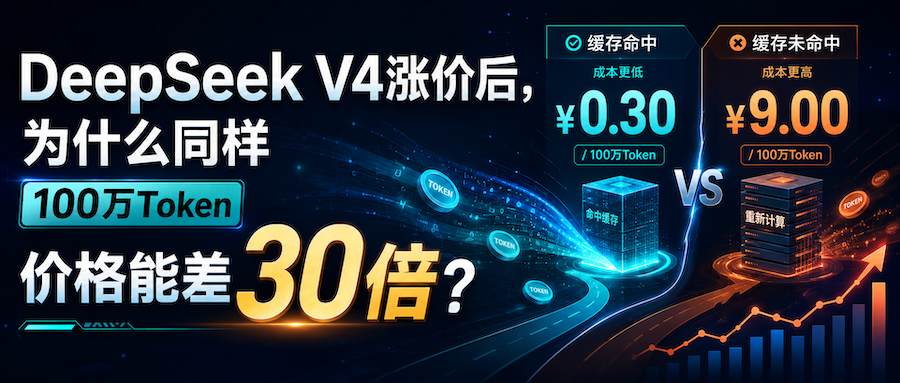
DeepSeek V4涨价后,为什么同样100万Token价格能差30倍?
DeepSeek V4涨价后,同样100万输入Token,缓存命中与未命中价格最高可相差30倍。进入Agent时代,模型真实成本已不只取决于Token单价,缓存命中率、上下文管理和Harness设计,正成为决定AI使用成本的新变量。
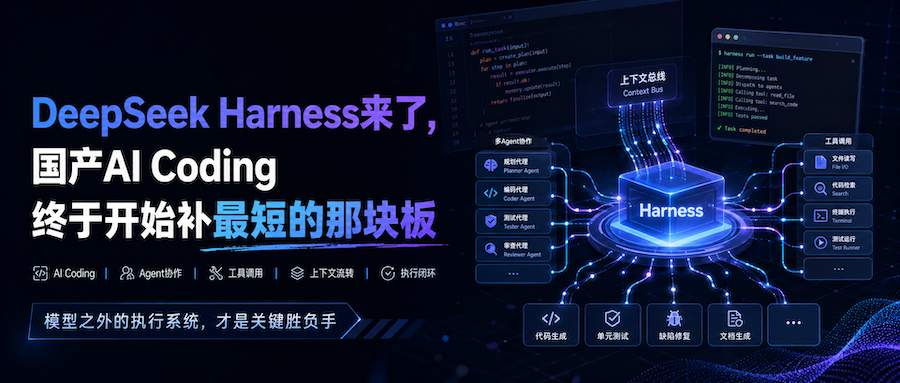
DeepSeek Harness来了,国产AI Coding终于开始补最短的那块板
DeepSeek Harness 的意义,不是国产 AI Coding 已经追上 Claude Code,而是竞争终于从“谁的模型更强”进入“模型 + Harness”的系统阶段。随着模型能力逐渐接近,真正决定 Agent 能否稳定完成复杂任务的,越来越是工具调用、上下文管理、规划、子 Agent 与执行系统。DeepSeek 已经开始补这块最短的板,但真正的追赶才刚开始。
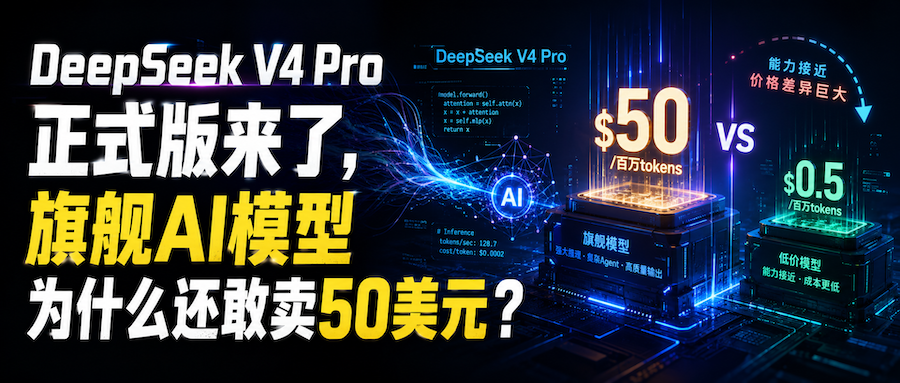
DeepSeek V4 Pro正式版来了,旗舰AI模型为什么还敢卖50美元?
DeepSeek V4 Pro正式版在Agent和Coding能力上已进入第一梯队,但API价格仍远低于顶级闭源模型。真正值得关注的,不是谁又拿下Benchmark第一,而是当“足够接近最强”的模型越来越便宜,旗舰Agent依靠能力稀缺性维持高价的空间,可能正在迅速缩小。
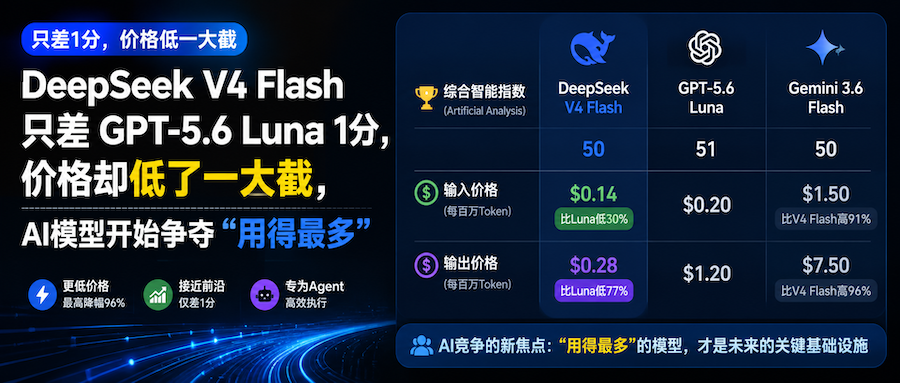
DeepSeek V4 Flash只差GPT-5.6 Luna 1分,价格却低了一大截,AI模型开始争夺“用得最多”
DeepSeek V4 Flash以接近主流闭源模型的能力和更低价格,切入Agent执行层。它未必是最强模型,却可能凭借低成本、开放权重和高频调用,成为AI时代用得最多的模型之一。
梁文锋想做AGI,Hassabis已经让我们看见AGI之后
梁文锋在寻找通往AGI的路,Hassabis则用AlphaFold让我们提前看到更强智能的意义。AI真正值得期待的,不只是提高效率、替代工作,而是突破人类认知边界,解决疾病、能源、材料等长期未解的科学难题。
梁文锋想的是AGI,我更关心AGI之后的世界
梁文锋思考的是AGI,我更关心AGI之后的世界。技术、GPU和商业竞争终究是手段,真正值得期待的,是AI突破人类智能边界,攻克癌症、罕见病等难题,让顶级智能普惠每个人,最终真正造福全人类。
这次真不慌了,Claude随时可以取消订阅
过去一年,Claude大概是AI Coding领域存在感最强的名字之一。 Claude 3.7之后,Claud […]