8月17日,DeepSeek V4新的API价格正式生效。
这次调整最容易被注意到的,当然是涨价。但我仔细看了一遍新的价格表之后,觉得里面还有一个更值得讨论的数字。
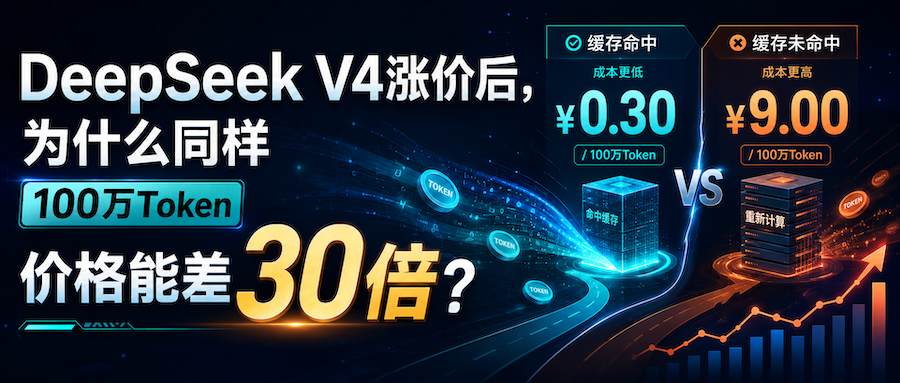
以DeepSeek V4 Pro为例,在高峰时段,100万输入Token如果没有命中缓存,价格是9元;如果命中缓存,只需要0.3元。
同样100万Token,价格相差整整30倍。
V4 Flash也是一样,缓存未命中是3元,命中只有0.1元。再加上DeepSeek这次新增的峰谷定价,闲时价格只有高峰的一半,那么V4 Pro的100万输入Token,最低可以是0.15元,最高却可以达到9元,极端情况下相差60倍。DeepSeek的新价格已经于北京时间2026年8月17日0时生效,高峰时段为9:00—12:00和14:00—18:00。
这件事其实挺有意思。
过去我们比较大模型价格,习惯问一句:这个模型100万Token多少钱?
但进入Agent时代之后,这个问题可能已经越来越没有意义。
因为真正决定你最后付多少钱的,不再只是用了多少Token,还有一个以前很少被普通用户关注的指标:
缓存命中率。
一、缓存命中,不是AI“记住了你”
先说什么叫缓存。
假设你把一份500页的公司资料交给一个员工,让他看完以后回答问题。
第一次,你问:“这家公司去年收入增长了多少?”
他需要从头把500页资料读一遍。
过了一会儿,你还是把完全相同的500页资料交给他,只是把最后的问题换成:“这家公司利润为什么下降?”
如果他又从第一页重新读到第500页,显然很浪费。
更合理的方法是:前面的资料刚刚已经处理过了,这次直接利用之前的结果,只处理新增加的问题。
大模型的上下文缓存,可以简单理解成在做类似的事情。
DeepSeek的上下文硬盘缓存默认对所有API用户开启。第一次请求以后,系统会把可以复用的Prompt前缀对应的计算状态保存下来;后面的请求如果完整匹配这些前缀,就不需要再从头完成相同的计算,而是从缓存中读取。
所以这里有一个很容易混淆的地方:
缓存命中,不等于AI记住了你的聊天记录。
它不是ChatGPT里的“记忆”功能,也不是模型突然知道了你上个月告诉它的事情。更准确地说,它是:
这部分内容我刚刚已经算过,不需要再算一遍。
二、为什么只是“不重新算”,价格就能差30倍?
因为我们看到的Token,只是计费单位,真正昂贵的是Token背后的计算。
一个长Prompt进入模型之后,模型首先需要处理整段输入上下文,这个过程通常被称为Prefill。如果你扔进去的是一份几十万Token的代码库、一份很长的财报,或者一个已经持续几十轮的Agent任务,这部分计算本身就不便宜。
如果前面几十万Token和上一轮完全相同,就没有必要重新处理一遍。
缓存真正省掉的,并不是Token本身,而是Token背后的重复计算。
而且一次请求并不是简单地分成“命中缓存”和“没有命中缓存”两种状态。
例如一个Coding Agent当前的上下文已经有10万Token,下一轮又增加了2000 Token的新任务,那么这10.2万Token里面,可能有9万多Token命中缓存,只有新增或者发生变化的部分按照未命中价格计费。
DeepSeek甚至会在API返回结果里直接告诉开发者两个数字:
prompt_cache_hit_tokens
以及:
prompt_cache_miss_tokens
也就是说,缓存命中率本身已经变成一个可以被统计、被优化,最终直接影响账单的指标。
三、但缓存并不会永远存在
这里还有一个很容易被忽略的问题。
既然第一次算过以后可以复用,是不是以后一直都是缓存价格?
当然不是。
缓存都有生命周期,只是不同公司的做法差别非常大。
| 厂商 | 主要缓存机制 | 缓存有效期 |
|---|---|---|
| DeepSeek V4 | 自动硬盘缓存 | 通常几小时到几天,系统自动清理,不保证命中 |
| OpenAI GPT-5.6+ | Prompt Cache | 默认30分钟,每次复用重新刷新30分钟 |
| Claude | Prompt Cache | 默认5分钟,可选择1小时 |
| Gemini | Implicit Cache | 内存缓存TTL为24小时 |
| Gemini Explicit Cache | 显式缓存 | 默认1小时,可由开发者自行设置 |
这张表看起来好像DeepSeek时间比较长,但实际上不能简单这么比较。
DeepSeek采用的是一种“尽力而为”的机制。官方明确说明,不保证100%命中;缓存不再使用以后会自动清理,时间通常是几个小时到几天。
OpenAI在GPT-5.6及以后的模型上采用了更明确的30分钟TTL,而且这是一个滑动窗口。比如10点建立缓存,10点20分再次命中,那么有效期就重新延长到10点50分。GPT-5.6之前的部分模型则采用5—10分钟的内存缓存,或者支持最长24小时的Extended Retention。
Claude默认只有5分钟,但每次命中以后也会刷新;如果任务间隔比较长,可以使用1小时缓存,不过创建1小时缓存的价格是普通输入的2倍。Claude的缓存读取则只有普通输入价格的10%。
Gemini又是另一种思路。2.5及更新模型默认开启Implicit Caching,Google披露其内存缓存TTL为24小时;此外还允许开发者主动创建Explicit Cache,默认保存1小时,并且可以自己设置TTL,保存时间越长,还要额外支付存储成本。
所以“缓存”虽然是同一个词,不同公司的产品设计其实并不完全相同。
四、为什么到了Agent时代,缓存突然重要了?
如果只是过去那种问ChatGPT一个问题、得到一个答案的使用方式,缓存并没有那么重要。
但Agent完全不同。
一个Coding Agent工作的时候,每执行一步,都可能重新带上System Prompt、工具定义、项目规则、AGENTS.md、之前读取过的代码、前面的对话以及工具执行结果。
任务运行到后面,一次请求的上下文可能已经有几十万Token,但真正新增加的内容只有最后几千Token。
这恰好就是缓存最擅长处理的场景:
前面绝大多数东西都一样,只有最后一小部分发生变化。
Anthropic最近在自己的Agent任务测试中发现,缓存命中率可以达到81%—90%,开启缓存之后,部分任务成本降低到原来的约1/2.5至1/3.7。Anthropic甚至把Prompt Caching称为Agent成本优化中优先级非常高的一项,因为一个40轮的Agent任务,会反复把早期上下文带入后续请求。
这也是为什么我觉得,DeepSeek这次价格调整真正值得关注的,并不是简单的“涨了多少钱”。
当V4 Pro缓存命中和未命中的输入价格能够相差30倍时,Agent是怎么管理上下文的,可能和模型本身卖多少钱一样重要。
五、Prompt怎么排列,现在都会直接影响你的账单
缓存还有一个非常重要的特点:
它通常要求前缀匹配。
比如你的Prompt是:
公司资料 + 用户资料 + 今天的问题
第二次变成:
公司资料 + 用户资料 + 明天的问题
前面的固定内容很容易被复用。
但如果每一次都变成:
当前时间 + 随机Request ID + 公司资料 + 用户资料 + 问题
那么Prompt一开始就已经不同,后面的缓存复用就会受到影响。
所以DeepSeek和OpenAI都强调,把稳定、重复使用的内容放在前面,把经常变化的内容尽量放到后面。
这件事情其实很有意思。
以前我们研究Prompt Engineering,关心的是:
怎么写,AI回答得更好。
现在又多出了一个问题:
怎么排列,AI运行得更便宜。
Prompt已经不只是模型效果问题,也开始成为成本工程问题。
六、这也是为什么Harness越来越重要
我之前一直觉得,国产AI Coding现在一个很重要的短板,已经不是模型本身,而是Harness。
缓存这件事其实再次说明了这个问题。
一个好的Harness,不只是负责把问题交给模型、调用工具,然后把结果拿回来。它还要决定每一轮带多少上下文,什么时候压缩,什么内容应该长期保留,哪些内容能够稳定形成缓存前缀,以及一次任务到底需要循环多少轮。
这些设计最终都会落到Token和钱上。
以前我们比较两个模型,经常只看:
100万Token多少钱?
以后更值得比较的可能是:
完成同一个任务到底多少钱?
因为模型能力决定了这件事情能不能做成,而Harness越来越决定这件事情要调用多少次模型、重复计算多少上下文,以及最后到底花多少钱。
这也是Agent时代一个很容易被忽略的变化。
七、AI模型的价格,正在从一个数字变成一道公式
DeepSeek V4 Pro现在的输入价格到底是多少?
答案可以是:
0.15元、0.3元、4.5元,也可以是9元。
它们全部都对。
因为同样100万Token,最终价格取决于它是在高峰还是闲时调用,也取决于这部分Token到底有没有命中缓存。
所以以后再看到一家模型公司说“我们的API只需要多少元/百万Token”,其实已经不能完整反映真实成本了。
真正的成本越来越接近:
用了多少Token × 其中多少能够复用 × 调用了多少轮 × Harness怎样管理上下文。
DeepSeek这次把缓存命中和未命中的价格差拉到了30倍,只是让这个原本藏在API账单里的问题,突然变得非常醒目。
大模型进入Agent时代以后,我们可能也需要重新理解“模型价格”这四个字。
模型多少钱是一回事,怎么使用模型,是另一回事。