Table of Contents
最近我给自己的 DeepSeek Harness 接了飞书。平时让它操作飞书时,用的是 lark-cli。问题出在一个很小的地方:lark-cli 在刷新 token、写缓存和日志时,需要写入用户目录,而 DSH 默认的 workspace-write 沙箱主要保护当前工作区。命令一旦要写到工作区之外,就可能触发权限升级,弹出 danger-full-access 授权。
Agent 已经可以连续工作很久,如果每隔一会儿因为一个我明明知道用途的命令停下来等我点授权,自动化体验就被打断了。
最简单的办法是直接给 DSH Full access,但我不想这么做。DSH 官方把 workspace-write 和 danger-full-access 做成不同权限预设,官方安全文档也明确提醒,应尽量采用最小权限。
DSH 还有实验性的 Auto review,可以把审批交给另一个模型判断,我暂时也不想用。于是我问 DSH:能不能写一个插件,只对白名单里的 Bash 命令放宽权限?比如 lark-cli 可以写它需要的目录,其他命令继续保持原来的沙箱规则。
几个小时以后,插件已经能用了,我把它发布到了 GitHub。
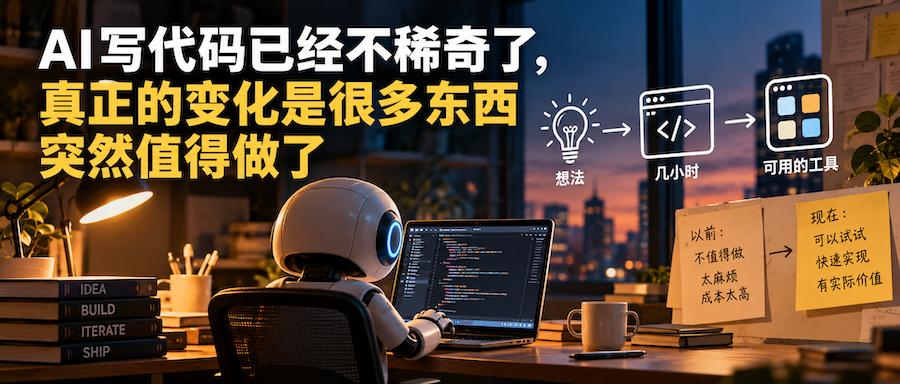
这件事让我真正觉得有意思的,不是“AI又帮我写了一个插件”。现在让 AI 写代码已经不新鲜了。我更在意的是:如果一个过去因为太小、太麻烦、不值得专门投入开发时间的问题,现在几小时就能从想法变成可安装的软件,那么我们判断“什么东西值得做”的标准,也会跟着改变。
我只是想少点几次授权,最后却做出了一个插件
这个插件没有简单替我自动点击 Full access,也没有把整个 DSH 会话改成完全权限。它利用 DSH 的扩展接口,对 shell 的 resolve 过程加了一层:只有命令匹配白名单时,才修改这一次调用的 sandboxPolicy;没有命中的命令,继续走原来的沙箱和审批逻辑。DSH 官方架构里,ctx.shell 本来就是 shell 执行器的 capability seam,所以这是在它原本允许扩展的位置上增加策略。
后来插件又加入了命令解析、PATH 校验、规则、审计和测试。我比较在意的一点是 fail closed:如果插件判断失败,就退回原来的沙箱和人工审批。
严格地说,这也不是“AI突破了自己的限制”。更准确的说法是,它能够理解自己所处的软件环境,找到宿主系统留出的扩展接口,然后为当前缺少的工具能力补上一块外围组件。
如果 AI 能从真实使用中的摩擦出发,研究陌生代码、理解框架、找到扩展点、实现、测试,再把结果整理成可安装的软件,那它影响的就不只是程序员敲代码的速度。
过去拦住很多需求的,并不是技术上做不到
如果没有 Coding Agent,这个插件我能不能写?当然能。我从 1999 年开始做互联网和软件开发,研究一下 DSH 的插件架构,并不存在不可逾越的技术门槛。
但我更可能不会做。为了一个“操作飞书时少点几次授权”的问题,我需要先理解一个并不熟悉的插件体系,找到正确 Hook,处理命令解析、安全边界、测试和配置。以前我很可能研究半天以后得出结论:算了,先点授权吧。
软件行业里一直存在这种隐形门槛。大量需求不是没有价值,也不是不能实现,而是它们带来的价值太小,覆盖不了开发成本。
METR 用“任务时间跨度”衡量 Agent 能独立完成多长的软件任务。到 2026 年,其最强一批公开模型在 Time Horizon 1.1 软件任务集上已接近饱和,测得的任务跨度超过两个完整工作日;METR 同时提醒,因为高难度任务不足,这个估计的不确定性也在增大。它不能直接换算成“AI已经能独立做两天真实开发”,但至少说明模型可以连续完成的多步骤软件工作在变长。
当实现成本下降,需求的经济学也会变
过去判断一个软件值不值得做,背后一直有一道朴素的账:它解决问题产生的价值,要大于把它做出来和长期维护的成本。
AI没有改变前半句,但正在快速压低后半句。这意味着一个过去只值几百元、几千元,甚至只是让我每天少烦一次的小问题,以前根本进不了软件开发流程;现在如果几个小时就能做出来,它突然成立了。
我的 DSH 插件就是一个很小的例子。它未必有什么巨大的商业价值,甚至可能只有一小群用户需要。但只要解决问题得到的收益超过现在的实现和维护成本,它就已经“值得做”。
如果这个趋势持续下去,会有一批过去处在软件经济边缘的需求重新被计算。企业内部的小流程、垂直行业工具、只服务几十个人的插件和个人软件,都可能增加。过去软件追求规模,一个重要原因就是研发固定成本高;当固定成本下降,软件未必每一次都需要很大的市场。
所以我越来越觉得,“AI写代码”已经抓不住重点。更大的变化是,软件生产的最低经济规模在下降。一个过去不值得立项的需求,现在可能值得做;一个过去只能忍受的工作流,现在可能值得改。
当然,这也会带来大量没人需要的软件。因为当“做出来”变便宜以后,另一个问题会越来越突出:到底应该做什么?
AI越会做,人越需要把边界想清楚
回到这个插件,真正决定结果的几个步骤,其实都不是写代码。
我不愿意为了省掉授权弹窗直接打开 danger-full-access;我知道 Auto review 存在,但暂时不想把这个安全决定交给模型;我需要的也不是“自动批准所有命令”,而是只允许明确的 CLI 在明确范围里工作。后面还涉及白名单怎么匹配、出错时默认放行还是拒绝、一个私人脚本有没有必要整理成公共插件。
这些问题没有哪一个可以靠“代码能运行”自动回答。AI把实现环节压缩以后,原来经常被“开发太贵”掩盖的问题会更直接地摆到人面前:需求有没有价值,风险是否值得,边界应该放在哪里,以及一件事值得投入三个小时、三个月还是三年。
我也不认为这意味着工程能力不重要。METR 在 2025 年做过一个随机对照实验:16 名长期维护大型开源项目的资深开发者,在自己熟悉的代码库里使用当时的 AI 工具,完成任务反而平均慢了 19%。METR 特别强调,这只代表早期 2025 年、特定开发者和成熟代码库的场景,不能外推成“AI让程序员都变慢”。
这个反例提醒我,AI并没有把软件工程变成“输入一句话,正确软件自动出现”。复杂系统里,经验、架构、安全和验证仍然重要。
变化更多发生在价值链的位置上。过去一个技术人的大量价值体现在“我知道怎么把它做出来”;以后这部分能力仍然需要,但越来越多实现工作可以交给 Agent。人的时间会更多花在理解问题、设置约束、判断风险、验收结果,以及决定一件事情到底值不值得继续投入。
几个小时前,我只是觉得 DSH 操作飞书时不断弹授权挺烦。几个小时后,它变成了一个可以安装的 GitHub 插件。
如果放在几年前,这件事很可能停在“有空自己写一个”那里,最后永远没有那个“有空”。现在,从一个小问题到一个可用软件之间的距离正在明显缩短。
所以我越来越少关心“AI到底能不能写代码”。对很多日常软件任务来说,答案已经越来越接近“能”。接下来更值得问的是:当实现越来越便宜以后,我们准备拿这种能力去做什么?
AI降低的是把想法变成软件的成本,却不会自动告诉我们哪个想法值得实现。甚至正因为能做的东西越来越多,选择、取舍和价值判断会比过去更频繁地出现。
这可能才是“很多东西突然值得做了”之后,我们真正要面对的问题。
AI写代码已经不稀奇了,真正的变化是很多东西突然值得做了 Share on X