Table of Contents
大模型商业化最难的,不是让更多人用上模型,而是把使用量转化为模型公司的收入。我最近看到 Epoch AI 一张很有冲击力的图。
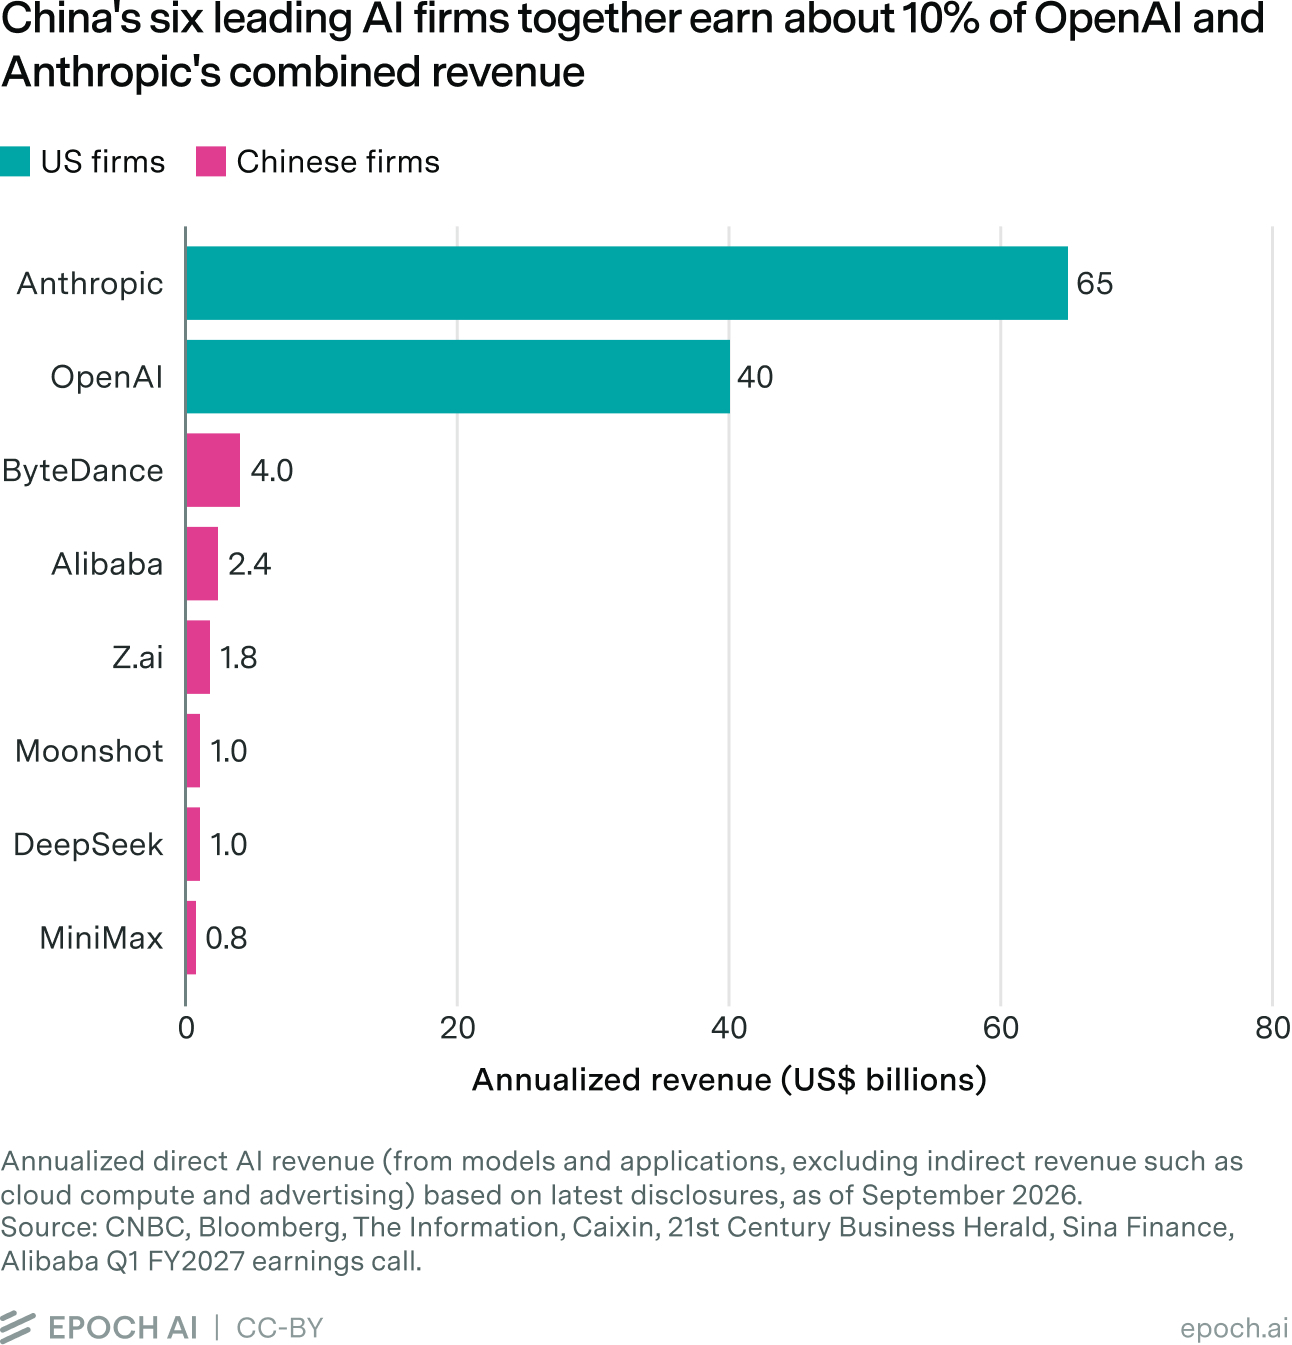
按它截至 2026 年 9 月的估算,ByteDance、Alibaba、Z.ai、Moonshot、DeepSeek、MiniMax 六家中国头部 AI 企业的年化 AI 收入合计大约 110 亿美元;OpenAI 和 Anthropic 加起来约 1050 亿美元。也就是说,中国这六家公司加在一起,大约只有后两家的十分之一。
第一次看到这个数字,很容易得出一个简单结论:中美 AI 的商业化差距,比模型能力差距大得多。
但我后来把 Epoch AI 这份《How do Chinese AI companies make money?》完整看了一遍,反而觉得“10%”不是最值得讨论的地方。因为这里的统计口径并不完全一致:阿里和字节主要统计 MaaS,也就是模型服务收入,而 OpenAI、Anthropic 用的是更广义的 AI 收入 run rate;不同公司的数据时间点也不一样。 阅读Epoch AI报告
真正让我在意的是另一个问题:过去一年,中国模型在能力、使用量和开发者生态上的存在感都越来越强,为什么这些使用量没有同比例变成模型公司的收入?
这可能是中国 AI 接下来比“模型还能不能再强一点”更难回答的问题。
大模型商业化:模型有人用,不等于模型公司能赚钱
Epoch AI 把中国 AI 公司的收入来源分成五类:消费者应用、API 和模型访问、企业与政府项目、模型授权,以及 AI 带动云、广告、电商等既有业务。
看起来路很多,但每条路都有自己的问题。
先看 C 端。MiniMax 的数据很典型。Epoch AI 引用其披露称,2025 年前 9 个月,AI 原生应用的毛利率只有 4.7%,而 Open Platform 和企业服务的毛利率达到 69.4%。原因也不难理解:用户多,并不意味着用户愿意付费;即使付费,中国 AI 产品的订阅价格通常也比美国同类产品低。
这件事我其实并不意外。我们平时讨论一个模型成功不成功,很容易看 MAU、Hugging Face 下载量、OpenRouter Token、Benchmark 排名,但这些数字更多衡量的是“这个模型创造了多少使用价值”,并不等于公司最后能留下多少收入。
一个模型被下载一百万次,可能意味着生态非常活跃,但这百万次下载本身几乎不会产生收入;OpenRouter 上 Token 调用越来越多,也不代表这些 Token 一定通过原厂 API 完成。
这里其实存在两个完全不同的指标:一个是 Value Creation,创造了多少价值;另一个是 Value Capture,公司最终捕获了多少价值。
我更倾向于把今天中美 AI 的这部分差距理解成后一种差距。模型能力决定你能不能被用,商业模式决定这些使用最后是不是必须经过你的收费入口。
如果从这个角度看,Epoch AI 那张收入图就没那么简单了。它并不只是说“中国公司赚得少”,而是在提醒我们:模型影响力和模型公司的商业价值,正在变成两件越来越不同的事情。
开放权重带来了一个很尴尬的商业问题
中国模型和 OpenAI、Anthropic 最大的差异之一,是大量旗舰模型选择开放权重。
站在用户和开发者角度,我很喜欢这种模式。最近我自己把 DeepSeek Harness 接进生产环境,接 Elasticsearch、数据库和代码仓库做运维排查,其中一个很现实的好处就是模型和推理服务可以替换,数据也不一定必须交给某一个固定 SaaS。
今天我可以用一家云厂商提供的 DeepSeek,明天也可以自己部署,或者换到另一家更便宜的推理服务。对于企业来说,这种选择权非常有价值,而且开放权重还能让模型更容易适配国产芯片、企业私有环境和各种 Agent 框架。
但如果换到模型公司的视角,这恰恰就是问题所在。
Epoch AI 举了 Z.ai 的 GLM 5.3 Flash。模型权重开放后短短 20 天,OpenRouter 上提供这个模型的服务商从 12 家增加到 26 家;Z.ai 自己的 Token 份额却从 88% 降到 22%。更有意思的是,整个 GLM 5.3 Flash 的使用量增长了 17%,Z.ai 自己每天服务的 Token 数反而下降约 70%。
这个例子把开放模型的商业矛盾表现得非常清楚:模型确实更成功了,但增长的那部分生意,被其他推理服务商拿走了。
DeepSeek 也有类似情况。Epoch AI 估算,在 OpenRouter 上围绕 DeepSeek 模型产生的消费,只有大约 8% 最终流向 DeepSeek 本身。DeepSeek V4 涨价后的调用与收入关系,也呈现出同样的分离,详见《DeepSeek V4涨价后,真正的问题不是谁在用,而是谁在赚钱》。
这意味着开放模型可能出现一种传统软件很少见的局面:产品越来越成功,生态越来越大,但原厂未必因此赚得更多。因为权重一旦开放,模型公司不仅在和别的模型竞争,也在和所有运行自己模型的第三方推理服务商竞争。
而且这种竞争很容易变成价格竞争。同一个模型,能力基本一样,用户自然会去找价格更低、速度更快、缓存更便宜的一家。
这也能解释为什么闭源模型更容易建立商业闭环。想用 Claude 的前沿能力,基本要经过 Anthropic 或其授权渠道,模型能力和收费入口是绑在一起的。Epoch AI 引用的数据里,Z.ai API / developer platform 的毛利率在 2025 年是 18.9%,2026 年上半年升到 24.6%;相比之下,Anthropic 顶级模型按一方 API 标价计算的 serving 毛利率估算约为 85%。
当然,这并不能证明闭源一定优于开放。开放带来的生态价值是真实存在的,而且中国模型今天能够如此快地进入全球开发者工具链,开放权重本身就是很重要的原因。
DeepSeek 也提供了另一种可能:如果推理效率足够高,原厂即便面对第三方竞争,仍然可以靠成本优势获得不错的毛利。Epoch AI 对 DeepSeek V4 API 的估算是 70%—80%。
所以开放模型接下来的竞争,恐怕不只是谁的模型更强,也包括谁能把同一个模型跑得更便宜。
中国模型公司正在给开放生态重新装上收费口
如果完全依赖企业私有化项目,也很难解决这个问题。
Z.ai 2025 年有 73.7% 的收入来自本地部署,毛利率不算差,但这种生意需要数据接入、系统集成、部署和持续维护,很难像 API 那样规模化。到了 2026 年上半年,本地部署收入占比已经降到 13.5%。Epoch AI 引用 Z.ai 自己的解释,就是这类业务交付和维护成本比较刚性,很难形成足够好的规模经济。
做过企业软件的人应该很容易理解这种模式。一个客户从 100 万做到 1000 万收入,很多时候意味着项目团队也要跟着扩大;而理想的 API 生意,是服务器多跑一些 Token,就能服务更多客户。这是两种完全不同的扩张方式。
所以现在更值得观察的是另一条路:权重继续开放,但商业使用不再完全免费。
Moonshot 的 Kimi K3 就很典型。它的许可证规定,如果一家公司经营 MaaS 业务,而且连续 12 个月总收入超过 2000 万美元,在将 Kimi K3 用于商业目的前,需要和 Moonshot 单独签协议。
这套设计挺有意思。对于普通开发者、研究者和大量企业内部使用,模型仍然足够开放;但如果一家大型推理平台拿着 Kimi 的模型权重,做成了自己的商业服务,Moonshot 希望重新参与利益分配。
Epoch AI 还提到,Moonshot 正尝试通过 Azure、AWS、Google Cloud 等平台获得收入分成;Z.ai 也开始和云平台做类似安排。今年 10 月,GLM 5.3 已经正式进入 Amazon Bedrock。
我觉得这个变化很重要,因为它说明中国模型公司并没有简单地从“开放”退回“闭源”,而是在寻找一种中间状态:模型可以传播,生态可以繁荣,但商业价值不能全部被下游拿走。
未来比较可能出现的,是“开放权重 + 官方 API + 商业授权 + 云平台分成 + 企业服务”混合在一起。开放不再意味着放弃收费,而是重新设计收费发生在哪一层。
最适合开放模型赚钱的,也许不是纯模型公司
看完整份报告以后,我反而觉得阿里和字节比 DeepSeek 更值得观察。
因为它们不一定要求模型本身赚钱。
阿里今年 6 月季度的 AI 相关产品收入达到 123.76 亿元人民币,约 18.24 亿美元,已经连续 12 个季度保持三位数同比增长;同一季度,AI 云与算力服务收入同比增长 45%,创下 22 个季度以来最高增速。
阿里自己披露的口径也很清楚,这套增长来自 AI 模型、Agent、云基础设施、芯片和企业服务整套能力,而不只是卖 Qwen 的 Token。
这套逻辑和纯模型公司完全不同。
哪怕客户用的不是 Qwen,而是 DeepSeek、Kimi 或 GLM,只要最后跑在阿里云上,算力收入仍然可能留在阿里。模型开放得越多,整个行业推理量越大,云厂商反而越可能受益。
字节也是类似的思路。IDC 的数据里,2025 年中国公有云大模型调用量达到 1944 万亿 Token,同比增长 16 倍,火山引擎占其中 49.5%。
Epoch AI 进一步估算,火山引擎 2026 年 MaaS 年化收入目标约 40 亿美元。但字节真正可以从 AI 获得的收益还包括广告、电商和内容生产,这些收入未必会出现在“模型收入”那一栏里。
这也是为什么我觉得,开放模型最后最大的赢家未必是拥有某一个最强模型的公司,而可能是那些掌握云、算力、广告和交易入口的平台。
Nvidia 的生意已经证明了一件事:你不一定需要拥有所有模型,只要所有模型都需要经过你的基础设施。
阿里和字节现在可能也在往这个方向走。
回到 Epoch AI 最开始那张“10%”的图,我现在并不太在意中国 AI 公司什么时候把这个比例追到 20% 或 30%。因为如果开放模型继续成为中国 AI 的重要路线,更关键的问题是:模型创造出来的价值,最后会停在哪一层。
过去我们一直在问,谁能做出更强的模型。接下来恐怕还要多问一句:当模型越来越便宜、越来越开放以后,谁还能设计出一个别人很难绕过去的收费口。
而这,可能才是中国大模型商业化下一阶段真正需要补上的商业能力。
中国AI模型越来越强,为什么反而越来越难赚钱? Share on X