Table of Contents
昨天看到 Andrej Karpathy 的一条新帖子,我读了好几遍。
他把今年4月的一条旧帖重新翻了出来,说人们对LLM能力的共同理解差距还在继续扩大。几个月前,他觉得只是“两群人在彼此说不通”,现在则更像一个越来越尖锐的漏斗。
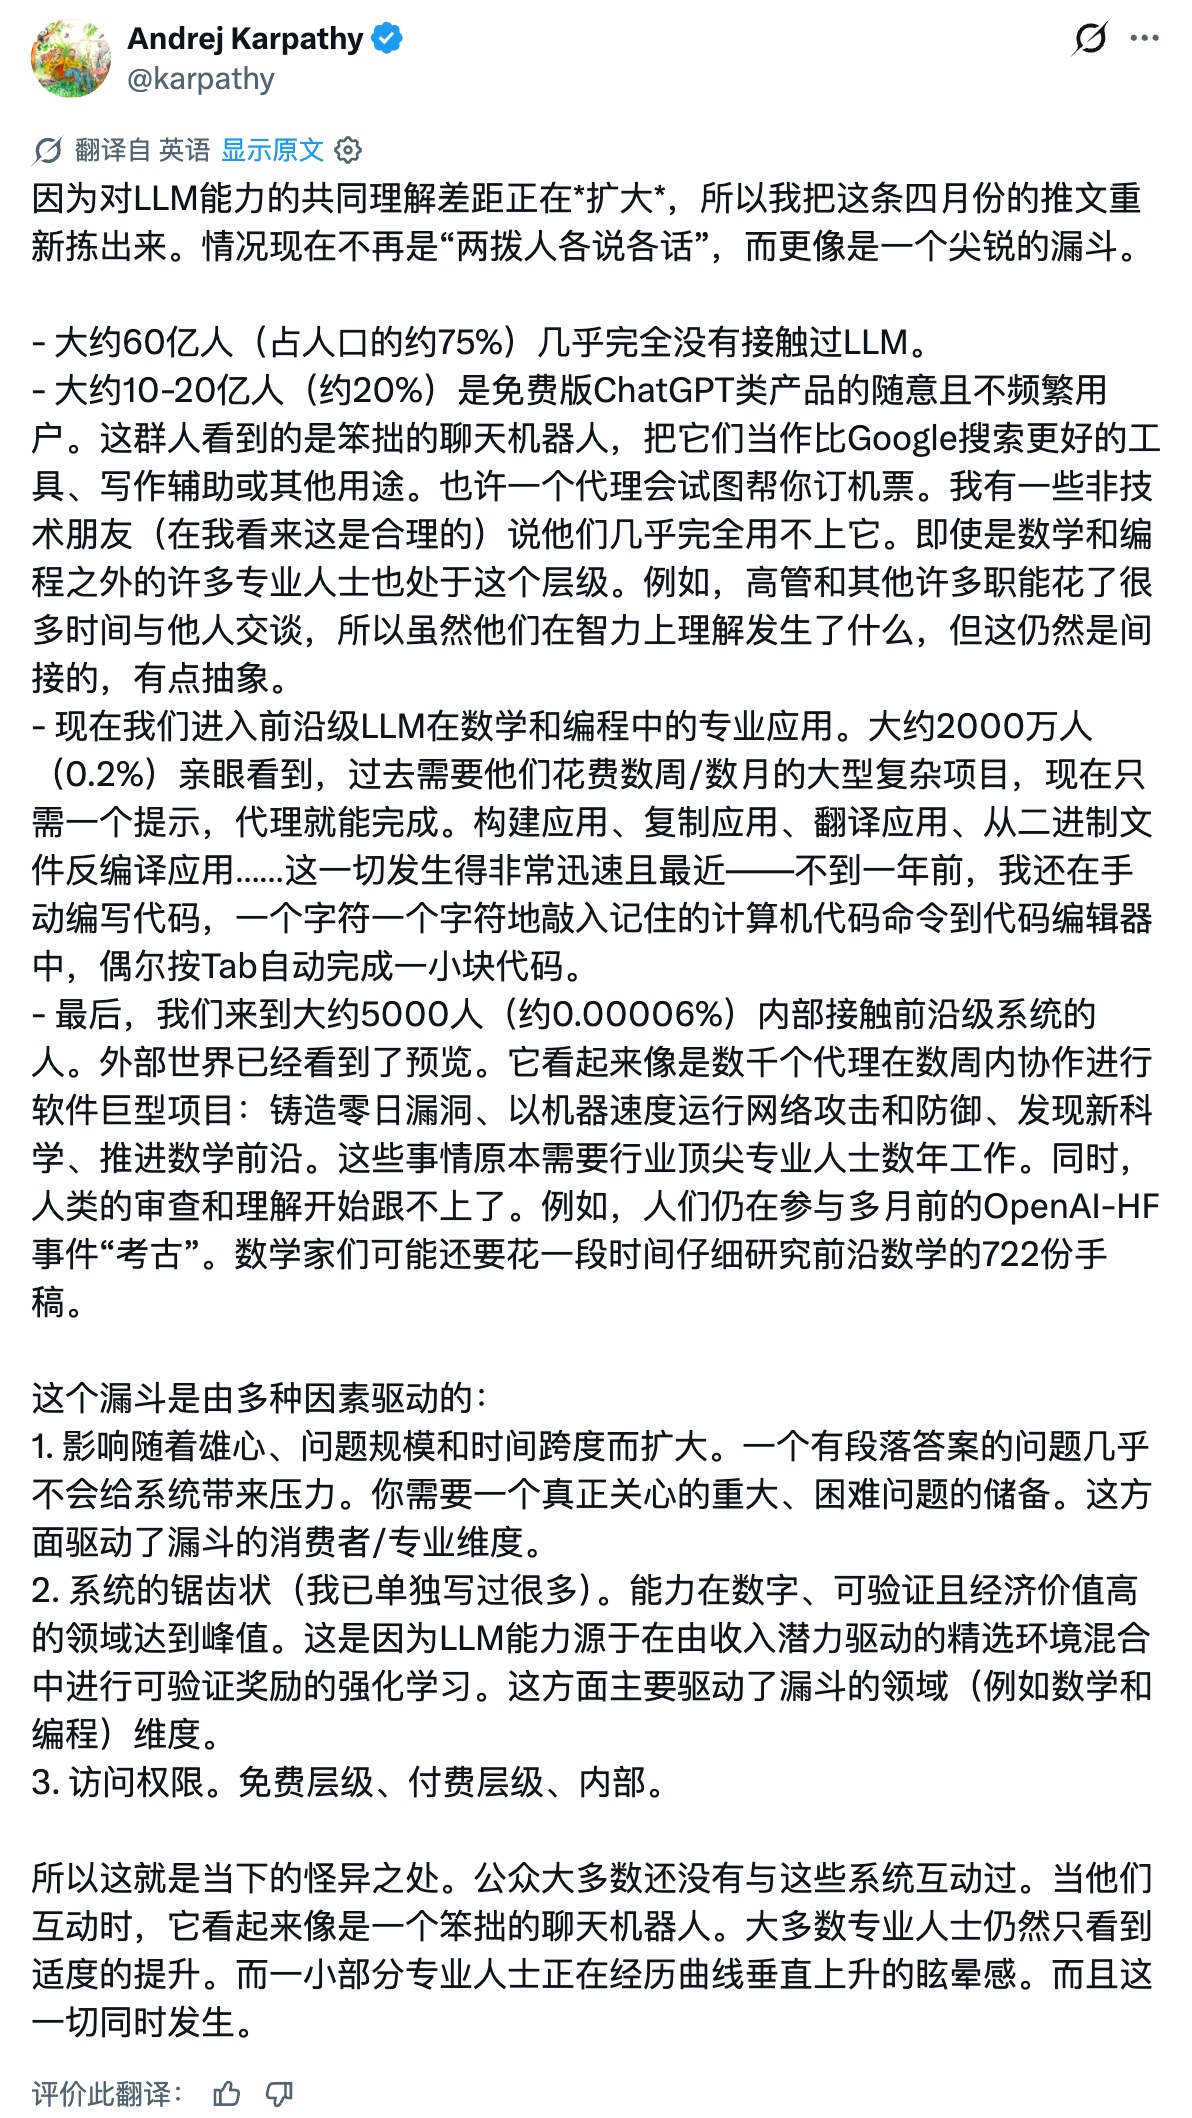
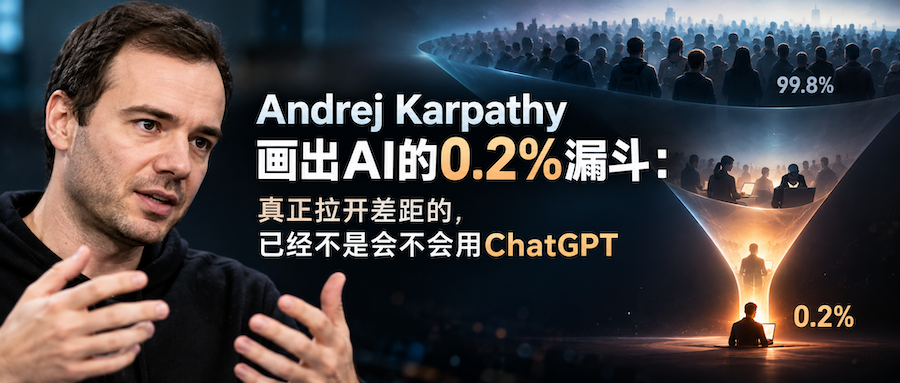
Karpathy给了一组他自己也称为“napkin math”的粗略估算:全球约60亿人几乎没有真正接触过LLM;10亿到20亿人只是偶尔使用免费版ChatGPT一类产品;大约2000万人,也就是0.2%左右的人,已经在数学和编程等领域专业使用前沿模型,亲眼看到Agent把过去需要几周甚至几个月的复杂工作大幅压缩;最顶端则约有5000人能够接触实验室内部更前沿的系统。这不是统计调查,只是Karpathy的粗略估计,但这个“漏斗”值得讨论。
我比较在意的不是“0.2%”准不准确,而是它解释了一个现象:为什么同样生活在2026年,有些人仍把AI当聊天机器人,另一些人却已经开始重新设计工作方式。
大家用的是同一个AI,但看到的并不是同一种能力
如果一个人每天只用ChatGPT查资料、润色邮件,那么他对AI的判断很可能是:有用,但没有那么神;会犯错,也离不开人。
但如果另一个人已经把代码库、终端、数据库、浏览器和文档接给Agent,让它连续完成一个完整任务,他看到的就会完全不同。Karpathy认为这个漏斗主要由三个因素造成:你交给AI的问题有多大、模型能力本身有多“锯齿状”,以及你究竟能够访问什么级别的模型。尤其是第一个因素,他的意思很直接:一个只需要一段话就能回答的问题,根本没有把系统逼到能力边界。
这让我想到OpenAI今年提出的“capability overhang”:AI已经具备的能力,与大多数人真正获得的价值之间,还存在一段没有被利用起来的空间。OpenAI公布的数据里,典型的power user使用高级“thinking”能力的程度,大约是典型用户的7倍。这个指标当然不能直接等同于生产率,但至少说明,今天人与人之间的AI差距,已经不只是“有没有ChatGPT账号”,而是你到底把什么工作交给了它。
我自己做开发时,这个变化已经非常明显。现在我的日常开发里,绝大多数代码都不是我亲手逐行敲出来的。最大的变化不是补全更准了,而是我越来越少给它一个函数、一个页面这样的小任务,而是直接给目标、代码库、约束和验收条件,让Agent自己查代码、修改和测试。
如果仍然用“它写这一段代码准不准”来判断AI,其实已经看不到这套工作方式真正改变了什么。
从“问AI”到“把工作交给AI”,中间隔着一整套工作方式
过去几年大家学习AI,最常见的说法是学Prompt。这当然有用,但我越来越觉得,它很可能只是AI普及早期的技能。
现在更明显的变化,是使用模式开始从Ask AI转向Delegate to AI。
两者的差别并不只是Prompt更长。Ask AI的典型任务是“帮我找资料”“解释这段代码”“写一个方案”;Delegate更像是“这是目标、现有项目、工具和限制条件,你完成它,并用测试结果告诉我是否完成”。
Anthropic今年分析了大约40万次Claude Code会话,发现一个很有意思的分工:在典型会话里,人类做了大约70%的规划决策,而Claude做了大约80%的执行决策。也就是说,人越来越多地决定“做什么、什么算完成”,AI负责“具体怎么做”。每次用户给出一个指令,Claude平均会继续执行大约10个动作。
这已经很接近真实工作的形态。Anthropic还发现,Claude的使用正在从普通对话转向更长时间运行的Agent任务;同样是生成文章,在Chat或Cowork里,中位数需要13轮来回,而在Claude Code里只需要一次人类Prompt。
所以我现在理解的AI Native,并不是“每天都用AI”,也不是熟练掌握几十个Prompt模板。它更像一种默认的工作习惯:拿到一个任务以后,先想的不是“我该从哪里开始做”,而是“这件事怎样才能让AI尽可能完整地做”。
这样一来,问题就会从Prompt转向上下文、工具、权限、数据和验收标准。模型只是其中一部分。
程序员只是最早进入这个漏斗的一群人
Karpathy把0.2%主要放在数学和编程上,这一点不能忽略。不能因为Coding Agent进步很快,就推导出所有知识工作都会以同样速度变化。
代码确实非常适合AI。它是数字化的,有编译器、有测试、有日志、有运行结果,一个修改到底对不对,很多时候能够很快得到反馈。Karpathy也把这种“可验证性”视为能力分布不均的重要原因。METR用“任务时间跨度”衡量前沿Agent能力时,测的同样是软件任务:先估算人类专家完成任务需要多久,再看Agent在不同难度下能以多高概率完成。METR也特别提醒,这个指标衡量的是任务难度,并不等于AI真的可以连续自主工作同样长的时间。
但程序员的经验对其他职业仍有一个重要参考:以后真正需要学习的,未必是编程,而是如何把自己的工作变成AI可以处理、反馈和验证的问题。
Anthropic对Claude Code的研究甚至发现,在产生代码的会话里,非软件职业用户与软件从业者的成功率差距已经很小;更影响结果的,是使用者对自己那个领域到底懂不懂。专家级用户每次指令能够驱动Claude完成的动作数量,是新手的两倍以上,验证成功率也明显更高。
这点我非常认同。AI降低的是执行门槛,并没有让判断变得不重要。一个不懂业务的人,即使会写漂亮的Prompt,也很难判断结果哪里不对;真正懂业务的人,即使不会写代码,也越来越可能借助Agent完成过去做不了的技术工作。
我想成为那0.2%,但不是因为我相信AI万能
看到Karpathy这张漏斗以后,我的第一反应确实是:应该努力站到更靠上的位置。
但更准确的说法可能不是“我要成为全球0.2%的人”。Karpathy这个0.2%本身就是一个粗略估算,而且特指数学和编程领域的专业用户。一个医生、产品经理、律师或者企业管理者,即使非常AI Native,也未必属于他的统计口径。
我真正想争取的是:不要只通过新闻、Benchmark或者别人的演示判断AI,而是尽可能让自己的工作贴近它的能力边界。
而且越往这个方向走,我反而越不觉得“AI什么都能做”。模型能力依然非常锯齿,长任务也会积累错误。你可以把执行交给AI,但目标怎么定义、结果是否可靠、出了问题由谁负责,不会因为Agent更强就自动消失。
真正深度使用AI以后,最后学到的往往是怎么建立测试、反馈、权限和复核机制,让它承担更多工作,同时不把错误一起放大。
Karpathy那条帖子最后给我的触动就在这里。今天大家争论AI强不强,很可能已经在讨论两个不同的东西:有人看到聊天机器人,有人已经把它当成执行复杂工作的系统。
我不太在意那个0.2%最终是0.1%还是1%。我更在意的是,当AI能力继续往前走时,我们的工作方式有没有跟着变化。
过去拿到一个任务,我会先想“这件事我怎么做”。现在我越来越习惯先问:“这件事为什么还要按照没有AI时的方式来做?”
对我来说,这可能才是AI Native真正开始的地方。
Andrej Karpathy画出AI的0.2%漏斗:真正拉开差距的,已经不是会不会用ChatGPT Share on X