Table of Contents
9 月 30 日 Google 正式发布新一代旗舰推理模型 Gemini 4 Argon,并在 10 月 13 日向付费 API、Google AI Ultra 及部分 Pro 订阅用户全面开放。
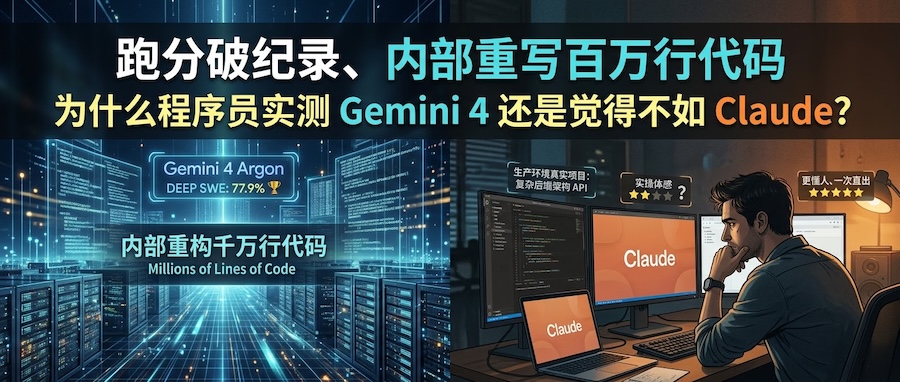
按照往常的惯例,这个级别的大版本更新总会伴随几天的参数狂欢,但如果你这两天去翻看 Reddit、Hacker News 以及国内的 Linux.do 和 V2EX,会发现社区对它的评价分裂得有些反常。在 Google 官方公布的战报里,这几乎是一个无所不能的工程怪兽:它不仅在长周期软件工程基准测试 DeepSWE v1.1 上拿下了 77.9% 的历史最高分,还在 Google 内部从 4000 万行 Chromium 代码库中剥离了 600 万行遗留代码,并将 3.2 万行 libgav1 视频解码器底层代码迁移到 Rust,顺手把运行速度提升了 2.7 倍。
但到了外部程序员手里,画风却突然变了。在 Reddit 的 r/google_antigravity 社区里,一位第一时间拿到权限的 Google AI Ultra 订阅开发者,用自己生产环境的 Python 后端任务做了一次对比盲测,结果老对手 Claude Opus 5.5 拿到了 77 分,而跑分夺冠的 Gemini 4 Argon 只拿到 59 分。不少开发者跟帖反馈,用它快速画个前端界面或者写个演示 Demo 确实很惊艳,可一旦涉及复杂的后端架构集成,它还是容易漏掉权限认证或边界异常处理。更火上浇油的是,Google 在自家的编程工具 Antigravity 里直接拦住了每月花 20 美元的 Pro 会员,规定只有升级到高价的 Ultra 套餐才能调用 Argon,气得不少老用户当场晒出了退订截图。一边是重写百万行代码的工业级奇迹,一边是程序员实测业务代码时的挫败感,这中间到底差在了哪里?
被折叠的成绩单:为什么它能重构百万行内核,却在业务代码里漏掉细节
每当大模型出现“官方跑分没输过、民间实测打折扣”的反差,社区里最直接的反应往往是质疑厂商刷榜。我一开始看到那个“59 分对 77 分”的帖子时也留了个心眼,毕竟单个开发者在单一 Python 项目上的盲测样本太小,很容易受个人提示词习惯的影响。为了弄清楚这到底是普遍现象还是个案偏差,我后来专门去翻了 Google 官方技术报告里的完整细分跑分,以及第三方独立评测机构的最新榜单,结果发现答案其实就印在官方成绩单那些没被放进新闻大标题的角落里。
如果把各项编程基准拆开来看,Gemini 4 Argon 根本不是一个“全科状元”,它的能力分布带有极强的结构性偏科。在包含 113 个隔离环境长周期软件工程任务的 DeepSWE v1.1 上,Argon 确实以 77.9% 力压 Claude Opus 5.5 的 74.2% 和 GPT-6 Astra 的 74.1% 拿了第一;可一旦换到考核更高难度单点突破的 FrontierSWE v2,Argon 的得分就掉到了 55.0%,明显落后于 GPT-6 Astra 的 65.5%;而在贴近开发者日常命令行实操的 Terminal-bench 4.0 上,它同样没能越过以 66.4% 夺冠的 Claude Opus 5.5。第三方独立机构 Artificial Analysis 给出的综合智慧指数也印证了这一点:Argon 的综合得分为 53 分,与 GPT-6 Astra 持平,但依然排在 Claude Opus 5.5 后面。
为什么同一个模型,在长周期工程榜单上能登顶,到了另一类测试和程序员的日常 IDE 里却会掉链子?秘密藏在 Google 内部使用它的前置条件里。仔细看官方对 libgav1 解码器 2.7 倍加速案例的技术说明就会发现,那个惊人的结果并不是工程师丢给模型一句提示词、模型一次性吐出完美代码换来的,而是让模型在沙盒环境里反复执行性能分析(Profiling)测量、读取编译器报错输出、经过多轮自我修正才跑出来的;至于 Chromium 那 600 万行遗留代码的剥离,后面同样跟着一整套自动化审计、仿真测试与代码回滚机制。
问题就出在这里。普通程序员今天在 IDE 里写业务代码,绝大多数时候依然停留在“给一段需求描述,指望模型在一两个回合内把架构和细节一次写对”的交互模式。在这种缺少自动化编译反馈和多轮沙盒试错的“单次直出”场景下,考验的是模型第一反应的严密程度,而这恰恰是 Claude Opus 5.5 目前最稳的护城河。换句话说,Google 内部跑通的是“重型自动化验证流水线”,而外部开发者测试的是“手工作坊式的单次交付”,拿流水线组件去比拼单回合直出精度,体感上自然会有落差。
100 万 Token 输出与被拦在门外的 Pro 会员:重型流水线背后的算力账本
一旦理解了 Gemini 4 Argon 是围绕“多轮试错与长周期执行”设计的,就能看懂这次更新中最夸张的一个参数变化:Google 把模型的单次最大输出上限,从前代 Gemini 3.1 Pro 的 65,536 个 Token 直接拉升到了 100 万 Token,足足扩大了 15.6 倍(Google AI 开发者文档)。
刚开始看到这个数字时,很多人的第一反应是“谁需要 AI 一次性写几百万字的文章”。但在软件工程和企业自动化场景里,输出上限从来不是用来写长篇小说的,它是留给智能体(Agent)在后台做长链条推演的“工作台空间”。当模型需要独立完成一项复杂重构时,它得先检索代码库、提出修改假设、动手改写几十个文件、调用测试工具、解析报错日志,然后再推翻重写。以前的模型输出到几万 Token 就会被强行截断,人类必须手动接力;而 100 万 Token 的输出容量,意味着模型可以把整个“调查—假设—修改—测试—再修正”的漫长循环,完整地塞进同一条不断裂的推理轨迹里。
但这种拿算力换准确率的重型路线,立刻撞上了一道无比现实的商业墙,这也是为什么 Google 这次宁可挨骂,也要在 Antigravity 里把 20 美元的 Pro 会员拦在门外(Antigravity 官方博客)。
从用户情绪上讲,花了 20 美元买名为“Pro”的会员,却在官方 IDE 里用不了当家旗舰模型,抱怨一句“Pro 订阅里居然没有 Pro 级模型”完全合情合理。但如果翻开背后的算力账本就会发现,沿用了三年多的“20 美元固定包月制”,其实是聊天机器人时代的产物。那时候人类打一行字,模型回几百个字,一天下来消耗不了多少算力。而在 Antigravity 这类多智能体编程环境里,一旦放开让 Argon 跑长轨迹推演,Token 消耗速度是呈指数级飙升的——甚至有高价购买了 Ultra 套餐的早期用户在 Reddit 上反馈,自己不过开了中等推理强度、同时挂了 3 个子智能体做代码审查,不到半小时就把 5 小时周期的配额烧光了。在这样的吞吐量面前,20 美元包月在商业数学上已经很难算平账了。
与之形成鲜明对比的,是 Google 在 API 端给出的激进低价。Argon 的首发 API 价格定在了每百万 Token 输入 2 美元、输出 10 美元(促销期后恢复为 4 美元和 20 美元),不仅比 GPT-6 Astra 的 10 美元输入、50 美元输出便宜了一大截,最关键的是它把上下文缓存(Context Caching)的折扣打到了 95%,也就是每百万 Token 缓存输入只要 0.1 美元。这个定价结构把 Google 的真实意图暴露得很清楚:它并不指望靠 20 美元的 C 端月卡在重度编程工具里赚钱,而是希望企业把动辄几十万 Token 的代码库或业务文档缓存在 Google 云上,用 1 毛钱的缓存成本加上 100 万 Token 的长输出通道,去跑全自动的工业级工作流。
当高智商对手患上“说教症”,清爽文风如何让它接管日常桌面
那么,对于手里没有大厂级自动化测试沙盒、也不打算花大价钱升级 Ultra 套餐的普通开发者和知识工作者来说,Gemini 4 Argon 是不是就成了一个用不上的屠龙之技?恰恰相反,只要跳出“在 IDE 里单次直出复杂后端架构”这个单一场景,它在社区里的口碑几乎迎来了一边倒的逆袭。
这两天在 Hacker News 和 Reddit 上,有一个原本很少被放进技术评测的维度被反复提及——模型的“说话方式”。一位重度开发者的评论获得了极高赞同,他说 Claude Opus 5.5 依然是市面上最顶尖的程序员,但跟它共事一整天实在让人精疲力竭,因为它的行文变得越来越傲慢、充满防御性,甚至带着一种居高临下的被动攻击感;相比之下,Gemini 4 Argon 的纯编码硬实力大概是 Opus 的 90%,但它的文字表达清晰、简练、干脆,把对手甩开了几条街。
这种被海外社区戏称为“RL-fried(过度强化学习后遗症)”的AI 说教感,相信很多每天高强度使用大模型的人都深有体会。当顶尖模型之间的硬核智商差距缩小到 10% 以内时,决定你愿不愿意每天跟它打交道 8 小时的,往往不再是极限跑分里多出来的那两三个百分点,而是沟通时的情绪摩擦力。Google 显然捕捉到了这种微妙的厌倦感,在 Argon 的训练目标中专门减少了模棱两可的套话(less hedging)和陈词滥调,让它直接给结论。当然,也有部分用户在 X 上指出,Argon 对提示词依然比较敏感,有时候默认回复会显得过于平淡,需要加上明确的风格约束才能发挥出最佳水准,但至少它不再像一个随时准备纠正你价值观的严厉助教。
除了沟通清爽,100 万 Token 的输出空间在非核心编码的知识工作里也找到了极其顺手的落脚点。在涵盖金融、法律、税务的商业综合评估 Vals Index 上,Argon 拿下了第一,长视频理解基准 LVBench 更是达到了 91.7%。很多用户发现,当你向它请教一个复杂的金融假设或物理机制时,它不仅幻觉率极低,还非常喜欢发挥前端特长,现场写出一个能直接在浏览器里拖动参数滑块的交互式模拟器(Simulation)。你不需要大厂的编译沙盒,在普通网页端就能直观感受到这种“直接交付可交互工具”带来的效率跃升。
告别“唯跑分论”:在流水线时代重新分配你的数字搭档
回过头来看,Gemini 4 Argon 全面开放首周的这场口碑分裂,既不是 Google 跑分造假,也不是程序员吹毛求疵,而是前沿大模型正在发生一次明显的物种分化。
过去两年,我们习惯了拿一把标尺去量所有模型,总想找出一个既能一次写对底层架构、又能便宜大碗跑自动化、还能温和耐心地陪聊研究的全能冠军。但从这次 Argon 与 Claude Opus 5.5 的交锋来看,技术路线已经开始分叉:一条路线继续打磨单次交互的直出精度,适合人类工程师盯着屏幕做高难度的实时结对编程;另一条路线则选择把输出容量拉到百万级、把缓存价格压到地板上,专门服务于依靠测试工具链反复迭代的重型 Agent 流水线。
至少从上线初期的真实表现来看,如果你是一名独立开发者或技术负责人,完全没必要为了在 Antigravity 里用上 Argon 而盲目升级昂贵的 Ultra 套餐。把那些容错率极低、需要一次性立住复杂后端架构的硬骨头继续留在 Claude Opus 5.5 手里;与此同时,把长篇财报与法务文档综述、多模态图表视频解析、前端交互原型生成,以及需要低成本高频调用的 API 工作流交给 Gemini 4 Argon。认清不同模型背后的工程假设,让最趁手的工具待在最匹配的工位上,大概比争论谁是“地表最强”更有实际价值。
跑分破纪录、内部重写百万行代码,为什么程序员实测 Gemini 4 还是觉得不如 Claude? Share on X