拒绝“PM 缝合怪”与半成品魔法:揭秘 Meta 打造现象级 Agent 的内部方法论
Meta 用七个月打磨 Muse 证明,个人 Agent 真正的门槛不是偶发的“魔法时刻”,而是把大模型的非确定性收敛进可控、稳定的工程体系。百项指标、严格评测、克制组织与统一产品审美,才是用户愿意持续托付真实任务的关键。
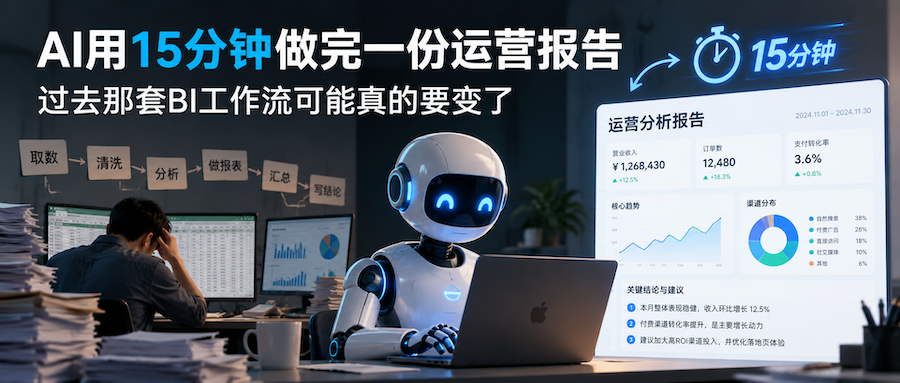
AI用15分钟做完一份运营报告,过去那套BI工作流可能真的要变了
AI数据分析正在改变传统BI工作流。我用DeepSeek Harness通过MCP连接生产数据库,15分钟生成了一份运营报告,并由此发现:最先被AI压缩的,可能是企业大量重复的报表生产工作。
Muse、dots都来了,但Personal Agent到了中国可能要换一种玩法
Muse和dots代表的Personal Agent,可能正在挑战中国超级App长期形成的封闭生态。真正的变化,不只是AI替用户办事,而是用户能否授权Agent跨平台调用自己的数据和服务;这也可能推动平台从“圈住用户”转向按数据和能力调用收费,并重新给中小创业者机会。

当AI Agent开始交付结果,谁来决定什么是“好结果”?
AI Agent越来越擅长把事情做完,但并非所有工作都有可量化、可验证的“好结果”。当生成与执行越来越便宜,真正稀缺的将是定义目标、判断优劣和做出选择的能力。未来人的价值,可能更多集中在“做什么”以及“什么才算好”。

Kimi、GLM和Claude的差距,为什么每个人感受完全不同?
Kimi、GLM与Claude的能力差距真实存在,但不会平均体现在所有任务中。任务越模糊、链条越长、越依赖模型自主判断,Claude优势越明显;任务拆解越充分、Agent与人工控制越成熟,国产模型的实际差距就越容易缩小。

DeepSeek V4 Flash只差GPT-5.6 Luna 1分,价格却低了一大截,AI模型开始争夺“用得最多”
DeepSeek V4 Flash以接近主流闭源模型的能力和更低价格,切入Agent执行层。它未必是最强模型,却可能凭借低成本、开放权重和高频调用,成为AI时代用得最多的模型之一。

最强的模型,不一定能赢:AI Coding开始拼“好用”了
最近几天,AI Coding领域最热闹的事情,除了GPT-5.6发布,就是OpenAI不断为Codex和Cha […]

程序员只有两百万,为什么 AI Coding 却成了大市场?
AI Coding正从服务程序员的开发工具,演变为面向所有知识工作者的通用生产力工具。代码逐渐退到后台,自然语言成为新的操作界面。它最大的市场,不是喜欢写代码的人,而是那些不想写代码、只想把事情做成的人。