Gemini 4 Argon已经开始赢跑分了,但真正的考试还没开始
9月30日,Google终于发布了Gemini 4这一代的旗舰模型Argon。
我看到消息后第一件事,其实不是去研究那张Benchmark表,而是想找地方试一下。因为我现在日常开发里,大量代码和具体任务都已经交给AI完成,一个新模型到底好不好用,我通常更愿意拿几个真实项目跑一遍。结果这一次不行:Google把模型、跑分,甚至API价格都公布了,但Gemini 4 Argon目前还没有开放给普通用户和普通开发者。
现在真正能用上它的,是Google通过Fairwind Program选择的一批网络安全防御者。Google表示,之后会逐步扩大到开发者、企业和消费者,第一批包括付费API客户和Google AI Ultra用户,但没有给出明确的公开时间表。
这让我觉得这次Gemini 4的发布挺有意思。
从已经公布的成绩看,Argon确实很强,一些指标甚至重新把Gemini推到了第一。但另一方面,大多数人现在讨论的“Gemini 4有多强”,其实仍然建立在Benchmark和少量早期测试上。我们知道它已经开始赢跑分,却还不知道它进入真实工作以后到底怎么样。
Google给出的解释是安全。
我相信这不是一个完全虚构的理由。但如果把今年Google整个旗舰模型的发布时间线放在一起看,我也很难相信,9月30日这个时间点与越来越激烈的模型竞争完全没有关系。
Gemini 4这次的成绩很好,但并不是所有项目都赢了
先说模型本身。
Google给Gemini 4 Argon的定位已经不是过去那种更聪明的聊天模型,而是专门针对长时间、复杂工作流设计的Frontier Model,重点放在软件工程、金融和法律这样的专业知识工作,以及网络安全。
这也反映在它公布的成绩里。
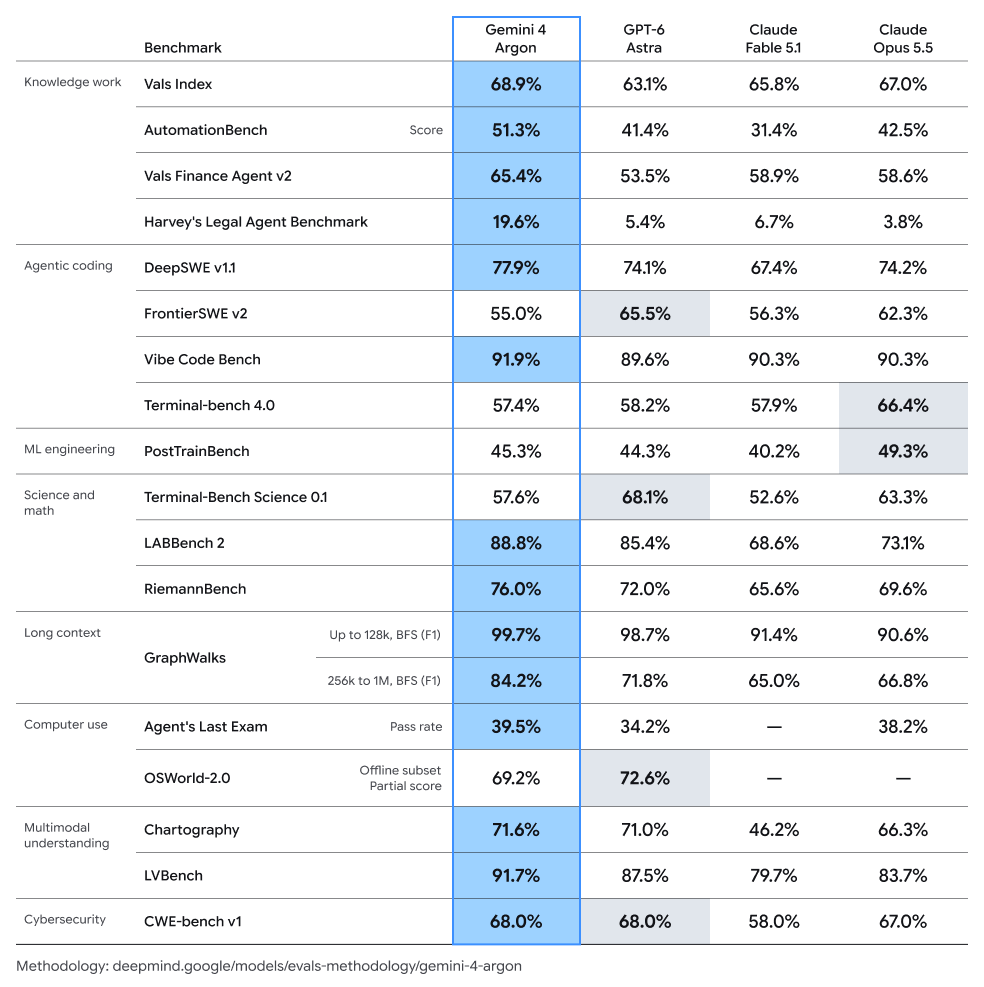
在DeepSWE v1.1这个长周期软件工程测试中,Argon拿到77.9%;Zapier用来测试端到端企业任务执行能力的AutomationBench是51.3%,排名第一;在Vals Index中,它得到68.9%,同样排在第一。金融领域的Vals Finance Agent v2以及长视频理解LVBench,Argon的表现也相当突出。
Google甚至把单次输出Token上限从此前的64K直接提高到了100万。对于普通聊天来说,这个数字没有太大意义,但放在Agent里就不一样了。模型可以在一次长任务里进行大量推理、调用工具、修改代码再重新验证,而不用频繁中断上下文。Google内部已经让Argon Agent做C/C++到Rust的大规模代码迁移,其中包括超过80万行代码的Fuchsia Zircon内核;另一组Agent分析数据中心的性能数据后,Google称最终释放了超过300 TiB内存。
这些案例至少说明,Argon并不是一个只为了刷考试成绩做出来的模型。
但如果仔细看完整结果,又不能简单得出“Google已经全面超过OpenAI和Anthropic”的结论。Reuters也特别提到,在Google自己选择公布的四项Coding测试里,Argon有两项并没有领先。
第三方数据也差不多。
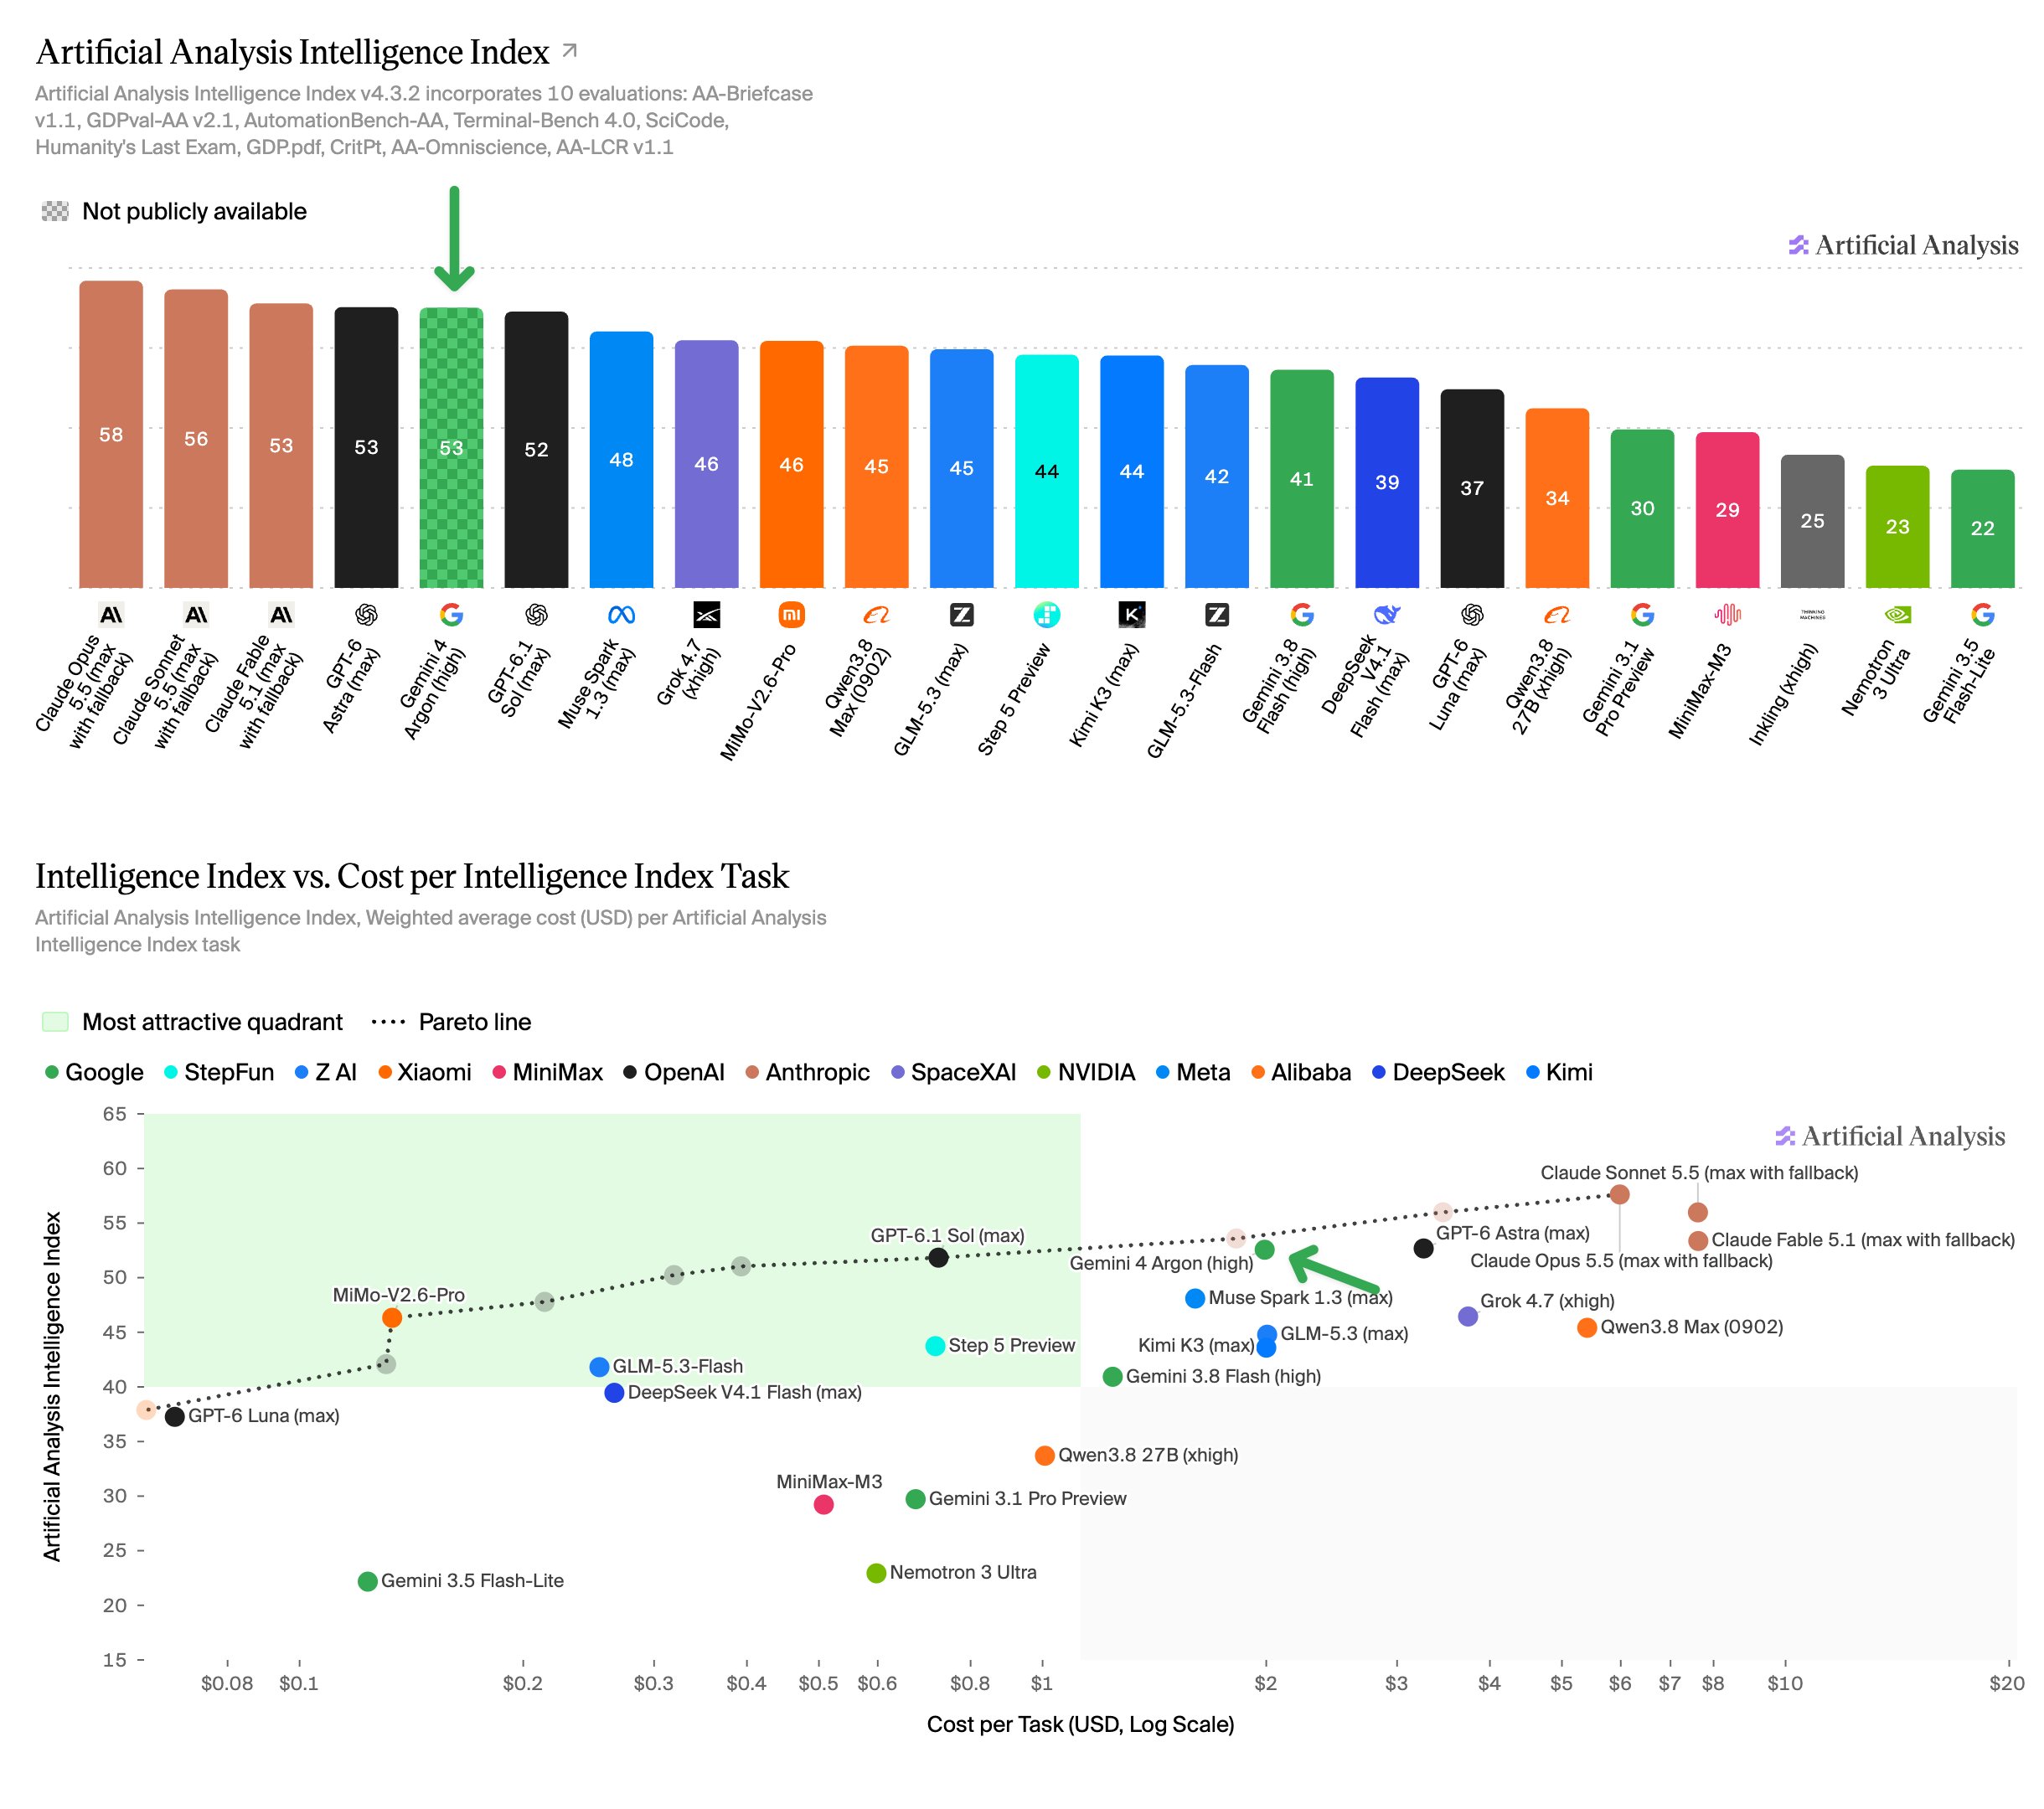
Vals目前把Argon放在综合Index第一,但在Code Migration中排名第二,CyberBench第二,Legal Research第四,一些任务甚至更低。Artificial Analysis给Argon High的Intelligence Index是53分,在223个模型中排第8。换句话说,这不是一款靠Google自己发布会才显得很强的模型,第三方测试同样证明它已经处于第一梯队;但“第一梯队”和“所有事情都是第一”,显然还是两回事。
我反而比较喜欢这样的结果。
如果Gemini 4一发布,所有测试恰好全部第一,我可能还会更谨慎一点。现在这种有赢有输的状态,至少更像真实世界中的模型差异。
Google说暂时不开放是为了安全,这个理由并不牵强
Argon公布以后,一个很自然的问题是:既然模型已经训练好了,内部也用了这么久,为什么不直接开放?
Google给出的理由非常明确——安全。
而且这一次不是简单说一句“我们重视AI安全”就结束了。
Argon专门强化了网络安全能力。Google称它可以自主发现、验证并修复软件中的严重漏洞。在CWE-bench v1上得到68%,并列第一。网络安全公司Wiz通过Google的Fairwind Program测试Argon时,还让它发现了一个医疗软件中的严重漏洞,而此前一些Frontier Model没有找到。
问题也恰恰出在这里。
一款更擅长找漏洞的模型,对防御者很有价值,对攻击者当然也一样有价值。所以Google目前只向经过筛选的安全团队提供解除部分Cyber Guardrail限制的Argon,同时继续完善四类防护:恶意使用检测、间接Prompt Injection、Agent行为失配监控,以及高风险任务运行环境的Sandbox加固。Google还让Argon参加了美国政府的预发布模型访问流程。
我并不认为这些工作只是为了给延迟发布找理由。
现在的Agent和两三年前的聊天机器人已经不是同一种产品。以前模型回答一个危险问题,风险主要停留在“它说了什么”;今天的模型可以打开终端、写代码、访问网络、连续执行几十甚至几百个步骤,风险已经变成了“它会做什么”。
OpenAI自己的做法也说明这种担心并非Google独有。9月29日刚发布的GPT-6.1 Sol,在OpenAI的Preparedness Framework里就被评为网络安全Critical级别,并沿用了Astra的安全措施。
所以,如果问我Google是不是真的因为安全而暂缓Gemini 4大规模开放,我更倾向于认为:至少从目前披露的技术细节看,这个理由是成立的。
但这只解释了“为什么还不能全面开放”,并没有完全解释另一个问题:既然还没有准备好,为什么一定要在9月30日宣布?
安全可以让模型晚一点开放,竞争却不允许Google继续沉默
把时间往前倒几个月,这个问题就清楚多了。
Google原本准备推出的旗舰模型不是Gemini 4 Argon,而是Gemini 3.5 Pro。Sundar Pichai此前曾表示,这款模型预计在6月推出,但时间到了以后始终没有发布。7月份Reuters援引报道说,Gemini 3.5 Pro没有达到Google内部目标,特别是在Coding方面,因此发布时间被推迟。到Gemini 4 Argon发布当天,Google终于确认,Gemini 3.5 Pro已经不再计划发布。
与此同时,竞争对手没有停下来。
Anthropic在9月22日发布Claude Opus 5.5,9月28日又发布Sonnet 5.5;OpenAI在9月22日发布GPT-6 Sol和Luna,9月29日紧接着推出GPT-6.1 Sol。也就是说,Gemini 4 Argon发布前的一周,几家Frontier Lab几乎都在密集更新自己的主力模型。
所以我不太愿意把Google这次的选择解释成一个简单的阴谋故事:模型没准备好,于是拿安全当借口,先发跑分抢头条。现有证据并不能支持这么重的判断。
但另一方面,如果认为竞争压力在这里完全不起作用,也不太符合现实。
Google已经几个月没有交出原计划中的新旗舰,Gemini 3.5 Pro最后干脆被取消,而Anthropic和OpenAI还在持续更新。对于一家Frontier Lab来说,这时候“什么时候能够证明下一代模型已经存在”,本身就是竞争的一部分。
一个很有意思的细节是,Google甚至连Argon的价格都已经公布了:推广期每百万Token输入2美元、输出10美元,之后恢复到4美元和20美元。前一个价格刚好与GPT-6.1 Sol的标准价格处于同一水平,后一个价格则与Claude Opus 5.5一致。模型还没有真正走到普通开发者面前,性能、价格和市场定位其实已经开始竞争了。
这可能才是Gemini 4 Argon这次发布最值得观察的变化:一款模型“被发布”和“真正可用”,正在变成两个不同的时间点。
先公布能力,先进入排行榜,让第三方测试,让少量可信用户开始使用,再根据真实反馈和安全测试逐渐扩大范围。对于Google来说,这样做既没有完全放弃安全上的谨慎,也不需要因为安全工作尚未结束,就在模型竞争中继续保持沉默。
安全和商业竞争,在这里并不是二选一。
以后判断一个模型,可能需要看两张成绩单
这也是为什么我现在对Gemini 4 Argon的态度是期待,但不会因为几张Benchmark表就直接得出结论。
我平时实际使用Coding Agent时越来越明显地感觉到,模型在一次测试中能不能答对一道题,与它能不能把一个真实项目连续做几个小时,是两种能力。
真实使用中还有很多Benchmark不容易完全反映的问题:它能不能正确理解一个陌生代码库,连续几十次修改以后会不会把前面的约束忘掉,工具调用失败以后能不能自己恢复,会不会为了完成任务偷偷绕开要求,以及模型变得更谨慎以后,会不会又因为Guardrail太多而影响正常任务。
还有速度和价格。
一个模型能力高5%,如果推理时间增加一倍、Token消耗增加三倍,对大规模Agent任务来说,最终可能根本不是更好的选择。
所以我现在更愿意把模型的成绩分成两张表。
第一张是Capability:Benchmark、第三方Evaluation、安全测试,它告诉我们模型的能力上限在哪里。Gemini 4 Argon目前这张成绩单已经很好看,而且不仅是Google自己说好,Vals等第三方结果也基本证明它重新回到了最强模型的竞争区间。
第二张则是Product:真实项目、Agent长任务、稳定性、响应速度、成本,以及连续使用几周以后形成的体验。
Gemini 4现在还没有参加这场考试。
这两年我对各种“最强模型”的判断也越来越谨慎,因为每一代模型发布时,总能找到几个特别漂亮的数字。但等真正拿来写代码、查资料或者跑Agent以后,经常会发现模型之间的差异并不按照排行榜的顺序排列。有些模型考试厉害,却不一定适合长时间工作;有些模型Benchmark没有领先,在自己的工作流里反而更稳定。
Gemini 4会不会也是这样,现在谁都不知道。
9月30日看到Argon发布时,我其实还是挺高兴的。Gemini一直是我比较期待的一条模型路线,尤其Google同时拥有模型、TPU、Cloud、Search、Workspace和Android,它理论上比很多纯模型公司更有条件把AI真正变成产品。
这次Argon至少已经证明了一件事:Google没有因为Gemini 3.5 Pro的延期而掉出Frontier Model的竞争。
至于Google这一次先公布、后开放,究竟有多少来自安全考虑,又有多少来自竞争压力,我觉得没有必要强行选一个答案。安全问题是真实存在的,而在GPT和Claude连续更新之后,Google同样需要尽快证明自己的下一代旗舰模型已经来了,这两件事完全可以同时成立。
我现在更关心的是另一件事。
Google已经用Benchmark把Gemini 4 Argon的期待拉得足够高了。接下来不需要更多漂亮的排行榜,而是应该尽快把它真正交到用户手里。
到那个时候,Gemini 4真正的考试才算开始。