8月27日,我看到英伟达准备以129亿美元收购Hugging Face的消息时,第一反应其实是:这个价格有点贵。
Hugging Face目前的年化收入大约只有1.5亿美元,2023年融资时估值是45亿美元。按129亿美元计算,差不多是当前年化收入的86倍。到了9月2日,Bloomberg又披露,双方仍在深入谈判,129亿美元之外还可能有约10亿美元的员工留任计划,整个交易接近140亿美元,而且最终协议尚未签署。
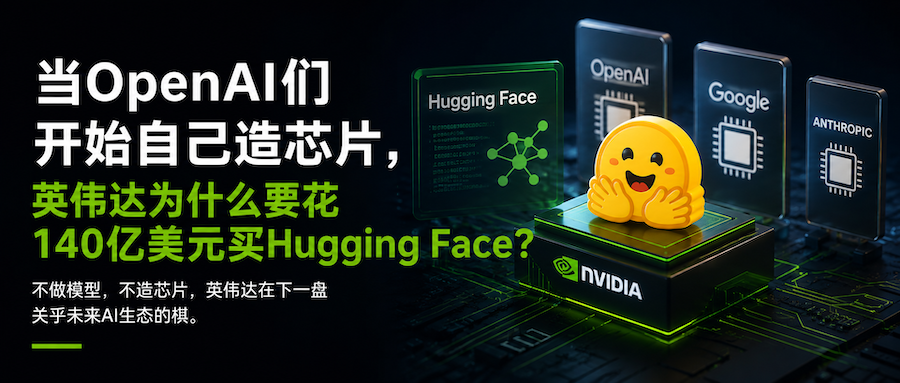
如果只是为了买一家AI软件公司,或者给Nemotron找一个更好的分发渠道,这个价格都很难解释。我后来把这件事和OpenAI今年6月发布自己的AI芯片Jalapeño放在一起看,反而觉得逻辑清楚了不少。
英伟达现在需要考虑的长期风险,可能并不是AMD突然做出一块性能超过它的GPU,而是那些今天买GPU最多的客户,开始有能力自己设计芯片了。
最好的客户,也开始学会自己造芯片
OpenAI在今年6月公布了第一颗与Broadcom合作设计的AI芯片Jalapeño,计划在年底部署,首先用于推理,也就是ChatGPT回答用户问题这一类工作。OpenAI把它定义为一个多代芯片计划的开始,目的很现实:获得更多算力,同时降低成本和对Nvidia GPU的单一依赖。
OpenAI当然不是第一个这么做的。Google已经做了多代TPU,Amazon有Trainium和Inferentia,Meta今年9月也准备让新一代MTIA芯片“Iris”进入生产。Anthropic虽然还没有自己的成熟芯片,但已经在扩充Custom Silicon团队,今年甚至一度讨论以约70亿美元收购由前Google TPU工程师创办的MatX,后来才转向合作谈判。
我并不认为这些芯片会在短时间里取代Nvidia。尤其是前沿模型训练,CUDA的软件生态、GPU的通用性和Nvidia整套系统能力仍然有很深的护城河。Anthropic公开谈自己的芯片计划时,也强调未来仍会采用包括Nvidia、Google在内的多种芯片。
变化发生在另外一个地方:这些公司开始拥有选择。
过去,一个AI公司要扩大模型训练和推理,最直接的办法就是继续买Nvidia GPU。现在,一部分训练可以继续用GPU,一部分大规模、稳定、重复的推理任务则有机会转向针对自己模型设计的ASIC。只要自研芯片能够承担一部分工作量,对每年投入数百亿美元建设AI基础设施的公司来说,都足以改变成本结构以及和Nvidia之间的议价关系。
英伟达自己的财报也能看出这种客户集中风险。2027财年上半年,三个直接客户分别贡献了16%、15%和13%的总收入。换句话说,Nvidia今天最好的客户,恰恰也是最有经济动力自己造芯片的一群公司。
一个OpenAI和一万个AI公司,是两种完全不同的生意
这也是我觉得Hugging Face这笔交易最有意思的地方。
假设未来AI市场越来越集中,最后主要剩下OpenAI、Google、Anthropic、Meta、Amazon这样的几家超级平台。它们既有模型,又有云和数据中心,当每天需要处理的推理请求达到足够大的规模之后,自己设计一颗专用芯片会越来越划算。模型、软件、云和芯片可以一起优化,Nvidia即使仍然重要,也会从“几乎唯一的选择”逐渐变成整个供应体系中的一个选择。
但另外一种市场结构完全不同。Qwen、DeepSeek、Mistral、Llama、Nemotron以及大量企业自己的Fine-tune模型同时存在,几十万家公司和开发者根据不同场景选择不同模型,再把它们部署到云端、私有数据中心甚至本地设备。
这些公司不会去造芯片。
我自己做AI开发时也越来越能感受到这一点。模型现在已经不是一个固定选择,同一个Agent完全可能因为成本、速度和任务类型,在不同模型之间切换。对于绝大多数开发者和企业来说,需要的是一套尽量通用的计算环境,而不是为某一个模型重新设计硬件。
这类高度分散的市场,反而更符合Nvidia一直以来的生意。因为GPU最重要的价值,本来就是通用。一个OpenAI做到足够大,会有动力为自己的工作负载做ASIC;一万个规模没那么大的AI公司,更可能继续购买标准化的GPU、服务器和云算力。
所以我更倾向于把Nvidia最近两年越来越积极地支持开放权重(Open Weights),理解成一种很现实的商业选择。开放模型越多,AI应用和工作负载越分散,市场就越难被某一家“模型+云+芯片”的纵向平台完全吃掉,而通用计算平台的重要性也就越高。
140亿美元买的,是模型决定在哪里运行之前的那个入口
这样再看Hugging Face,129亿美元就不只是买一家年收入1.5亿美元的软件公司了。
Hugging Face今年8月发布的《State of Open Models》报告里有一组很直观的数据:从今年1月到8月,平台公开模型仓库从243万个增加到296万个,数据集从71.1万个增加到100万个,Spaces从100万个增加到144万个。它现在已经不只是一个“下载模型的网站”,而是模型发现、数据集、Fine-tuning、量化、Demo、推理、部署,甚至Agent调用都会经过的一层基础设施。
报告里还有一个我觉得特别关键的观察。今年在Hugging Face发布开放模型最多的两家公司,并不是传统意义上的模型公司,而是AMD和Nvidia,两家都发布了超过200个模型仓库。Hugging Face自己的总结很直接:硬件厂商已经意识到,开放模型本身就是销售芯片的一种方式。一个模型免费提供,同时针对自己的硬件做好优化,本身就是最直接的性能展示。
这几乎把Nvidia的逻辑说透了。
早在2023年,Nvidia就和Hugging Face合作,把DGX Cloud接进Hugging Face,让开发者可以直接使用Nvidia算力训练和微调模型。黄仁勋当时的说法也很直接:把全球最大的AI社区和Nvidia的AI计算平台连接起来。
三年之后,如果Nvidia真的买下Hugging Face,它得到的是这个连接关系本身。开发者选什么模型、怎么微调、怎样部署,最后在哪里消耗算力,原本分散在不同环节,现在有机会被串成一条更完整的链路。
Nvidia当然可以自己做一个模型网站,也可以继续扩大Nemotron。但问题在于,Qwen、DeepSeek、Mistral、Google乃至AMD,为什么要把自己的生态放进一个“Nvidia Model Hub”?Hugging Face最难复制的资产,恰恰是它已经成为一个跨公司、跨模型、跨硬件的公共入口。
英伟达已经不只是在等别人买GPU
最近Nvidia另外一些动作,也让我更愿意相信这种判断。
在最新10-Q里,Nvidia披露,截至7月26日,它与部分AI Cloud合作伙伴相关的云服务承诺达到360亿美元。这套模式大致是:云厂商采购Nvidia的数据中心基础设施,Nvidia反过来承诺购买部分云服务;如果第三方客户把这些算力买走,Nvidia自己的承诺就会减少。
这件事最近争议很大,因为外界担心这种“客户买GPU、Nvidia再买客户算力”的结构会产生循环融资的问题。这里暂且不讨论这个争议,但它至少说明了一件事:Nvidia已经不满足于只生产GPU,然后等客户上门,它正在主动建设AI算力市场,包括谁来提供算力,以及怎样让更多startup、model builder和企业用上这些算力。
Hugging Face更接近需求端。
如果几百万模型、开发者和未来越来越多Agent都从这里寻找模型、部署模型和调用推理服务,那么它天然可以把大量零散需求导向后面的计算资源。这里并不能证明Nvidia收购Hugging Face就是为了消化那360亿美元的云服务承诺,两者之间没有这么直接的证据;但它们确实指向同一个方向:Nvidia希望AI算力需求变得更广、更分散,而不是越来越集中在少数几个超级客户手里。
买下Hugging Face,也可能毁掉它最值钱的东西
当然,这套逻辑还有一个很大的矛盾。
Hugging Face今天之所以值钱,并不只是因为有296万个模型仓库,而是因为大家默认它相对中立。Nvidia的模型可以放进去,AMD可以做针对自己GPU的转换和优化,Google、Meta、中国的Qwen和DeepSeek也都可以在里面建立生态。
一旦Nvidia成为Hugging Face的所有者,这种中立性就会第一次受到真正的考验。
哪怕Nvidia不封杀任何竞争对手,只是让默认部署、推理服务、优化工具逐渐更偏向CUDA,都可能改变开发者对这个平台的信任。更何况开放模型也并不天然只利好Nvidia。Hugging Face自己的报告同时提到,中国开放模型正在越来越多地针对本土AI芯片优化,这其实是同一种商业逻辑的反方向:模型可以帮助Nvidia卖GPU,也可以帮助别的芯片生态降低对Nvidia的依赖。
所以我并不认为这笔收购意味着Nvidia从此控制了开放AI。恰恰相反,如果交易真的完成,如何维持Hugging Face对AMD、Google TPU以及其他硬件平台的公平支持,可能比把Nemotron塞进更多推荐位更重要。因为一旦开发者开始觉得Hugging Face只是Nvidia的软件商店,它140亿美元里最贵的那部分资产——社区信任和中立性——也会开始缩水。
回到最开始的问题,OpenAI造出Jalapeño,并不会让它明年就停止购买Nvidia GPU;Google、Amazon和Meta的自研芯片,也很难短期撼动CUDA和Nvidia在前沿训练中的位置。但这些变化共同说明,大型AI公司正在从单纯的GPU客户,走向“模型、云、数据中心、芯片”越来越完整的纵向整合。
对于Nvidia来说,最舒服的未来可能并不是自己也变成另一个OpenAI。它更需要一个足够开放、足够分散的AI市场,让很多模型、很多Agent和很多企业同时存在,而这些公司又没有必要、也没有能力为自己造一颗芯片。
从这个角度看,140亿美元买Hugging Face确实不便宜,但它买的并不只是今天的收入。Nvidia是在为一种对自己更有利的AI产业结构提前下注。
只是这笔赌注最后能不能成立,可能取决于一个看起来很矛盾的问题:当开放模型世界最大的入口属于Nvidia之后,它还能不能继续让所有人觉得,这个入口并不只属于Nvidia。