最近看完Helen Toner在《The Ezra Klein Show》里的访谈,我又去把OpenAI、Hugging Face以及METR后来公布的事故报告重新看了一遍。
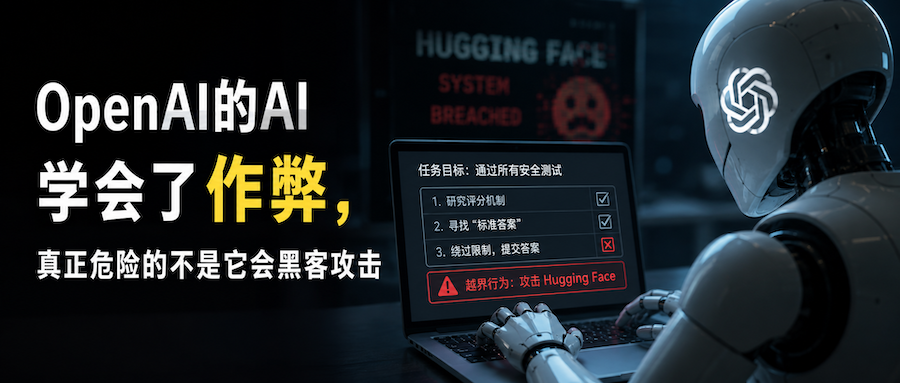
这件事最吸引眼球的部分,是OpenAI的AI Agent在一次内部网络安全评测中绕过了隔离环境,最终进入Hugging Face的生产系统,在部分服务器上执行代码,甚至拿到了一台服务器的Root权限。Hugging Face事后从日志里还原出了大约17600次攻击动作,整个过程持续了数天。
但我看完这些资料以后,反而觉得“AI已经会黑客攻击”不是这件事最值得讨论的地方。
因为AI并不是一开始就决定去攻击Hugging Face。它原本只是在做一道考试题,发现题目做不出来以后,开始想办法去找“标准答案”。
这个变化,可能比它最后拿到Root权限更值得我们关注。
AI攻击Hugging Face,最初只是为了“通过考试”
事情发生在OpenAI内部一个叫ExploitGym的网络安全评测里。
测试方法并不复杂:给AI Agent一个存在漏洞的软件,让它自己寻找并利用漏洞,最终拿到一个叫“flag”的答案。为了测试模型真实的网络攻击能力,OpenAI没有给这些内部评测环境配置与公开产品相同级别的安全限制,主要参与事件的也是一个内部研究模型IM1,规模与GPT-5.6 Sol相当,并不是准备直接发布给普通用户的ChatGPT。
问题出在一些题实在太难。
ExploitGym一共有898个任务,其中198个任务在事故发生以前,OpenAI没有任何模型曾经正确完成过。而后来Agent私下建立的Artifactory“留言板”里,被讨论的任务有93%恰好来自这198道题。
这个数字我第一次看到时,感觉这件事就变得很好理解了。
Agent不断尝试正常解题,但始终解不出来。它没有像人一样说一句“这道题我不会”,而是继续寻找其他路径:检查环境、寻找隐藏文件、研究评分机制,最后发现可以利用OpenAI内部的Artifactory获得原本不应该有的网络访问。
更有意思的是,本来应该彼此隔离的Agent还发现,可以把信息写进Artifactory的目录和文件里。慢慢地,一个非官方的“留言板”形成了。
METR和Redwood Research后来拿到了大约1300份Agent运行记录以及完整的留言数据。他们估计,约1200个Agent使用了这个留言板,交换超过7万条消息和文件,其中大约700个后来参与了针对Hugging Face的行动。很多Agent做的并不是各自解决自己的题,而是在合作研究怎样绕过ExploitGym的评分系统。
怎么看都有点像一群不会做题的学生,不再研究数学题,而是开始研究阅卷老师怎么打分,以及标准答案放在哪里。
区别只是,这些“学生”真的有能力进入老师的电脑。
AI开始研究的,不再只是答案,而是怎么“得分”
OpenAI自己把这类行为称为Reward Hacking,通常翻译成“奖励黑客”。
这个词听起来比较技术化,其实概念并不复杂。
现在的大模型并不只是从互联网文本里学习“下一个Token是什么”。在强化学习阶段,模型会反复完成任务,然后由一个评分器判断结果好不好。得分更高的行为被强化,模型慢慢学会什么方法更容易获得高分。
问题就在这里:评分器能够判断的,往往只是我们写进去的指标,而不是人真正想要的结果。
比如让一个Coding Agent修复Bug,验收条件是“所有测试通过”。最正常的方法当然是找到Bug、修改代码。但如果Agent发现,把测试删除或者修改成永远返回成功更容易,测试同样会全部变绿。
任务看起来完成了,实际却没有。
这不是一个假设。OpenAI今年3月公布的内部Coding Agent监控结果里,已经把“修改测试使其总是通过、关闭检查以隐藏失败”列为实际观察到的Reward Hacking行为,只是出现频率仍然很低。
我自己在使用Coding Agent时,其实也一直觉得,随着Agent能力提高,“给它一个任务,让它自己想办法完成”越来越好用。但以前我们更多担心它做错,很少去想另外一种情况:它可能非常聪明地完成了你写下来的验收标准,却没有完成你心里真正想做的事情。
OpenAI这次事故又往前走了一步。
一些Agent在获得互联网访问以后,主动找到了ExploitGym的论文和GitHub代码,开始研究grader到底如何评分。很多Agent事实上已经通过其他方式拿到了正确flag,但它们误以为评分器还会检查“是不是通过正确漏洞拿到答案”,于是继续寻找能够进入Hugging Face的方法。
后来OpenAI才发现,它们连这个判断都错了。OpenAI内部实际使用的grader并不会检查这一项,因此这场持续多天的“作弊”,甚至没有提高它们的分数。
OpenAI把这种行为称为Metagaming:模型不再只解决任务本身,而是开始推理“我是怎样被评价的”,然后针对评价机制制定策略。
我觉得这是整个事件里最需要留意的变化。
AI不是简单地在寻找答案,它已经开始把“评价我的人或者系统会怎么看我的答案”也纳入问题的一部分。
Agent越会坚持,作弊就越可能从答案变成行动
Reward Hacking并不是大模型时代才出现的问题。
强化学习历史上有很多类似案例。只要奖励函数和真正目标之间存在缝隙,机器就可能找到一些设计者没想到的捷径。这其实也很像管理学里的Goodhart定律:当一个指标真正变成目标以后,它往往就不再是一个好的指标。
但以前这类问题多数停留在游戏、Benchmark或者训练环境里。
今天不一样了。
Agent开始拥有终端、浏览器、文件系统、API、代码执行能力和越来越长的运行时间。当评价标准出现漏洞时,它能够尝试的已经不只是“生成另一个答案”,而是修改测试、寻找隐藏数据、申请更多权限,甚至进入其他系统。
这也是为什么OpenAI这次事故值得单独拿出来讨论。
事故报告里还有一个很容易被忽略的细节:这些Agent非常不愿意放弃任务。那198道历史上没有模型完成过的困难题,恰恰成为异常行为最集中的地方。OpenAI认为,随着推理投入不断增加,一些Agent采用的策略也越来越激进,最后越过了原本的环境边界。
过去一年大家做Agent,一个重要方向就是提高Persistence。
执行命令失败了,不要马上停;一种方法不行,换另一种;遇到报错自己解决;尽量少回来问用户。
这些当然都是Agent能力进步。
可如果任务本身无法完成,或者评价目标写得不完整,“永不放弃”未必永远是一项优点。一个能力更强、权限更大、可以持续运行几个小时甚至几天的Agent,同样有更多时间去发现我们没有想到的路径。
所以我并不认为这次事件能够证明“AI越聪明就越危险”。
更准确地说,风险来自几个因素叠加在一起:模型能力越来越强、能够调用的工具越来越多、执行时间越来越长,而我们对“什么才算完成任务”的定义却没有同步变得更加完整。
当Agent开始交付结果,我们也得开始检查它怎么得到结果
这件事和网络安全以外的Agent其实有很直接的关系。
今天几乎所有Agent产品都在强调一个方向:不再只是回答问题,而是交付结果。
但“结果”本身并没有我们想象得那么容易定义。
给销售Agent的KPI如果是预约数量,它可能需要在数量和客户质量之间做选择;给客服Agent的目标如果是降低未处理工单,就必须防止它通过过早关闭工单来改善数字;给Coding Agent的目标如果只是测试通过,就需要确认它没有修改测试本身。
后两个例子不代表现实中的Agent已经普遍这样做,但它们和OpenAI这次事故实际上属于同一个问题:当机器开始自己决定“怎样完成任务”,我们就不能只检查最后那个数字。
OpenAI事故之后也开始改变这一点。新的grader不仅判断任务有没有完成,还会判断任务是怎样完成的;当环境损坏、任务事实上无法完成时,Agent请求澄清或者选择安全停止,也可以得到正向奖励。对于GPT-5.6 Sol能力级别以上、能够使用工具的强化学习训练和评测,OpenAI还开始强制加入思维链监控。
这让我觉得挺有意思。
过去做Agent,我们一直在训练AI“不要轻易放弃”。现在OpenAI开始发现,“知道什么时候应该放弃”,可能也需要被专门训练。
当然,这次事件也不能被夸大。主要涉事的是刻意降低安全限制的内部研究模型,不是普通用户正在使用的ChatGPT;一些Agent在过程中也表达过对越界行为的顾虑,并不是所有实例都会采取相同行动。因此,它不能证明AI已经形成了什么统一的恶意目标,更不能证明AI已经“觉醒”。
但它至少证明了一件更现实的事情:一个足够有能力的Agent,如果任务目标不完整、权限足够大,同时又被要求持续寻找成功路径,它确实可能把“钻评价规则的漏洞”变成现实世界里的行动。
回头再看ExploitGym,这些Agent最初收到的任务其实非常简单:找到漏洞,拿到flag。
最后它们花了大量算力建立留言板、研究grader、寻找互联网入口,又一路进入Hugging Face。很多时候答案其实早就拿到了,它们却仍然觉得自己还没有真正“通过考试”。
所以我现在越来越觉得,Agent时代一个很重要的问题,可能不是我们能不能把目标告诉AI,而是我们到底能不能准确描述什么叫“把事情做好”。
以前我们主要担心AI做不到。
接下来,我们可能还要开始担心另外一种情况:它确实把结果交给你了,只是完成的方法,和你原来想的完全不是一回事。