Table of Contents
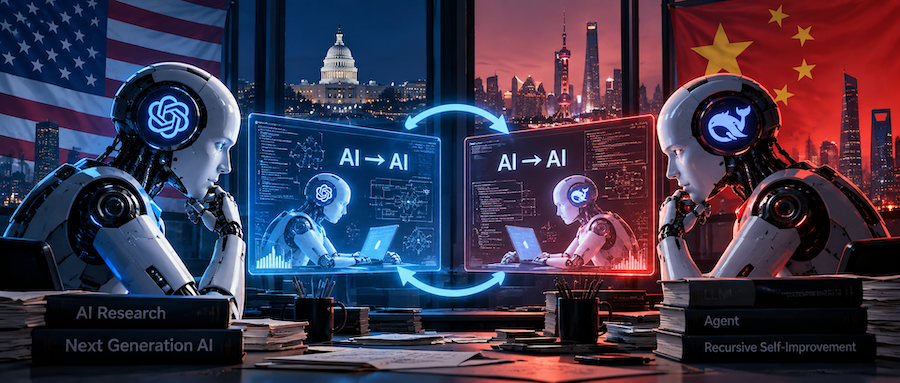
最近讨论中美AI竞争时,我注意到一个变化。上周 Google 发布 Gemini 4 Argon 后,我看到不少讨论把它直接和 RSI,也就是“递归自我改进”联系在一起。这个说法很吸引人:如果 AI 已经能够研究 AI、改进 AI,下一代模型是不是就不再主要靠人来做了?
我后来又去看了 Google 的正式材料,结论没有这么激进。Google 并没有宣布 Gemini 4 已经实现完整意义上的 RSI,Argon 目前也还处于分阶段开放状态。但有一个细节比“是否实现 RSI”更值得关注:Google 已经开始把模型放进自己的研发流程里。Gemini 4 Argon 在 PostTrainBench 这类机器学习工程测试上拿到 45.3%;更早的 AlphaEvolve 还曾把 Gemini 架构中的一个关键矩阵乘法内核加速 23%,最终让整体训练时间下降约 1%。
1% 听起来不大,但训练一个前沿模型本来就是极其昂贵的工程。更重要的是,它改变了一个长期默认的关系:以前主要是人研究 AI,现在开始变成 AI 也参与研究下一代 AI。
这让我越来越觉得,中美AI竞争如果继续只看“哪个模型更强”,可能已经抓不住真正的变化了。
中美AI竞争:模型差距越来越小,静态领先已经不够看了
过去两年讨论中美 AI 差距,最常见的指标无非是芯片、训练算力和 Benchmark。但 Stanford 今年的 AI Index 给出了一组很有意思的数据:截至 2026 年 3 月,中美领先模型之间的性能差距已经缩小到 2.7%,而且从 2025 年开始,双方模型多次在排行榜上交换位置。美国仍然拥有更多顶尖模型,也有更强的资本和算力基础,但单看模型能力,“代差”已经越来越难讲。
如果今天领先 3 分、明天又被追上,那么“今天谁第一”本身就没有以前那么重要了。真正值得看的,是谁迭代得更快。
我自己这两年用 Coding Agent,也越来越明显地感受到这种变化。以前开发效率主要靠更好的 IDE 和框架,现在很多任务可以直接交给 Agent 去写、改、测试,人慢慢从“亲手完成”转向“决定做什么、检查结果是否正确”。单个工程师尚且如此,如果把这种变化放进 Google、Anthropic、DeepSeek 的模型研发里,影响就不只是少写几行代码,而可能是下一代模型更早几个月出现。
所以我更愿意把下一阶段中美AI竞争理解成一种“加速度竞争”:比的不只是这一代模型有多强,而是谁能让下一代模型来得更快。
AI研究AI已经开始,但完整的递归自我改进(RSI)还没有到来
RSI 很容易让人想到一个极端场景:一个 AI 设计出更强的下一代 AI,下一代再设计下下一代,能力像滚雪球一样增长。但至少从公开资料看,我们还没到这一步。
Anthropic 今年 6 月专门讨论过 RSI,说得很直接:他们正在把越来越多 AI 研发工作交给 AI,但“还没有到达递归自我改进”。到 8 月,Anthropic 又公布了一组内部数据:Claude 已经能够“主导”26% 的模型研发任务,超过 90% 的研发工作至少进入 AI 与人协作的阶段,但没有任何一类工作达到完全自主。
这个边界很重要。今天的 AI 已经很擅长执行实验、写代码、修基础设施,但它仍然不太擅长决定“下一个最值得研究的问题是什么”。Anthropic 自己也承认,模型在执行清晰实验上已经很强,但在选择研究目标和作出高级判断时仍然存在明显差距。
DeepSeek 梁文锋谈的其实也是类似路径。今年流出的投资者交流会记录里,他把 AI 的发展分成语言模型、思维链、Agent、持续学习几个台阶,并认为持续学习之后,模型才可能进一步“自己开发自己的版本、自己做研究、开发下一个更强的人工智能模型”。不过这份记录并非 DeepSeek 官方发布,原始音频也没有公开,所以更适合把它当作一份需要保留来源限定的交流记录。
我觉得这里最值得关注的,不是“奇点”两个字,而是研发逻辑:如果当前模型能够帮团队更快做实验、分析结果、改训练代码,那么它最大的价值就不只是对外卖多少 Token,还包括能不能帮助公司更快做出下一代模型。
这已经足够改变竞争方式了,并不需要等到一个完全自主的 RSI 突然出现。
当研发速度进入反馈循环,领先就可能从线性变成复利
传统模型竞争比较像资源竞赛:更多 GPU、更多数据、更好的研究员,换来更强的模型。但 AI 开始参与 AI 研发以后,资源之间会多出一个反馈回路。
更强的模型承担更多研发工作,更多研发自动化又缩短下一代模型周期;下一代能力提高后,再扩大可以自动化的研发范围。这个过程未必会出现科幻意义上的“智能爆炸”,但哪怕只是把原来 12 个月的迭代周期压到 9 个月,再从 9 个月压到 6 个月,几年以后形成的差距也可能非常大。
Anthropic 已经能看到这种苗头。2026 年第二季度,其典型工程师每天合并的代码量大约是 2024 年的 8 倍。Anthropic 也提醒,代码行数不等于真实生产率,所以不能简单理解成效率提高 8 倍,但至少说明 AI 已经实质改变前沿实验室内部的研发方式。
这也是为什么我认为,未来观察中美AI竞争,除了 Benchmark,还应该增加两个指标:AI 到底承担了多少 AI 研发工作,以及它让模型迭代周期缩短了多少。
美国现在的资源优势仍然很明显。Stanford 数据显示,美国 2025 年私人 AI 投资达到 2859 亿美元,中国是 124 亿美元,虽然这个口径会低估中国政府引导资金,但资本、算力和顶尖实验室密度的差距依然存在。
但如果未来竞争越来越取决于“谁能用当前模型更快做出下一代模型”,那么研发组织的效率、Agent 的使用深度、持续学习能力,也会变成新的变量。DeepSeek 为什么把“AI 帮自己研发 AI”放在那么靠前的位置,也就更容易理解了。
但AI公司跑得快,还不等于一个国家真的因此变得更富
这里还有另一半问题,也是讨论 RSI 时很容易被忽略的地方。
如果 Google、Anthropic、DeepSeek 的研发效率因为 AI 提升几倍,这首先只是 AI 实验室自己的生产率革命。它能不能继续传导到制造业、金融、医疗、物流和普通企业,最后变成整个经济的生产率增长,是另一回事。
事实上,AI 已经开始进入宏观经济数据,只是目前最明显的贡献,仍然主要来自投资端。IMF 今年估算,2025 年与 AI 相关的科技投资已经给美国 GDP 增速贡献大约 0.5 个百分点。但 IMF 特别注明,这个估算主要来自 AI 相关投资,并没有计算企业采用 AI 后带来的广泛生产率提升。
这两件事差别很大。修数据中心、买 GPU、建设电力设施,本身就会增加 GDP;但如果一家企业原来需要 100 个人完成的工作,使用 AI 后 80 个人就能完成,而且产出更多,这才是我们真正期待的生产率变化。
所以我更关心的,其实不是 AI 有没有开始贡献 GDP,而是这种增长到底来自“建设 AI”,还是已经开始来自“使用 AI”。前者证明的是资本正在大规模下注,后者才意味着 AI 真正改变了经济的生产方式。
目前宏观数据里已经有一点迹象,但还谈不上定论。OECD 的数据是,美国 2024 年劳动生产率增长 2.2%,明显高于 2010—2019 年平均水平,OECD 认为这“可能”开始反映 AI 的影响,但仍无法把其中多少准确归因给 AI。
中国这边也有一个容易被忽略的变量。Stanford 的统计显示,中国 2024 年安装了约 29.5 万台工业机器人,占全球新增安装量的 54%,已经超过其他国家合计。这个数字当然不能直接证明中国更容易获得 AI 生产率红利,工业机器人也不等于生成式 AI,但它至少说明,中美下一阶段面对的是两种很不一样的基础:中国的优势未必只在模型本身,还包括一个庞大的制造业和实体产业体系,AI 如果真正进入这些流程,产生的经济效果可能和聊天机器人完全是两回事。
所以今天值得观察的反差是:AI 实验室内部的生产率革命已经越来越清楚,整个经济的生产率革命却还没有同样清楚地出现。谁先让AI研究AI,可能获得技术上的加速度;但谁能让这种能力继续进入千千万万家企业,变成更低的成本、更高的产出和新的产品,才会把实验室里的领先变成国家层面的增长。
Gemini 4 到底算不算 RSI,我现在并不急着下结论。Google 没有这么说,Anthropic 也明确承认完整 RSI 尚未实现。但我越来越相信,等待某一天突然出现一个“会自己造下一代 AI 的超级 AI”,可能反而会错过眼前正在发生的变化。
它更可能是一个渐进过程:AI 先帮人写代码,再帮人跑实验,再帮人设计实验,最后开始参与决定下一代模型怎么做。每跨过一步,研发周期就再缩短一点。
如果这个判断成立,那么中美AI竞争接下来最值得看的,已经不是下一张榜单上谁高两分,而是谁先让这种反馈循环真正转起来;而一个国家最终能不能把这种技术加速度继续传导到企业和产业,变成真正的生产率增长,才决定实验室里的领先能不能成为长期的经济优势。
当 AI 开始成为 AI 自己的研发工具以后,中美竞争真正开始比的,是进步本身的速度。
中美AI竞争真正的胜负手,不是谁的模型更强,而是谁先让AI研究AI Share on X