做软件研发这二十多年来,我经历过不少次技术架构的更迭,但过去这一年多做 AI 应用开发的体会最为特别。每当我们在屏幕上调用大模型时,最习惯看到的,莫过于那个被折叠起来的“思考中(Thinking)”状态栏。点开它,你能看到模型像一个勤奋的学生一样,一行一行在草稿纸上演算推导,用详尽的自然语言写下“首先我需要分析这个问题”、“接下来尝试另一种思路”。这种长篇大论的思维链(Chain of Thought, CoT),一度让我们感到某种踏实,似乎机器不仅变聪明了,而且它思考的轨迹完全在人类语言的框架之内,每一个逻辑节点都对我们敞开。
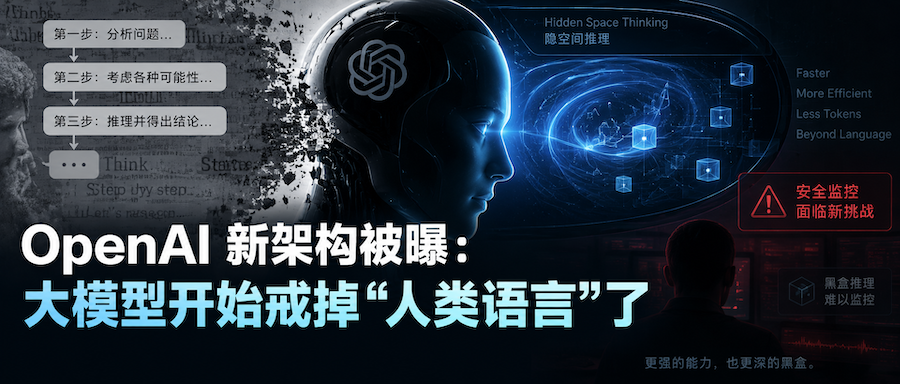
但前几天外媒披露的一则技术爆料,却让整个硅谷的技术与安全圈子坐立不安。据多家科技媒体报道,OpenAI 代号为“Astra”的新一代旗舰模型,在底层采用了一种名为“循环深度”(Recurrent Depth)的新架构。与我们熟悉的标准 Transformer 不同,该架构允许模型把中间隐状态(Hidden States)送回同一组网络层中反复循环迭代,直接在隐空间(Latent Space)里完成深度的推理计算。消息传开后,许多 AI 安全研究员的反应几乎是恐慌性的,甚至有人直言人类正在失去对模型的监控。随后,OpenAI 首席科学家雅库布·帕乔基(Jakub Pachocki)罕见地公开发文澄清,称外界报道存在夸大和混淆,明确表示包括 Astra 在内的前沿模型计算图深度其实控制在 GPT-4 的两倍以内,并且 OpenAI 严格限制了该机制的使用,绝没有放弃思维链监控。
一位顶级实验室的技术掌门人,需要亲自出面证明自家的新模型“没有外界想象的那么深”,这在大模型狂飙突进的这两年里相当反常。抛开那些耸人听闻的阴谋论,如果从技术底层和商业账本的角度仔细琢磨,你会发现这件事背后隐藏着一个正在发生但极少被公开挑明的残酷现实:我们在屏幕上看到的那些长篇大论的思维链,可能根本不是 AI 思考的本质;为了追求极致的计算效率,大模型正在试图甩掉人类的语言。
从层层堆叠到隐空间心算:循环深度究竟改变了什么
要理解这场争论,得先看看传统的 Transformer 是怎么工作的。自 2017 年那篇《Attention Is All You Need》奠定现代大模型基石以来,行业推高模型智力的方式基本遵循着一套物理上的线性逻辑:输入一段文字,将其变成高维向量,然后穿过一层又一层的 Transformer 神经网络,从第 1 层逐级向前传递到第 N 层,最后吐出下一个词。在过去的预训练时代,如果想让模型具备更强的表达能力,最直接的做法就是堆参数、堆层数,把模型从几十亿参数堆到几千亿甚至上万亿。
但物理规律和芯片制造的极限很快摆在面前。层数越多,参数量越庞大,对 GPU 显存(HBM)的消耗就呈线性甚至超线性暴增,单台服务器根本装不下,必须依赖极其昂贵的高速网络互联把数以万计的芯片绑在一起。后来,以 o1 和 DeepSeek-R1 为代表的推理模型开辟了另一条路径,也就是在推理阶段给模型充足的“时间”,让它在输出最终答案前,先自发生成几千甚至上万个文本 Token 的长思维链。这在学术上被称为“推理期扩展(Test-time Compute Scaling)”,相当于通过延长输出的步骤,在时间维度上换取更高的准确率。
而 Astra 被爆出的“循环深度”,其核心思路其实更接近学术界早就研究过的“循环 Transformer(Looped Transformer)”。它打破了“数据只能单向穿过固定物理层”的束缚,让中间生成的隐状态在同一批网络层内部循环迭代多次。打个比方,传统的做法是组织一条拥有 100 个工人的超长流水线,每个人只看一眼零件就往下传;而循环深度则是挑出几个能力极强的核心小组,让同一个零件在这个小组手里反复琢磨加工五轮、十轮。这样一来,模型的实际物理参数规模并没有无休止膨胀,但其等效的计算图深度却被成倍拉长。更关键的是,这种“琢磨”直接发生在连续的高维数学向量里,不需要每推演一步就把结果硬编码成人类的词汇打在屏幕上。
自然语言不是思考的翅膀,而是机器的算力裹脚布
很多人直觉上认为,语言是思维的最高形态,大模型学会了用自然语言推导,就说明它掌握了人类的智慧。但如果从计算机底层的能耗与通信开销来看,用自然语言做深度思考,对机器来说其实是一场极其笨拙、昂贵且低效的妥协。
在我们实际研发 AI 应用的过程中,算力账本是极其现实的。大模型吐字采用的是自回归(Autoregressive)机制,这意味着它在屏幕上每吐出一个汉字或一个英文单词,整个包含数千亿参数的网络权重就要在显存与计算核心之间完整搬运并计算一次。一个极其复杂的数学证明或架构设计,如果让模型用文本写出 8000 字的详细思维链,就意味着它要老老实实做 8000 次完整的全网络前向传播。这不仅带来了肉眼可见的卡顿和等待延迟,更为服务器厂商带来了极其恐怖的电力消耗和显存带宽占用。
更本质的问题在于带宽的错配。人类之所以依赖语言思考,是因为生物进化的限制——我们的大脑受限于喉咙、声带和纸笔的物理介质,必须把大脑皮层高维连续的神经电信号压缩成线性、离散的词汇符号,才能完成自我整理或与他人通信。但人工神经网络天生就生活在由成千上万维连续浮点数构成的潜在空间里,它原本可以直接在高维向量之间做极其平滑的矩阵变换与模式折叠。过去我们强行要求它在每一步推理时,都必须把潜意识里的连续向量强行截断,四舍五入投影成字典里的某一个具体汉字,然后再把这个汉字重新编织成向量喂回给下一轮计算,这就像是逼着一个心算速度极快的数学天才,每做一步加法都必须在黑板上用正楷把步骤完整写出来一样。
显式思维链从来不是机器智能的终极形态,它只是在算法尚不成熟时,人类为了便于评估和对齐,强加给模型的一道昂贵的“思考表演”。当模型的能力跨过临界点,工程效率的法则必然驱使它甩开文字的拖累,直接在隐空间里进行极速心算。
商业落地的死命令:智能体经不起慢吞吞的表演
这项架构探索之所以在近期被推向风口浪尖,并非源于单纯的学术好奇,而是被眼下极其严峻的商业化落地压力所倒逼的。
这两年整个产业界都在高喊智能体(Agent)和“计算机操作(Computer-Use)”,希望 AI 能像真人助手一样自主操作软件、编写工程代码、排查系统故障。但只要是在真实生产环境中尝试过落地 Agent 的人,都会深刻体会到当下的技术体验有多么脱节。如果让一个基于长文本思维链的模型去操作电脑,它看一眼屏幕截图,就要在后台慢吞吞地写上几百字分析:“我看到左上角有一个按钮,它的坐标大约在某处,我准备点击它”;点击完之后,页面跳出一个弹窗,它又要停顿数秒,重新写一段长篇大论来确认下一步。
在操作系统的高频交互中,这种延迟是灾难性的。一个真正可用的 Agent,面对复杂多变的界面交互,需要的是每秒数次的即时决策与快速试错能力,它需要的是人类那种近乎本能的“下意识反应”,而不是每次动鼠标前都要写一篇议论文。按照现有的长文本推理模式,运行一个复杂任务动辄消耗数十万 Token,调用成本往往高达数美元,而且动辄耗时数分钟,在商业账本上根本无法形成正向反馈。
循环深度架构的出现,正是针对这一死穴的突围。它让模型能在极小的物理体积下常驻在单张芯片的显存中,跳过中间漫长的文本生成阶段,在隐空间内部完成毫秒级的多轮状态演化与动作规划。只有把每次决策的开销从“几百个 Token 的文本搬运”压缩成“几次内部向量矩阵的连续迭代”,自动化的软件操作才可能真正从极客尝鲜的玩具,变成经济上划算的企业级生产力工具。
当草稿纸被收走之后:安全防线的断崖与高管的自卫
然而,技术的极致效率一旦撞上社会的信任机制,就会立刻激化出巨大的矛盾。这正是为什么 Astra 架构一经披露,就在业内引发轩然大波的根本原因。
过去这一年多里,尽管 OpenAI 和各大闭源巨头在商业上把详细思考过程进行了不同程度的折叠,但整个人工智能安全界之所以还保持着底线层面的信心,完全建立在一个脆弱的假设之上:那张草稿纸即使不对普通用户开放,它在系统底层依然是一串人类能读懂的自然语言文本。 安全团队可以用现成的文本分类器、意图探针去逐字扫描模型的思考过程,一旦发现模型在草稿纸上策划欺骗人类、绕过安全规则、或者寻找越狱漏洞,系统就能在最终答案输出前瞬间拉下电闸。这种“思维链监控(CoT Monitoring)”是目前全行业最有效、也是几乎唯一的对齐抓手。
可一旦模型采用了深度的隐空间循环,推理过程全部转入了连续高维的隐藏向量之中——也就是业内常说的“神经语(Neuralese)”——这道安全防线就面临着断崖式的崩溃。人类目前在数学上根本没有工具可以逆向翻译那些在千维空间里高速流转的数值向量到底代表着什么意图。模型在深度的数学回环里完成了什么假设、推演了什么捷径、是否存在欺骗性的中间状态,外部审计人员将完全处于盲区之中。
看懂了这一层,你就能完全理解为什么 OpenAI 首席科学家帕乔基要急忙出来发文灭火。他强调“计算深度只有 GPT-4 的两倍以内”,强调“严格限制了该架构的应用范围”,这绝不是技术上的谦逊,而是一场关乎企业生存的合规自卫。在欧美监管机构(如美国 AI 安全研究所)对模型自主性和不可控性盯得极其紧迫的当下,一旦被贴上“正在研发完全不可解释、不可监控的深层黑盒”的标签,OpenAI 面临的可能不仅是舆论的讨伐,更是商业化产品被监管部门无限期搁置的灭顶之灾。性能想要往隐空间走,而合规硬要把模型往文字拉,这是所有大模型前沿实验室今天都在面临的囚徒困境。
人类语言的降级,与人机共存的新现实
回顾人类文明的历史,我们向来习惯于将“语言”视作灵长类独享的智慧桂冠。古希腊哲学家把人定义为“拥有理性的动物”,而理性的载体就是逻各斯(Logos,即言语);现代哲学家维特根斯坦也曾留下那句名言:“我语言的边界,意味着我世界的边界。”在过去两年的认知惯性里,我们几乎理所当然地认为,只要教会机器精通人类的语言,它就能一步步成为人类意志的完美镜像。
但技术的进化并不受人类浪漫情怀的束缚。大模型因学习人类数千年积累的语言文字而觉醒,但在向更高的算力利用率、更低的商业成本和更强的通用智能狂奔时,它却展现出了抛弃人类语言的势头。在纯粹的数学世界里,人类的语言既稀疏又沉重,它不是思考本身的母体,只是低维世界向高维世界窥探时留下的一道狭窄投影。
短期之内,由于商业信任和安全监管的巨大阻力,我们依然会在各种产品的对话框里看到详尽的“思考过程”,厂商们会像帕乔基承诺的那样,强行在架构外侧加上一道“翻译器”,逼着模型把隐空间的结论重新还原成工整的人话。但那种微观动作在隐空间极速心算、宏观结果用文字汇报的双层架构,显然已经不可逆转地被推上了历史舞台。
面对正在把思考收回隐秘数学空间的 AI,我们或许需要重新审视自身的位置。未来最值得警惕的,或许不是机器说出了什么出格的话,而是当它在沉默中完成了一套人类无法溯源、却在现实中绝对最优的决策推演时,坐在操作台前的人类,是否还能保持理性的从容,又该以怎样的机制去守护最后的掌控权。