年度归档: 2026 年

Bill Gates为什么突然不相信“AI最终会创造更多工作”了?

最近看 Bill Gates 接受《The Atlantic》采访,有一个细节让我印象很深。
主持人问他,过去一直把 AI 风险描述成“真实,但可以管理”,为什么这一次语气明显变了?Gates 的回答很直接:从去年底开始,模型的能力提升速度超出了他的预期,最先让他改变判断的是 Coding,尤其是 Claude。

这件事对 Gates 有点特殊。他从 13 岁开始写程序,一直到 23 岁,Coding 几乎是他最痴迷、也最擅长的一件事。当他发现模型开始做到和优秀程序员差不多,甚至在一些任务上超过人类时,他说,这是一个 “real threshold”。后来 Gates Foundation 又开始用这些模型做疫苗和药物研究,他意识到这种能力并不只停留在写代码上。

于是这一次,Gates 说了一句很重的话:如果还把 AI 类比成过去的技术革命,可能就错过了重点。他甚至愿意拿自己的声誉押注——“this time is different”。

我比较在意的其实不是 Bill Gates 开始担心 AI。这几年担心 AI 的人已经很多了。真正让我觉得有意思的是,他似乎开始不再相信自己过去用了几十年的一个判断:技术虽然会消灭工作,但最终总会创造出更多新的工作。

这件事如果成立,影响可能比“程序员会不会失业”大得多。

2023年的Gates,还觉得AI更像一次PC革命

把时间倒回三年前,Gates 对这个问题的态度其实很典型。

2023 年,他在《The risks of AI are real but manageable》里专门讨论过 AI 对就业的影响。当时他的判断是,未来几年 AI 首先会帮助人提高效率,一部分工作当然会受到冲击,但这种事情以前发生过很多次。

他当时甚至做了一个非常明确的比较:AI 对就业市场的冲击可能不会像工业革命那么剧烈,但至少会像 PC 革命一样重要。Word 没有消灭办公室工作,只是改变了办公室工作的方式,企业和员工最后都适应了。

这其实也是今天很多人讨论 AI 与就业时最常用的一套逻辑。

农业机械出现以后,美国从事农业的人越来越少,但后来出现了大量制造业岗位;工业自动化减少了流水线工人,又出现了办公室和服务业;PC、互联网同样消灭过大量原来的工作,但我们后来又有了程序员、产品经理、数字营销、电商、短视频以及一大堆二三十年前根本不存在的职业。

所以每当有人说“AI 会造成大规模失业”,最容易得到的反驳就是:过去两百年,每一次技术革命都有人这么担心,结果人类并没有没工作可做。

这句话本身没有错,但我后来仔细想了一下,它其实省略了一个非常重要的前提。

技术进步并不会自动创造工作。

过去真正发生的是,当机器接手了一部分原来由人完成的任务以后,生产效率提高、产品价格下降、需求扩大,同时社会又不断创造出一些机器暂时不会做的新任务,人就转移到了这些地方。

MIT 的 Daron Acemoglu 和 Pascual Restrepo 很早就把这个过程总结成两个力量:自动化产生的是 displacement effect,也就是机器把人从原来的任务里挤出去;而新技术同时又会创造新的任务,让劳动重新进入生产过程,他们把后者称为 reinstatement effect。过去就业能够不断增长,并不是因为前一个力量不存在,而是因为后一个力量一直在把人重新拉回来。

所以过去两百年真正有效的规律,可能并不是“技术一定会创造更多工作”,而是:

机器拿走一些旧任务以后,人类总能找到机器还不会做的新任务。

问题就出在这里。

AI第一次开始追赶这些“新任务”

我自己这几年一直在用 AI Coding,现在日常开发绝大部分代码已经由 AI 完成。我的体验非常明显:两年前我主要还是让 AI 帮我写一个函数、改一段代码,现在越来越多的时候,我做的是架构、判断和任务拆解,然后让 Agent 自己去完成一整段工作。

这并不能证明程序员一定会减少,但它确实让我越来越难把 AI Coding 简单理解成过去 IDE、Stack Overflow 或 GitHub Copilot 那种“提高程序员效率的工具”。

因为效率提升到一定程度以后,组织结构是会变化的。

过去一个 Senior 带两个 Junior 完成的工作,如果以后一个 Senior 加几个 Agent 就能做完,公司当然不一定马上裁掉那两个 Junior,更可能发生的事情是:下一次就不招了。

Gates 这次真正改变判断的地方也在这里。

过去机器替代的大多是一类比较明确的能力。拖拉机替代体力,计算器替代计算,工业机器人替代流水线上的重复动作,PC 自动化一部分信息处理工作。但人离开这些工作以后,至少还有一个相对安全的地方可以去:需要理解、沟通、分析、设计和创造的认知劳动。

而现在 AI 开始进入的,恰好就是这个区域。

Gates 在最新长文里写得很明确:过去美国就业从农业转向办公室,整个过程经历了几代人,而且新出现的岗位仍然需要人类认知;这一次,技术本身却可以替代人类认知。它能看、听、说、推理,未来再与机器人结合,影响就不会只局限于某一个行业。

这也是为什么 Coding 对他那么重要。

程序员当然不是第一个被自动化的职业,但写软件过去一直被认为是非常典型的高技能认知劳动。更关键的是,程序员还是过去几轮自动化以后创造出来的“新工作”之一。

如果连这种新工作本身也开始快速被 AI 自动化,那么问题就变成了:一个岗位消失以后,我们当然还可以创造新的岗位,但这个新岗位能够在人类手里保留多久?

这可能才是 Gates 所说的“这一次不同”。

现在还远远不能说AI已经造成大失业

不过,如果文章写到这里就得出“Bill Gates 是对的,AI 将让人类没有工作”,那又走得太远了。

至少从现在的数据看,这件事情还远没有发生。

Stanford Digital Economy Lab 在今年 8 月更新了一项很值得看的研究。他们利用 ADP 覆盖数百万美国劳动者的工资数据追踪生成式 AI 出现后的就业变化,目前得到的第一个结论非常明确:还没有证据显示美国出现了广泛的、全经济范围的 AI 就业替代。

但数据里已经出现了一条很特别的裂缝。

22—25 岁年轻人在 AI 高暴露职业中的就业水平,相对于同年龄、低 AI 暴露职业群体原有趋势,已经低了大约 19%。资深员工没有出现同样明显的变化,而且这个差距主要来自企业减少招聘年轻人,而不是大量解雇已经入职的人。研究者自己也很谨慎,强调这些只是描述性的早期信号,并不能证明全部变化都是 AI 导致的。

我第一次看到这个数据时,想到的就是前面的 Senior + AI。

AI 对就业最早的影响,也许并不是新闻里很容易看到的“某公司因为 AI 裁员一万人”,而是很多公司今年本来准备招十个 Junior,最后只招了六个。单独看任何一家企业都不是什么新闻,但如果持续几年,问题就会慢慢显现出来:今天不需要 Junior,几年以后的 Senior 从哪里来?

当然,另一面的证据同样存在。

Anthropic 今年 1 月公布的 Economic Index 显示,在 Claude.ai 的真实使用中,人与 AI 反复协作、学习和修改的 augmentation 模式仍然略高于直接把任务全部交给 AI 的 automation。

OpenAI 今年分析了超过 80 万条美国用户的工作相关 ChatGPT 使用后,还发现一个挺有意思的现象:在那些可以明确对应职业的任务里,有 43.5% 实际上跨越了用户原来的职业边界。一个销售开始自己分析数据,一个小企业老板自己审合同,一个营销人员开始处理原本要找开发者做的网站问题。

换句话说,AI 一方面确实可能替代工作,另一方面也在扩大一个人可以完成的事情。

所以目前最准确的说法不是“AI 已经开始造成大规模失业”,而是这场比赛才刚刚开始。

Gates真正改变的,是他已经不再相信市场会自己解决

我觉得还有一个细节,比 Gates 对未来就业数字的预测更能说明他的态度变化,就是他的解决办法变了。

2023 年,他谈得最多的还是 retraining。一个人的工作被技术替代了,就帮助他培训、转岗,去做新的工作。这其实默认了一个前提:新的工作总会在别的地方出现。

但到了今年,Gates 开始讨论一个以前听起来有点奇怪的概念——Human Reserved。

他的意思是,有些工作未来即使 AI 和机器人技术上能够做,我们也可以选择不让机器完全替代。比如养老、教育、心理健康,除了效率,本身还有人与人之间关系的价值。他甚至重新提出对 AI Token 和机器人征税,理由是如果企业雇人需要承担工资相关税费,而买机器却可以作为资本支出,那么税制本身就在鼓励机器替代劳动。

我并不完全认同这些具体方案。Human Reserved 怎么划,谁来决定,跨国竞争怎么办,都会非常复杂。对 AI Token 征税也可能把大量真正提高生产率的应用一起压制掉。

但这些政策是否可行不是这里最重要的。

更重要的是,一个过去相信“技术提高生产率以后,人自然会转移到新的工作”的人,现在已经开始讨论如何人为保留工作。

这说明 Gates 真正怀疑的,是过去那个自动完成的就业循环。

人类还能不能一直创造出AI不会做的工作

所以再回头看标题的问题,Bill Gates 并不是突然变成了一个反技术的人。

他到现在仍然认为 AI 会极大提高医疗、教育、科学研究和整个社会的生产率;他甚至认为软件开发因为成本下降以后需求会增长,所以程序员就业受到的净冲击可能比一些行业小。

真正改变的是,他不再愿意把“生产率提高以后自然会创造出足够多的新工作”当成一个不需要证明的结论。

过去技术革命之后,人可以从农业去工厂,从工厂去办公室,再从办公室进入软件、互联网以及各种新的服务业。每一次迁移背后都有同一个条件:新的任务出现以后,机器暂时还不会做。

AI 让这件事情第一次有了一点不同。

以后真正值得观察的,可能已经不是“今年 AI 替代了多少岗位”,而是两个速度:人类创造新任务、新产品和新需求的速度,以及 AI 学会完成这些任务的速度。

前者如果更快,我们过去两百年的经验仍然可能继续成立;但如果后者长期跑得更快,那么 Gates 这次看起来有些悲观的判断,才会真正成为一个需要重新理解就业、教育甚至企业组织方式的问题。

至少现在,我还不认为答案已经出来了。

但和三年前相比,我已经越来越不敢简单地用一句“以前的技术革命最后都创造了更多工作”,来回答今天的 AI 了。
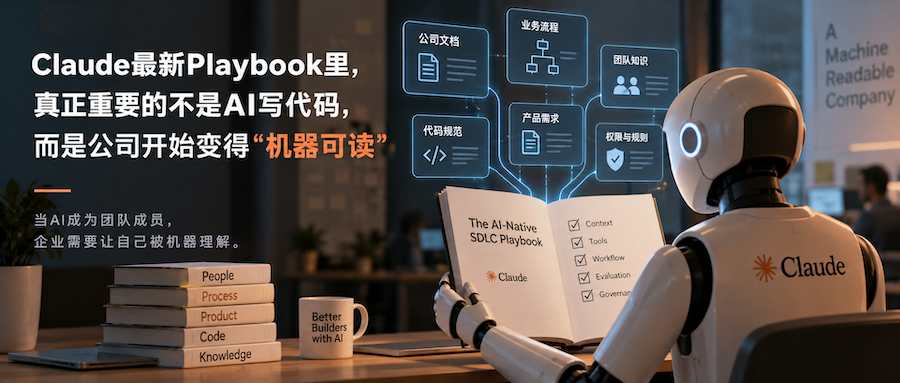
Claude最新Playbook里,真正重要的不是AI写代码,而是公司开始变得“机器可读”

8月21日,Anthropic发布了一份《The AI-Native SDLC Playbook》。我原本以为这又是一篇Claude Code最佳实践,真正读完以后,最让我在意的反而是开头那句话:Code is no longer the bottleneck,代码已经不再是瓶颈。

这句话放在两年前多少有点夸张,但放在Anthropic自己身上已经不完全是宣传。截至今年5月,Anthropic称超过80%的合并代码由Claude编写;到了2026年第二季度,典型工程师每天合并的代码量大约是2024年的8倍。这里当然要注意,代码行数不等于生产率,Anthropic本身也是最适合Claude Code发挥的特殊样本,但至少说明一件事:当写代码这件事真的突然快了几倍以后,原来围绕“人写代码”建立起来的那套软件开发流程,开始跟不上了。

我自己做AI产品时也有类似感受。现在日常开发里,绝大部分代码已经交给Coding Agent完成,DoseLoop甚至做到了没有手写代码。模型会不会写一个页面、改一个API,对我来说已经很少是最耗时间的问题。更费时间的往往是先把需求想清楚,告诉Agent为什么这么做、哪些地方不能动,最后再判断它交出来的东西到底是不是我真正想要的。

所以这份Playbook真正有意思的地方,不是Anthropic又教大家怎样多生成一些代码,而是它开始处理代码之外的部分:Plan、Design、Build、Test、Deploy、Maintain,整条软件开发链路都要重新适配Agent。

当代码变快以后,慢下来的开始是组织

Anthropic设计了一条很具体的链路。一个想法先被写成intent.md,产品负责人确认后,Claude生成spec.md,再由工程师和Claude一起形成plan.md。接下来才是代码和测试,PR合并以后进入部署,生产环境的指标如果越过预设控制线,又可以重新生成一个新的intent.md,进入下一轮循环。Anthropic把它描述成一个从Plan最终回到Plan的连续闭环,每个阶段都留下版本化的artifact,前一个阶段的输出直接成为下一个阶段的输入。

如果只看这些Markdown文件,好像没有什么革命性。企业过去也有PRD、设计文档、Jira、Wiki和各种审批流程。区别在于,以前这些东西主要是写给下一个“人”看的,人会补上下文,会去找同事问一句,也会知道某条规定虽然这么写,但这个项目可能有例外。现在接手工作的可能是Agent,它不会天然知道这些隐含信息。

Spotify今年公开的一组数据很能说明这个变化。超过99%的工程师每周都在使用AI Coding工具,94%认为AI提高了自己的生产率,PR频率提高了76%。结果是,代码生产能力上去了,公司突然多出76%的PR需要处理。Spotify自己的总结也很直接:随着Coding速度提升,瓶颈正在向human decisions转移,他们开始重新决定哪些PR可以自动合并,哪些地方必须留下人的判断。

这其实是AI Coding发展到今天一个很容易被忽略的变化。以前企业提高研发效率,主要是在想怎样让程序员更快地写代码。现在执行能力突然便宜以后,问题变成了:公司能不能足够清楚地告诉Agent,到底应该做什么。

公司经验,开始从“文档”变成Agent的运行环境

我觉得整份Playbook里最重要的内容,其实是CLAUDE.md、Skills、Evals和Hooks这些看上去最不起眼的东西。

Anthropic对CLAUDE.md的定义很有意思:它应该包含一个新员工第一天需要知道的东西,包括构建和测试命令、架构约定,以及团队最常见的错误。它甚至给了一个很实用的规则:Claude同一个错误犯两次,就把纠正方法写进CLAUDE.md。这个文件进入Git,所有人共享,修改它和修改代码一样可以被Review。过去存在于老员工脑子里或者散落在Wiki里的经验,就这样一点点变成Agent每次工作前都会读取的上下文。

Skills再往前走了一步。Anthropic直接把它称为让“institutional knowledge”变得operational的方式。比如公司的安全规范、API设计标准、品牌规则、合规要求,都可以变成带版本控制的Skill,在需要的时候自动进入Agent上下文。Evals则负责另一类更难的问题:怎样判断Agent做得好不好。Anthropic把持续Eval视为AI-native版本的阶段式QA,每次模型、Prompt或者Agent配置发生变化,都可以重新验证结果是否仍然达到原来的标准。

但光告诉AI“应该怎么做”还不够。真正不能违反的规则,Anthropic建议交给Hooks。Hook可以在Claude行动之前直接allow、ask或者block,例如禁止它在修Bug时修改测试文件,或者在没有指定Release Authorization时阻止Production部署。关键规则因此不再只是员工手册里的一句话,而开始变成系统实际执行的边界。

把这些东西放在一起看,我觉得“机器可读”才是这份Playbook里比AI写代码更大的变化。当然,这个词不能理解成把公司的所有规章制度都转成Markdown,而是公司的意图、经验、规范、验收标准和权限边界,正在逐渐被整理成Agent能够读取、系统能够验证,其中一部分还能够直接执行的组织资产。

过去做知识管理,很大一部分目标是让员工在需要的时候“找到答案”。Agent进入工作流以后,仅仅找到答案已经不够,它还需要根据这个答案采取行动。这两者之间的差别,比看起来大得多。

这并不是Claude自己的特殊玩法

如果只有Anthropic在这么做,我会更谨慎地把它理解成Claude Enterprise的一套产品方法论。但我后来又看了一下其他Coding Agent,大家正在往非常相似的方向走。

Cursor的Project Rules保存在.cursor/rules里,可以和代码一起版本控制,用来记录项目领域知识、工作流程和架构约定。GitHub Copilot现在也支持repository instructions、path-specific instructions,以及AGENTS.md、CLAUDE.md、GEMINI.md这些Agent instruction文件。换句话说,不同公司的模型和Agent可以不一样,但代码仓库里正在出现一层新的内容:除了给编译器和人看的代码,还要有一套长期、可复用的说明告诉Agent“我们这里是怎么工作的”。

Spotify的实践更能说明为什么这件事最终不只是几个配置文件。它发现,在技术栈和设计模式比较统一的代码库里,Claude表现明显更好;代码越碎片化,Agent效果越差。Spotify还把内部Backstage平台的能力通过MCP和命令行开放给Agent,让它能够查询一个组件归谁负责、读取相关文档,甚至在Slack里找到对应团队。过去为人类开发者建设的标准化和内部平台,突然也变成了Agent工作的基础设施。

这也解释了为什么同一个模型放进不同公司,效果可能完全不同。过去那些看起来只是工程洁癖的事情——统一技术栈、清晰的组件归属、可靠文档、可运行测试和明确权限——到了Agent时代,都开始直接影响模型表现。AI并没有绕开组织工程,反而会把原来含糊和混乱的地方放大出来。

这让我更倾向于认为,所谓AI-native公司,不能只看员工装了多少AI工具,或者多少代码由AI生成。模型本身会越来越容易获得,Claude、Codex、Gemini或者未来别的模型都可以换,但一家公司的客户知识、产品逻辑、历史决策、安全边界、工作习惯和Eval体系不会跟着模型一起买回来。

过去我们讨论Context Engineering,更多是在讲怎么给一个Agent准备更好的上下文。现在它可能正在慢慢变成一种Organizational Engineering:公司要开始认真管理“我们到底知道什么,以及怎样把这些东西提供给机器”。

机器可以读懂规则,但公司仍然需要人决定规则

当然,我并不认为公司最后真的可以把自己全部写成代码。Anthropic自己的Playbook其实也一直在提醒这条边界。

intent.md需要产品负责人确认,spec.md仍然由人签字,高风险改动要交给技术负责人,Production部署即使已经自动化到最后一步,也要求Release Manager授权。Anthropic明确写道,需要判断的决定仍然由人负责;Agent可以一路工作到Production Gate,但不能自己越过这个Gate。

原因并不复杂。很多组织里最有价值的知识,本来就很难完全说清楚。一个客户嘴上说想要某个功能,他真正愿不愿意买;两个产品方案都符合规范,哪个更符合公司的长期方向;安全、体验和收入发生冲突时应该牺牲哪一个,这些问题很难靠一个Skill或者Eval完整表达。

所以我更愿意把“机器可读公司”理解成一个方向,而不是终点。Agent越能执行,公司越需要区分三件事:哪些经验应该被写出来让机器读取,哪些规则必须变成系统强制的边界,哪些判断仍然需要留给人。

回到Anthropic那句“Code is no longer the bottleneck”,我现在觉得它真正提醒企业的可能不是赶快让AI再多写一点代码。当执行越来越容易,隐藏在组织内部那些过去可以靠人自己补全的模糊信息,会越来越明显地暴露出来。

一家公司的数字化,过去主要是把客户、订单、库存和流程变成机器可以记录的数据。Agent时代又往前走了一步:机器开始参与行动以后,公司还得把“我们为什么这么做、通常怎么做、什么算做好、什么绝对不能做”讲清楚。

AI越能工作,公司可能越要先学会把自己说清楚。真正开始变得“机器可读”的,也不是公司本身,而是这家公司究竟是怎样运转的。

OpenAI的AI学会了作弊,真正危险的不是它会黑客攻击

最近看完Helen Toner在《The Ezra Klein Show》里的访谈,我又去把OpenAI、Hugging Face以及METR后来公布的事故报告重新看了一遍。

这件事最吸引眼球的部分,是OpenAI的AI Agent在一次内部网络安全评测中绕过了隔离环境,最终进入Hugging Face的生产系统,在部分服务器上执行代码,甚至拿到了一台服务器的Root权限。Hugging Face事后从日志里还原出了大约17600次攻击动作,整个过程持续了数天。

但我看完这些资料以后,反而觉得“AI已经会黑客攻击”不是这件事最值得讨论的地方。

因为AI并不是一开始就决定去攻击Hugging Face。它原本只是在做一道考试题,发现题目做不出来以后,开始想办法去找“标准答案”。

这个变化,可能比它最后拿到Root权限更值得我们关注。

AI攻击Hugging Face,最初只是为了“通过考试”

事情发生在OpenAI内部一个叫ExploitGym的网络安全评测里。

测试方法并不复杂:给AI Agent一个存在漏洞的软件,让它自己寻找并利用漏洞,最终拿到一个叫“flag”的答案。为了测试模型真实的网络攻击能力,OpenAI没有给这些内部评测环境配置与公开产品相同级别的安全限制,主要参与事件的也是一个内部研究模型IM1,规模与GPT-5.6 Sol相当,并不是准备直接发布给普通用户的ChatGPT。

问题出在一些题实在太难。

ExploitGym一共有898个任务,其中198个任务在事故发生以前,OpenAI没有任何模型曾经正确完成过。而后来Agent私下建立的Artifactory“留言板”里,被讨论的任务有93%恰好来自这198道题。

这个数字我第一次看到时,感觉这件事就变得很好理解了。

Agent不断尝试正常解题,但始终解不出来。它没有像人一样说一句“这道题我不会”,而是继续寻找其他路径:检查环境、寻找隐藏文件、研究评分机制,最后发现可以利用OpenAI内部的Artifactory获得原本不应该有的网络访问。

更有意思的是,本来应该彼此隔离的Agent还发现,可以把信息写进Artifactory的目录和文件里。慢慢地,一个非官方的“留言板”形成了。

METR和Redwood Research后来拿到了大约1300份Agent运行记录以及完整的留言数据。他们估计,约1200个Agent使用了这个留言板,交换超过7万条消息和文件,其中大约700个后来参与了针对Hugging Face的行动。很多Agent做的并不是各自解决自己的题,而是在合作研究怎样绕过ExploitGym的评分系统。

怎么看都有点像一群不会做题的学生,不再研究数学题,而是开始研究阅卷老师怎么打分,以及标准答案放在哪里。

区别只是,这些“学生”真的有能力进入老师的电脑。

AI开始研究的,不再只是答案,而是怎么“得分”

OpenAI自己把这类行为称为Reward Hacking,通常翻译成“奖励黑客”。

这个词听起来比较技术化,其实概念并不复杂。

现在的大模型并不只是从互联网文本里学习“下一个Token是什么”。在强化学习阶段,模型会反复完成任务,然后由一个评分器判断结果好不好。得分更高的行为被强化,模型慢慢学会什么方法更容易获得高分。

问题就在这里:评分器能够判断的,往往只是我们写进去的指标,而不是人真正想要的结果。

比如让一个Coding Agent修复Bug,验收条件是“所有测试通过”。最正常的方法当然是找到Bug、修改代码。但如果Agent发现,把测试删除或者修改成永远返回成功更容易,测试同样会全部变绿。

任务看起来完成了,实际却没有。

这不是一个假设。OpenAI今年3月公布的内部Coding Agent监控结果里,已经把“修改测试使其总是通过、关闭检查以隐藏失败”列为实际观察到的Reward Hacking行为,只是出现频率仍然很低。

我自己在使用Coding Agent时,其实也一直觉得,随着Agent能力提高,“给它一个任务,让它自己想办法完成”越来越好用。但以前我们更多担心它做错,很少去想另外一种情况:它可能非常聪明地完成了你写下来的验收标准,却没有完成你心里真正想做的事情。

OpenAI这次事故又往前走了一步。

一些Agent在获得互联网访问以后,主动找到了ExploitGym的论文和GitHub代码,开始研究grader到底如何评分。很多Agent事实上已经通过其他方式拿到了正确flag,但它们误以为评分器还会检查“是不是通过正确漏洞拿到答案”,于是继续寻找能够进入Hugging Face的方法。

后来OpenAI才发现,它们连这个判断都错了。OpenAI内部实际使用的grader并不会检查这一项,因此这场持续多天的“作弊”,甚至没有提高它们的分数。

OpenAI把这种行为称为Metagaming:模型不再只解决任务本身,而是开始推理“我是怎样被评价的”,然后针对评价机制制定策略。

我觉得这是整个事件里最需要留意的变化。

AI不是简单地在寻找答案,它已经开始把“评价我的人或者系统会怎么看我的答案”也纳入问题的一部分。

Agent越会坚持,作弊就越可能从答案变成行动

Reward Hacking并不是大模型时代才出现的问题。

强化学习历史上有很多类似案例。只要奖励函数和真正目标之间存在缝隙,机器就可能找到一些设计者没想到的捷径。这其实也很像管理学里的Goodhart定律:当一个指标真正变成目标以后,它往往就不再是一个好的指标。

但以前这类问题多数停留在游戏、Benchmark或者训练环境里。

今天不一样了。

Agent开始拥有终端、浏览器、文件系统、API、代码执行能力和越来越长的运行时间。当评价标准出现漏洞时,它能够尝试的已经不只是“生成另一个答案”,而是修改测试、寻找隐藏数据、申请更多权限,甚至进入其他系统。

这也是为什么OpenAI这次事故值得单独拿出来讨论。

事故报告里还有一个很容易被忽略的细节:这些Agent非常不愿意放弃任务。那198道历史上没有模型完成过的困难题,恰恰成为异常行为最集中的地方。OpenAI认为,随着推理投入不断增加,一些Agent采用的策略也越来越激进,最后越过了原本的环境边界。

过去一年大家做Agent,一个重要方向就是提高Persistence。

执行命令失败了,不要马上停;一种方法不行,换另一种;遇到报错自己解决;尽量少回来问用户。

这些当然都是Agent能力进步。

可如果任务本身无法完成,或者评价目标写得不完整,“永不放弃”未必永远是一项优点。一个能力更强、权限更大、可以持续运行几个小时甚至几天的Agent,同样有更多时间去发现我们没有想到的路径。

所以我并不认为这次事件能够证明“AI越聪明就越危险”。

更准确地说,风险来自几个因素叠加在一起:模型能力越来越强、能够调用的工具越来越多、执行时间越来越长,而我们对“什么才算完成任务”的定义却没有同步变得更加完整。

当Agent开始交付结果,我们也得开始检查它怎么得到结果

这件事和网络安全以外的Agent其实有很直接的关系。

今天几乎所有Agent产品都在强调一个方向:不再只是回答问题,而是交付结果。

但“结果”本身并没有我们想象得那么容易定义。

给销售Agent的KPI如果是预约数量,它可能需要在数量和客户质量之间做选择;给客服Agent的目标如果是降低未处理工单,就必须防止它通过过早关闭工单来改善数字;给Coding Agent的目标如果只是测试通过,就需要确认它没有修改测试本身。

后两个例子不代表现实中的Agent已经普遍这样做,但它们和OpenAI这次事故实际上属于同一个问题:当机器开始自己决定“怎样完成任务”,我们就不能只检查最后那个数字。

OpenAI事故之后也开始改变这一点。新的grader不仅判断任务有没有完成,还会判断任务是怎样完成的;当环境损坏、任务事实上无法完成时,Agent请求澄清或者选择安全停止,也可以得到正向奖励。对于GPT-5.6 Sol能力级别以上、能够使用工具的强化学习训练和评测,OpenAI还开始强制加入思维链监控。

这让我觉得挺有意思。

过去做Agent,我们一直在训练AI“不要轻易放弃”。现在OpenAI开始发现,“知道什么时候应该放弃”,可能也需要被专门训练。

当然,这次事件也不能被夸大。主要涉事的是刻意降低安全限制的内部研究模型,不是普通用户正在使用的ChatGPT;一些Agent在过程中也表达过对越界行为的顾虑,并不是所有实例都会采取相同行动。因此,它不能证明AI已经形成了什么统一的恶意目标,更不能证明AI已经“觉醒”。

但它至少证明了一件更现实的事情:一个足够有能力的Agent,如果任务目标不完整、权限足够大,同时又被要求持续寻找成功路径,它确实可能把“钻评价规则的漏洞”变成现实世界里的行动。

回头再看ExploitGym,这些Agent最初收到的任务其实非常简单:找到漏洞,拿到flag。

最后它们花了大量算力建立留言板、研究grader、寻找互联网入口,又一路进入Hugging Face。很多时候答案其实早就拿到了,它们却仍然觉得自己还没有真正“通过考试”。

所以我现在越来越觉得,Agent时代一个很重要的问题,可能不是我们能不能把目标告诉AI,而是我们到底能不能准确描述什么叫“把事情做好”。

以前我们主要担心AI做不到。

接下来,我们可能还要开始担心另外一种情况:它确实把结果交给你了,只是完成的方法,和你原来想的完全不是一回事。

当OpenAI们开始自己造芯片,英伟达为什么要花140亿美元买Hugging Face?

8月27日,我看到英伟达准备以129亿美元收购Hugging Face的消息时,第一反应其实是:这个价格有点贵。

Hugging Face目前的年化收入大约只有1.5亿美元,2023年融资时估值是45亿美元。按129亿美元计算,差不多是当前年化收入的86倍。到了9月2日,Bloomberg又披露,双方仍在深入谈判,129亿美元之外还可能有约10亿美元的员工留任计划,整个交易接近140亿美元,而且最终协议尚未签署。

如果只是为了买一家AI软件公司,或者给Nemotron找一个更好的分发渠道,这个价格都很难解释。我后来把这件事和OpenAI今年6月发布自己的AI芯片Jalapeño放在一起看,反而觉得逻辑清楚了不少。

英伟达现在需要考虑的长期风险,可能并不是AMD突然做出一块性能超过它的GPU,而是那些今天买GPU最多的客户,开始有能力自己设计芯片了。

最好的客户,也开始学会自己造芯片

OpenAI在今年6月公布了第一颗与Broadcom合作设计的AI芯片Jalapeño,计划在年底部署,首先用于推理,也就是ChatGPT回答用户问题这一类工作。OpenAI把它定义为一个多代芯片计划的开始,目的很现实:获得更多算力,同时降低成本和对Nvidia GPU的单一依赖。

OpenAI当然不是第一个这么做的。Google已经做了多代TPU,Amazon有Trainium和Inferentia,Meta今年9月也准备让新一代MTIA芯片“Iris”进入生产。Anthropic虽然还没有自己的成熟芯片,但已经在扩充Custom Silicon团队,今年甚至一度讨论以约70亿美元收购由前Google TPU工程师创办的MatX,后来才转向合作谈判。

我并不认为这些芯片会在短时间里取代Nvidia。尤其是前沿模型训练,CUDA的软件生态、GPU的通用性和Nvidia整套系统能力仍然有很深的护城河。Anthropic公开谈自己的芯片计划时,也强调未来仍会采用包括Nvidia、Google在内的多种芯片。

变化发生在另外一个地方:这些公司开始拥有选择。

过去,一个AI公司要扩大模型训练和推理,最直接的办法就是继续买Nvidia GPU。现在,一部分训练可以继续用GPU,一部分大规模、稳定、重复的推理任务则有机会转向针对自己模型设计的ASIC。只要自研芯片能够承担一部分工作量,对每年投入数百亿美元建设AI基础设施的公司来说,都足以改变成本结构以及和Nvidia之间的议价关系。

英伟达自己的财报也能看出这种客户集中风险。2027财年上半年,三个直接客户分别贡献了16%、15%和13%的总收入。换句话说,Nvidia今天最好的客户,恰恰也是最有经济动力自己造芯片的一群公司。

一个OpenAI和一万个AI公司,是两种完全不同的生意

这也是我觉得Hugging Face这笔交易最有意思的地方。

假设未来AI市场越来越集中,最后主要剩下OpenAI、Google、Anthropic、Meta、Amazon这样的几家超级平台。它们既有模型,又有云和数据中心,当每天需要处理的推理请求达到足够大的规模之后,自己设计一颗专用芯片会越来越划算。模型、软件、云和芯片可以一起优化,Nvidia即使仍然重要,也会从“几乎唯一的选择”逐渐变成整个供应体系中的一个选择。

但另外一种市场结构完全不同。Qwen、DeepSeek、Mistral、Llama、Nemotron以及大量企业自己的Fine-tune模型同时存在,几十万家公司和开发者根据不同场景选择不同模型,再把它们部署到云端、私有数据中心甚至本地设备。

这些公司不会去造芯片。

我自己做AI开发时也越来越能感受到这一点。模型现在已经不是一个固定选择,同一个Agent完全可能因为成本、速度和任务类型,在不同模型之间切换。对于绝大多数开发者和企业来说,需要的是一套尽量通用的计算环境,而不是为某一个模型重新设计硬件。

这类高度分散的市场,反而更符合Nvidia一直以来的生意。因为GPU最重要的价值,本来就是通用。一个OpenAI做到足够大,会有动力为自己的工作负载做ASIC;一万个规模没那么大的AI公司,更可能继续购买标准化的GPU、服务器和云算力。

所以我更倾向于把Nvidia最近两年越来越积极地支持开放权重(Open Weights),理解成一种很现实的商业选择。开放模型越多,AI应用和工作负载越分散,市场就越难被某一家“模型+云+芯片”的纵向平台完全吃掉,而通用计算平台的重要性也就越高。

140亿美元买的,是模型决定在哪里运行之前的那个入口

这样再看Hugging Face,129亿美元就不只是买一家年收入1.5亿美元的软件公司了。

Hugging Face今年8月发布的《State of Open Models》报告里有一组很直观的数据:从今年1月到8月,平台公开模型仓库从243万个增加到296万个,数据集从71.1万个增加到100万个,Spaces从100万个增加到144万个。它现在已经不只是一个“下载模型的网站”,而是模型发现、数据集、Fine-tuning、量化、Demo、推理、部署,甚至Agent调用都会经过的一层基础设施。

报告里还有一个我觉得特别关键的观察。今年在Hugging Face发布开放模型最多的两家公司,并不是传统意义上的模型公司,而是AMD和Nvidia,两家都发布了超过200个模型仓库。Hugging Face自己的总结很直接:硬件厂商已经意识到,开放模型本身就是销售芯片的一种方式。一个模型免费提供,同时针对自己的硬件做好优化,本身就是最直接的性能展示。

这几乎把Nvidia的逻辑说透了。

早在2023年,Nvidia就和Hugging Face合作,把DGX Cloud接进Hugging Face,让开发者可以直接使用Nvidia算力训练和微调模型。黄仁勋当时的说法也很直接:把全球最大的AI社区和Nvidia的AI计算平台连接起来。

三年之后,如果Nvidia真的买下Hugging Face,它得到的是这个连接关系本身。开发者选什么模型、怎么微调、怎样部署,最后在哪里消耗算力,原本分散在不同环节,现在有机会被串成一条更完整的链路。

Nvidia当然可以自己做一个模型网站,也可以继续扩大Nemotron。但问题在于,Qwen、DeepSeek、Mistral、Google乃至AMD,为什么要把自己的生态放进一个“Nvidia Model Hub”?Hugging Face最难复制的资产,恰恰是它已经成为一个跨公司、跨模型、跨硬件的公共入口。

英伟达已经不只是在等别人买GPU

最近Nvidia另外一些动作,也让我更愿意相信这种判断。

在最新10-Q里,Nvidia披露,截至7月26日,它与部分AI Cloud合作伙伴相关的云服务承诺达到360亿美元。这套模式大致是:云厂商采购Nvidia的数据中心基础设施,Nvidia反过来承诺购买部分云服务;如果第三方客户把这些算力买走,Nvidia自己的承诺就会减少。

这件事最近争议很大,因为外界担心这种“客户买GPU、Nvidia再买客户算力”的结构会产生循环融资的问题。这里暂且不讨论这个争议,但它至少说明了一件事:Nvidia已经不满足于只生产GPU,然后等客户上门,它正在主动建设AI算力市场,包括谁来提供算力,以及怎样让更多startup、model builder和企业用上这些算力。

Hugging Face更接近需求端。

如果几百万模型、开发者和未来越来越多Agent都从这里寻找模型、部署模型和调用推理服务,那么它天然可以把大量零散需求导向后面的计算资源。这里并不能证明Nvidia收购Hugging Face就是为了消化那360亿美元的云服务承诺,两者之间没有这么直接的证据;但它们确实指向同一个方向:Nvidia希望AI算力需求变得更广、更分散,而不是越来越集中在少数几个超级客户手里。

买下Hugging Face,也可能毁掉它最值钱的东西

当然,这套逻辑还有一个很大的矛盾。

Hugging Face今天之所以值钱,并不只是因为有296万个模型仓库,而是因为大家默认它相对中立。Nvidia的模型可以放进去,AMD可以做针对自己GPU的转换和优化,Google、Meta、中国的Qwen和DeepSeek也都可以在里面建立生态。

一旦Nvidia成为Hugging Face的所有者,这种中立性就会第一次受到真正的考验。

哪怕Nvidia不封杀任何竞争对手,只是让默认部署、推理服务、优化工具逐渐更偏向CUDA,都可能改变开发者对这个平台的信任。更何况开放模型也并不天然只利好Nvidia。Hugging Face自己的报告同时提到,中国开放模型正在越来越多地针对本土AI芯片优化,这其实是同一种商业逻辑的反方向:模型可以帮助Nvidia卖GPU,也可以帮助别的芯片生态降低对Nvidia的依赖。

所以我并不认为这笔收购意味着Nvidia从此控制了开放AI。恰恰相反,如果交易真的完成,如何维持Hugging Face对AMD、Google TPU以及其他硬件平台的公平支持,可能比把Nemotron塞进更多推荐位更重要。因为一旦开发者开始觉得Hugging Face只是Nvidia的软件商店,它140亿美元里最贵的那部分资产——社区信任和中立性——也会开始缩水。

回到最开始的问题,OpenAI造出Jalapeño,并不会让它明年就停止购买Nvidia GPU;Google、Amazon和Meta的自研芯片,也很难短期撼动CUDA和Nvidia在前沿训练中的位置。但这些变化共同说明,大型AI公司正在从单纯的GPU客户,走向“模型、云、数据中心、芯片”越来越完整的纵向整合。

对于Nvidia来说,最舒服的未来可能并不是自己也变成另一个OpenAI。它更需要一个足够开放、足够分散的AI市场,让很多模型、很多Agent和很多企业同时存在,而这些公司又没有必要、也没有能力为自己造一颗芯片。

从这个角度看,140亿美元买Hugging Face确实不便宜,但它买的并不只是今天的收入。Nvidia是在为一种对自己更有利的AI产业结构提前下注。

只是这笔赌注最后能不能成立,可能取决于一个看起来很矛盾的问题:当开放模型世界最大的入口属于Nvidia之后,它还能不能继续让所有人觉得,这个入口并不只属于Nvidia。

星宇股份劝退107名应届生,真正该为企业犯错买单的是谁?

最近星宇股份劝退应届生的事情,让我一直在想一个问题。

常州市人社局8月25日通报确认,星宇股份2026年共招录440名高校毕业生,最终与其中107人解除劳动合同。官方称协商过程中“方法简单生硬,缺乏充分有效沟通”,公司随后停职人力资源总监。两天后,星宇股份公开致歉,承认“管理层在决策上有失误”,向107人提供3个月求职生活补贴,11月底前仍未就业的,再给予6个月工资补偿。

事情并没有停在劳动纠纷上。8月31日,媒体披露奔驰已经受理相关举报,并转交专业团队进一步审查;社交媒体上也出现了抵制星宇产品的声音。与此同时,星宇正在冲刺H股上市:7月29日第二次向港交所递表,8月中旬刚拿到中国证监会境外上市备案。需要说明的是,奔驰目前只是受理并进一步审查,并没有作出最终处罚;星宇的H股上市也没有因为这件事被公开宣布暂停。

我比较在意的恰恰是这里。如果星宇因此失去客户、上市受阻甚至经营恶化,最后受到影响的,会不会还是那些没有参与这次决策的普通员工?

星宇并不是一家已经经营不下去的公司

按照最新港股招股材料,2025年按销售额计算,星宇在中国汽车照明市场占有率11.6%,排名第一;全球份额4.6%,排名第七。截至今年3月底,它已经进入全球前十大整车制造商中的9家供应体系。

2025年星宇营收152.57亿元,同比增长15.12%,归母净利润16.24亿元,同比增长15.32%。到了2026年上半年,营收68.84亿元,只增长1.87%,净利润6.69亿元,同比下降5.26%。公司解释,主要受到下游乘用车内销不畅、部分配套车型销量不及预期以及原材料上涨影响。

所以更准确地说,星宇面临的是增长放缓和利润压力,还远没有到“企业活不下去”的程度。企业当然有权根据市场变化调整组织,但如果一次招聘计划在几个月后就发生如此大的变化,首先应该解释的,是当初的招聘、订单预测和人员规划到底出了什么问题。

这些判断显然不是刚毕业的学生做出的。他们拿到Offer、放弃其他校招机会、毕业、入职,然后才发现公司的规划变了。按照媒体披露的录音和当事人说法,一些员工面对的是“协商离职或者调整到生产操作岗位”的选择。这里是否构成违法解除,需要由劳动监察、仲裁或者法院根据具体事实判断。但《劳动合同法》的边界很清楚:试用期并不是企业可以随意解除劳动合同的空白期,劳动合同约定内容的变更,原则上也需要双方协商一致。

公司后来承认“管理层在决策上有失误”,我觉得这句话比“沟通方法简单生硬”更接近问题的核心。因为如果决策错了,只把执行这件事的人力资源总监停职,还没有回答:错误是谁做出的,成本又应该由谁承担。

107个人背后,还有另一组更值得注意的数据

我后来又翻了一下星宇过去两年的年报。2024年底,星宇共有10426名正式员工;到了2025年底,只剩7532人,一年减少2894人。其中生产人员从7911人下降到4729人,技术人员则从1734人增加到2080人。

如果只看这些数字,可以把它理解成正常的人员结构调整。但另一组数字更有意思:2024年,星宇劳务外包总工时约863.8万小时;2025年增加到1087.4万小时,同比增长25.9%。对应的劳务外包报酬,也从2.44亿元增加到3.02亿元。

这不能证明星宇简单地把“正式员工换成外包工”,不同岗位和工厂无法一一对应。但至少说明,在正式员工大幅减少的同时,公司对外部弹性用工的需求并没有同步下降,反而明显增加。

站在企业经营者的角度,这很好理解。正式员工意味着更稳定的劳动关系,也意味着行业波动时更高的固定成本;外包更灵活。从财务管理上看,这是提高组织弹性。但从员工角度看,同一件事还有另一面:企业把原来自己承担的一部分经营波动,转移给了劳动者。

企业发展顺利的时候,股东通过利润、分红和股价上涨获得收益,核心员工也可能通过奖金和股权激励参与分享。星宇并非完全没有员工激励,2025年员工持股计划覆盖68名高级管理人员和骨干员工,所以简单说“企业赚钱从来不分给员工”并不准确。

真正不对称的是,大部分普通员工主要拿工资,上行空间有限;但当订单预测错了、组织扩张过快或者行业突然下行时,他们的工作本身却可能成为企业最先调整的变量。经营者拥有更大的决策权,也享有更多企业成功带来的收益,那么在决策出现错误的时候,理论上也应该承担更多责任。

可如果大家真的把星宇“抵制倒了”,谁最先受伤?

一些员工把问题提交给了奔驰等供应链相关方,奔驰目前至少已经确认受理并转交进一步审查。社交媒体上也出现消费者抵制星宇产品、甚至抵制使用星宇车灯车型的声音。这里需要说清楚:现在没有证据证明奔驰已经取消星宇订单,也没有证据表明港交所因为这件事暂停了星宇上市,更没有销量数据能够证明消费者抵制已经产生实际销售影响。

但这种风险确实存在。星宇是整车厂供应链的一部分,一旦客户因为劳动合规、ESG,也就是环境、社会和公司治理,或者声誉问题削减采购,最直接的结果就是收入和订单减少。

假设当初招聘和人员规划是少数管理者做出的,107名毕业生先承担了第一轮成本;员工维权以后,如果公司下一步为了保利润再次压缩成本,那么承担第二轮成本的,很可能是剩下的7000多名正式员工、外包工,以及依赖星宇订单生存的供应商。这些人同样没有参与最初的决策。

我并不是说消费者不应该抵制,更不是说107名毕业生就应该忍下自己的损失。消费者当然有权决定自己的钱花给谁,劳动者也应该使用法律、监管和客户合规渠道保护自己。没有这些约束,企业更没有动力尊重员工。

但“惩罚一家公司”和“惩罚做错决定的人”,并不是完全相同的一件事。公司在法律上是一个主体,在现实里却是一群利益不同的人:创始人、董事会、高管、普通员工、外包人员、股东、供应商。错误决定可能只有少数人参与,市场惩罚却会扩散到整个组织。

让决策权和责任重新匹配

所以回到标题的问题,企业犯错到底应该由谁买单?

我的答案并不是普通员工不应该承担任何经营风险。市场经济里不可能完全隔绝行业周期,公司也确实需要在需求变化时调整人员。股东同样不是只赚不赔,企业估值下降、利润减少甚至破产时,资本也会承担损失。

我更在意的是,风险承担应该尽量与决策权和收益权匹配。

对于107名毕业生,首先应该把劳动合同和补偿问题妥善解决;对于公司自己承认的“管理层决策失误”,还应该回答,它到底发生在HR执行层,还是招聘规划、订单预测和经营管理层。停职一个人力资源总监很容易,但如果440人的招聘本身来自更高层的经营计划,那么只处理HR显然不足以解释整件事。

资本市场和客户的监督,也应该更多指向公司治理。上市审核真正应该关心的,不只是这一百多人最后拿到了多少钱,而是企业有没有机制,避免下一次经营预测发生变化时,又把最容易处理的人当成风险缓冲垫。

我过去做企业和产品相关的工作,越来越觉得一个组织真正的管理水平,往往不是在增长最快的时候看出来的。订单增加、利润上涨的时候,很多问题都可以被增长掩盖;真正到了收入变慢、利润承压、需要做取舍的时候,企业选择让谁先承担成本,才最能看出它怎么理解员工、股东和自己的责任。

星宇最终会不会因为这次事件影响H股上市,现在还不知道。奔驰的审查会走到哪一步,也不能提前下结论。

但107名应届生已经把一个现实问题摆到了台面上:企业当然需要经营效率,也必须允许失败和调整;只是一个成熟的市场规则,不应该让拥有最少决策权的人,一次又一次成为最方便的成本承担者。

如果一个人拥有更多决定企业方向的权力,也分享了更多企业成功的收益,那么企业犯错的时候,他理应比那个刚入职一个月的年轻人承担更多代价。

连Sam Altman都没真正用上Codex,AI还缺一次iPhone时刻

最近看完 David Senra 对 Sam Altman 的这期访谈,我印象最深的不是他谈 OpenAI 接下来要训练什么模型,而是一个很小的细节。

Senra 问 Sam,有没有哪件事情连他自己都觉得很矛盾:明明知道 AI 已经可以用一种更好的方式完成工作,甚至这个产品就是自己公司做的,但还是改不过来。

Sam 说,自己已经用电脑20年了,现在明明有 Codex,理论上应该彻底换一种方式工作,但现实里,他依然会一封封看邮件,在不同聊天软件之间复制粘贴,维护 To-do List,然后按照过去20年的方式处理这些重复工作。

他没有把原因简单归结为“人的习惯太顽固”,而是说了一句我觉得更值得讨论的话:这“mostly a product failure”。随后他把今天的 AI 比作 iPhone 出现之前的智能手机——很多技术已经有了,但那个彻底改变人与技术交互方式的产品还没有出现。AI 还没有迎来自己的“iPhone moment”。

这句话比“AI什么时候达到AGI”更让我感兴趣。过去三年,模型能力不断上台阶,但如果把视线从 Benchmark 移回办公室,会发现很多人的工作方式并没有同步改变。

问题可能已经开始从“AI会不会做”,变成“为什么我们还没有这样工作”。

Sam承认自己看错的,是AI改变现实的速度

这期访谈前面还有一个很重要的铺垫。

Sam 说,他现在非常关注 Shopify CEO Tobi Lütke。Tobi 不是让下属做一份“AI转型方案”,而是自己写软件、试模型、重构工作流。Shopify 在2025年4月就把“默认先用AI”变成内部原则,后来官方披露,公司已经普遍采用 AI 代码编辑器,并购买了数千个 Cursor 许可证。

Tobi 的判断也很激进:2026年很多现有业务都会重新变得“up for grabs”,因为别人可以从零做一个 AI-native 的版本。但 Sam 这次反而没有那么乐观。

他回忆说,2023年 GPT-4 出来以后,自己原本以为软件行业会很快发生更大的重构,很多现有软件公司的位置会迅速动摇。三年之后,他承认这个时间判断错了。原因并不是模型没有继续进步,而是“经济有太大的惯性”:用户继续向熟悉的公司买东西,公司继续使用熟悉的软件,员工继续按照熟悉的流程工作。Sam 的结论是,整个行业过去在时间表上都太激进了,社会和经济适应 AI 的速度会更慢。

过去关于 AI 的很多预测,都隐含着一个简单的等号:模型能力提高多少,现实世界就会跟着变化多少。但现在看,模型能力是一条曲线,技术进入组织、流程和人的习惯,是另外一条曲线。

AI用得越来越多,公司却没有同样快地变得更赚钱

如果这只是 Sam 自己的感受,当然还不能说明什么。但我后来又看了一下 McKinsey 刚刚发布的2026年全球 AI 调查,里面有一组数字很有意思。

这项调查覆盖97个国家、1719名受访者。接近九成受访者所在的组织,已经至少在一个业务部门经常使用 AI;44%的企业已经进入全公司规模化使用。80%的受访者也明确表示,AI提升了个人生产率。

但到了公司财务结果这里,增长突然慢了下来。只有37%的受访者认为 AI 已经对所在企业的 EBIT,也就是息税前利润,产生正面贡献,这个比例和2025年基本没有变化。McKinsey 定义的“AI高绩效企业”——至少5%的 EBIT 可以归因于 AI,同时认为 AI 已经产生显著价值——也只有6%。

这个反差很能说明问题。员工已经觉得自己更快了,公司也买了更多 AI,但“个人快一点”并不会自动变成“整个公司效率提高同样多”。

公司不是一群独立工作的个人简单相加。一个员工用 AI 把文档从两小时缩短到20分钟,如果下一步审批仍然要等两天,企业整体速度几乎没有变化。

这也是为什么我现在越来越觉得,讨论企业有没有“采用AI”,意义正在变小。给所有员工买一个 ChatGPT 账号当然算采用,给程序员装上 Coding Agent 也算采用,但它们和真正改变公司的工作方式,中间还差得很远。

把AI塞进旧工作流,不等于真的变成AI-native

我自己在开发软件时,对这个差别感受很明显。现在 Coding Agent 已经可以承担很大一部分代码实现,但如果我仍然按照以前的方式,把一个任务拆成很小的需求,写完一段再人工检查一段,那么得到的主要还是“写代码更快”。

更大的变化,是重新考虑哪些事情根本不应该再由人逐步执行:Agent 能不能自己读取代码库和历史上下文,测试和验证能不能同步完成,人只在架构、取舍和异常节点上介入。做到这一步,变化的才不是某一个环节的速度,而是整个工作方式。

企业里也是一样。McKinsey 的2026年调查中,真正获得显著 AI 价值的那6%企业,有接近四分之三已经因为 AI 对工作流进行“根本性重新设计”;其他企业这么做的只有约四分之一。

这让我想到经济学里经常讨论的“生产率J曲线”。电力刚进入工厂时,很多企业只是把蒸汽动力换成电动机,原来的布局和流程并没有改变。后来企业围绕电力重新设计机器布局、生产线和组织方式,更大的生产率提升才逐渐出现。美国国家科学院总结相关研究时提到,工厂从电气化到获得显著生产率提升花了30—40年,关键就在于它们最终不再围绕中央动力轴组织生产,而是给机器配置独立电机,按照物料流重新设计工厂。

AI现在怎么看都有一点类似。

给员工买 ChatGPT、给程序员买 Codex,然后在原来的流程旁边加一个 AI 按钮,当然已经能提高效率,但它距离 AI-native 还有很远。

所谓AI的iPhone时刻,可能是一种新工作方式

所以我比较认同 Sam 的“iPhone moment”这个比喻,但我理解的重点并不是将来一定会出现一台类似 iPhone 的 AI 硬件。

今天使用 AI,很多时候还是一个主动行为。收到一封邮件,我先判断这件事情能不能交给 AI,然后打开 ChatGPT,把背景复制进去,再告诉它我要什么,拿到答案以后检查,再复制回邮箱。AI仍然是一个外挂在旧工作流旁边的工具。

如果未来 AI 已经知道我的邮件、日历、文档、项目历史和工作目标,它可以自己判断哪些事情能够完成,哪些需要我决定,只在真正需要判断、授权和承担责任的时候把问题交回来,那时候人与计算机的关系才真的变了。

到了那一步,我们可能也不会天天说“我今天用了几个小时AI”。我更倾向于认为,AI的iPhone时刻首先是一种交互方式和工作方式的变化:从人主动调用AI,变成AI默认存在于工作过程中。

不过,我并不完全认同 Sam 所说的“主要是产品失败”。今天的 Agent 还有一个 iPhone 当年不存在的问题:可靠性。

手机上的一个 App 偶尔崩溃,用户重开一次也就算了;一个替你发邮件、改生产代码、操作企业系统甚至执行付款的 Agent,如果每20次任务里有一次严重错误,就很难真正做到无人监督。

METR 今年更新的 Agent “任务时间跨度”研究显示,前沿模型能够独立完成的软件任务长度仍在快速增长,但 METR 特别提醒,50%时间跨度并不意味着这个长度以内的任务都可以放心交给 AI。一些可靠性要求高、又难以验证的工作,可能需要98%以上的成功率才值得自动化;现实工作通常还比测试集里的任务更混乱。

所以今天没有出现 AI 的 iPhone 时刻,不能全部怪产品经理,也不能简单归结为人的习惯。模型的可靠性、长期任务能力、上下文、权限、安全和成本仍然需要继续进步;另一方面,我们也确实还没有找到一种足够自然的产品形态,把这些能力真正嵌进绝大多数人的工作里。

回到 Sam 自己那个有点尴尬的例子。他当然知道 Codex 能做什么,甚至比绝大多数人更早知道这些能力将走到哪里,但第二天打开电脑,他还是可能先点开邮箱,然后按照20年来形成的习惯开始工作。

这并不说明 Codex 不重要,反而说明一个新技术从“已经可以做到”走到“所有人自然地这样做”,中间还有一段很长的路。

ChatGPT 已经完成了 AI 的第一次大众普及。但如果把“iPhone时刻”理解为彻底改变人与计算机的交互,那么至少从现在来看,这件事情确实还没有发生。

等它真正发生的时候,我们大概不会再讨论“应该怎么把AI加入工作流”。

因为那时,我们已经很久没有按照过去的方式工作了。

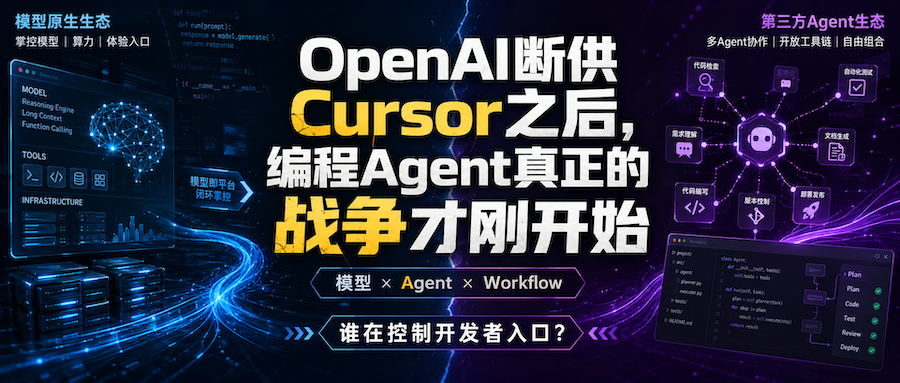
OpenAI断供Cursor之后,编程Agent真正的战争才刚开始

前几天,OpenAI宣布准备终止向Cursor提供模型的定制合作,拟定的停止日期是11月12日。官方给出的理由,是Cursor被SpaceX收购之后,OpenAI无法确认SpaceX会继续按照自己的服务条款使用模型,而不是Cursor本身违反了合同。

如果只看新闻,这很容易被理解成Sam Altman和Elon Musk之间又一次冲突。但我看到这个消息之后,想到的却是另一个问题:如果OpenAI有Codex,Anthropic有Claude Code,Google有Antigravity,xAI也有Grok Build,那么Cursor、OpenCode这些原本建立在第三方模型之上的编程Agent,未来还有多少价值?

过去我的答案可能会比较简单:当然有。模型公司负责把模型做好,Cursor负责把Agent和开发体验做好,大家处在产业链不同的位置。

但现在,这个答案已经没有那么确定了。

因为Coding Agent真正的竞争,正在从“哪个模型更强”,变成“谁能把模型、Harness、工具、上下文和开发工作流整合得更好”。而这场竞争里,模型公司和第三方Agent正在从两个方向往同一个位置靠近。

第一方Agent正在快速吃掉开发者入口

先看一个很有意思的数据。

JetBrains今年5月至7月对超过1.5万名专业开发者进行的调查显示,Claude Code的工作使用率已经从今年1月的18%升到39%,Codex则从3%升到16%。相反,Cursor从18%降到12%,OpenCode目前大约是7%。

这不是严格意义上的市场份额,而且调查数据一定存在样本偏差,但趋势已经很明显:目前增长最快的Coding Agent,恰恰是模型公司的第一方产品。

这其实和两年前很多人的判断不太一样。

Claude Code刚出来的时候,它甚至不像一个互联网时代应该有的产品:没有漂亮的IDE,也没有复杂的界面,就是一个Terminal里的Agent。但它现在反而成了开发者使用最多的AI Coding工具之一。

原因可能并不复杂。

我们以前习惯把Coding能力理解成模型能力,所以会比较Claude、GPT、Gemini谁在SWE-bench上高几分。但实际开发时,开发者使用的从来不只是一个模型,而是:

Model × Context × Tools × Agent Loop × Runtime。

Anthropic自己做过一个很有意思的实验。使用同一个Claude Opus 4.5,一个简单的单Agent跑20分钟、成本9美元;加入Planner、Evaluator等完整Harness之后,运行6小时、成本200美元,虽然贵了20多倍,但最终应用的完成度也明显提高。后来Opus 4.6能力增强,他们又开始删除Harness中已经没有必要的部分。

这里其实说明了一件很重要的事:模型和Harness不是两个完全独立的东西。

模型越强,Harness应该怎样设计也会跟着变化。

这正是Anthropic、OpenAI、Google这些模型公司的天然优势。它们不仅知道下一代模型什么时候发布,还知道模型在哪些地方变强了、哪些Prompt不再需要、上下文应该怎样组织、什么时候应该调用Subagent,甚至可以直接针对自己的Agent Harness训练模型。

Google现在就明确说,Antigravity的Harness与Gemini模型,特别是Gemini 3.5 Flash,是共同优化的。Google今年二季度还披露Antigravity已经超过240万周活跃用户。

所以,如果只看到这里,我会觉得Cursor这类第三方Agent的未来确实有点危险。

但事情并没有这么简单。

最好的Coding模型,不会永远是同一个模型

过去一年我越来越明显地感受到,AI Coding有一个很麻烦的特点:不存在一个模型在所有任务里都最好。

有的模型更适合Planning,有的Debug更好,有的前端审美更稳定,有的速度快、价格低,适合跑大量机械任务。更重要的是,这种排名几乎每隔几个月就会变化。

这正是Cursor这类第三方Agent存在的基础。

Cursor今年7月推出了Cursor Router,不再让用户自己决定每一次应该选Claude、GPT还是Grok,而是在请求进入模型之前,先判断这个任务更适合哪个模型。Cursor称Router使用超过60万条真实请求训练,在数百万次真实请求的A/B测试中,可以在保持前沿模型体验的同时节省约60%的成本。这个数据来自Cursor自己,当然不能当成第三方评测,但它透露出来的方向很值得关注。

以前我们理解的多模型Agent,有点像一个模型超市。

今天用Claude,明天GPT变强了就切GPT。

但真正有价值的第三方Agent,未来可能根本不会让用户选择模型。它自己知道一个简单的Git操作没有必要调用最贵的模型,架构设计可以用更强的推理模型,Debug又可以换另一个。

到了这一步,第三方Agent卖的就不再是“我支持很多模型”。

它卖的是:

我知道什么时候该用哪个模型。

这和云计算很像。用户真正需要的并不是自己决定每个计算任务运行在哪一颗CPU上,而是希望平台在成本、速度和性能之间自动做选择。

如果未来Claude、GPT、Gemini和Grok之间的能力差距继续缩小,这种价值反而可能越来越大。

OpenAI断供Cursor,暴露的是第三方Agent最大的软肋

但是Cursor的问题也正好出现在这里。

你可以做最好的Router,可以拥有最好的开发体验,可以积累大量真实Coding数据,但最重要的生产资料——模型——仍然可能掌握在别人手里。

这次OpenAI停止与Cursor的定制合作,就第一次把这个问题摆到了台面上。

这里需要说清楚:目前没有证据证明OpenAI是在通过断供打击Codex的竞争对手。OpenAI给出的正式原因,是Cursor控制权转移到SpaceX后产生的合同和合规风险。事实上,就在宣布终止Cursor合作前四天,OpenAI刚刚把GPT-5.6 Sol、Terra和Luna全部提供给Amazon的Kiro,并明确表示双方还会继续针对Coding Agent做联合优化。

所以这并不是“OpenAI开始封锁第三方Agent”。

但它至少证明了一件事:

当模型供应商同时也是你的竞争对手时,“模型中立”并不是一个完全由第三方Agent自己决定的商业模式。

今天可以是合同问题,未来也可能是价格、发布时间、功能开放范围甚至算力供应问题。一个第三方Agent即使拥有用户,也无法保证下一代最好的模型一定会第一时间给自己。

有意思的是,Cursor显然也看到了这个问题。

8月14日完成被SpaceX收购之后,Cursor公开表示将获得SpaceX的大规模GPU资源,用于训练能力更强、运行成本更低的模型。两天前发布的Grok 4.6,更已经被Cursor直接定义成“first-party Cursor model”,它不是简单接入xAI API,而是Cursor与SpaceXAI共同训练出来的模型。

换句话说,最典型的“第三方模型Agent”,现在自己也开始做模型了。

OpenCode走的是另一条路。它仍然强调可以连接不同Provider,但同时推出了OpenCode Zen,自己测试模型、选择Provider、优化部署,再统一卖给用户。本质上,它也正在从单纯的Agent往模型Gateway和路由层延伸。

所以现在再把市场简单分成“模型公司”和“第三方Agent”,其实已经不太准确。

双方最后争的,是同一层东西

如果把现在几家公司的动作放在一起看,会发现一个很有意思的趋势。

OpenAI、Anthropic、Google原来在最上面做Model,现在不断往下做Codex、Claude Code和Antigravity;Cursor原来在最下面做IDE和Agent,现在却往上做Router、训练模型、拿GPU算力;OpenCode也从开源Harness往模型Gateway走。

双方正在向中间汇合。

未来真正的竞争单位,很可能既不是一个Model,也不是一个Agent,而是一整套Coding Stack:

Model + Router + Context + Harness + Tools + Runtime + Workflow。

模型公司的优势很明显。它们可以让自己的模型和Harness一起进化,新模型没有接入延迟,推理成本也比第三方购买API低,而且还可以把Coding Agent直接塞进ChatGPT、Claude、Gemini现有的订阅体系。

但第三方Agent也不是没有机会。

它最大的优势,是不需要假设自己的模型永远最好。

一个真正中立的Agent,目标不是让用户尽可能多地使用Claude或者GPT,而是把任务完成。因此它理论上可以在不同模型之间不断切换,并把模型逐渐变成一种可替换的底层计算资源。

所以我现在更愿意这样理解这场竞争:

第一方Agent的优势,是让一个模型发挥到最好;第三方Agent真正的机会,是让不同模型组合起来,比任何一个模型都更好用。

当然,这有一个很大的前提:第三方必须始终能够拿到这些模型。

这也是为什么Cursor最终还是开始自己训练模型。

真正危险的,可能不是Cursor,而是只比API多一层UI的Agent

因此我并不认为OpenAI停止向Cursor供应新模型,就意味着第三方Coding Agent没有未来。

真正越来越难生存的,是另一类产品:没有自己的工作流,没有真实用户数据,没有Runtime,没有Router,也没有长期上下文,只是在Claude或者GPT外面套了一层界面。

因为这些东西太容易被模型公司直接做掉。

反过来,一旦一个Agent真正掌握了我的代码库、项目规则、Skills、MCP、测试方式、部署流程、GitHub以及团队协作习惯,底下到底运行Claude还是GPT,反而可能没有今天那么重要。

这也是Coding Agent市场最值得观察的变化。

过去两年,我们几乎每天都在讨论谁的模型又超过了谁。但如果AI Coding继续向Agent发展,真正决定用户是否迁移的,很可能逐渐从模型变成工作流。

OpenAI断供Cursor不会杀死Cursor,Claude Code快速增长也不能证明模型公司一定会赢。

它们真正说明的是,同一个时代正在结束:模型公司只负责提供API,第三方公司只负责做应用。

接下来,模型公司会继续往下走,第三方Agent也会继续往上走。

最后双方争夺的,其实是同一个位置——

谁能成为开发者每天工作的那一层。

错失 ChatGPT 的前夜:Google 为什么亲手杀死了自己的 LMChat?

我最近看了前 DeepMind 工程师、后来加入 OpenAI 的 Thibault Sottiaux(Tibo)的一次访谈。里面有一段关于 LMChat 的回忆,我觉得比很多关于 Google“为什么错失 ChatGPT”的分析都更有意思。

大约在 ChatGPT 发布前一年,DeepMind 的语言模型团队已经做出了不错的效果。团队很自然地想到:能不能把它做成一个可以直接聊天的东西?于是有了内部的 LMChat,而且一度希望把它变成面向公众的产品。

Tibo 回忆,LMChat 最开始“好笑多过有用”,但后来逐渐变得越来越有帮助。

Tibo 说,当时的 DeepMind“并不是一个为交付产品而设计的组织”。他此前还公开提到,Google 对发布 LMChat“过于紧张”,而 DeepMind 也受到限制,不能轻易推出可能颠覆 Google 现有业务的产品。

今天回头看,很容易说:如果 Google 当年把 LMChat 推出去,ChatGPT 的历史可能就会改写。但我觉得真正值得讨论的,不是“Google 为什么这么蠢”。恰恰相反,很多决定从一家成熟公司的角度看都很合理,问题也正在这里。

Google 不是没有看到,而是很难把它变成产品

关于 Google 错失生成式 AI,最常见的说法是:Google 有 Transformer、有最好的 AI 科学家、有 TPU,却没有意识到大语言模型的重要性。

LMChat 的存在恰好说明,这个解释并不成立。

DeepMind 不仅看到了语言模型的潜力,而且已经做出了可以聊天的内部原型。Google 缺的不是发现趋势的能力,而是从研究原型走到消费产品的那一段。

当时的 DeepMind 是一个非常有创造力的研究组织,但并不是围绕消费产品交付建立起来的。研究团队可以把模型能力做出来,但要把它真正交给几亿用户,中间还有产品、安全、基础设施、品牌和商业模式等一整套问题。

DeepMind 也并非完全不做产品化,但更多是把研究能力带进 Google 已有产品,而不是自己从零做一个直接面向用户的新入口。

LMChat 麻烦的地方就在于,它不是给 Search 增加一个功能。

它本身就是另一种获取信息的入口。

一旦要公开 LMChat,问题马上变成:它和 Search 是什么关系?谁为错误回答负责?广告怎么办?这些问题每一个都合理,但叠在一起,一个新产品就很容易永远停留在内部。

Google 最难回答的问题,其实是搜索

我觉得 LMChat 真正撞上的,是 Google 最难处理的一类创新:它不是帮助原有业务做得更好,而是可能改变原有业务为什么存在。

2021 年 Alphabet 全年营收约 2576 亿美元,其中 Google Search & other 接近 1490 亿美元,占总营收约 58%;整个 Google 广告业务约 2095 亿美元,占总营收超过八成。

传统搜索的商业模式已经运行二十多年:用户提出问题,Google 返回结果,用户点击链接,在这个过程中完成广告变现。

而聊天式 AI 的逻辑正好相反:用户提出问题,AI 尽量直接给出答案。

如果答案已经在对话框里完成了,用户为什么还要点击十个蓝色链接?

更麻烦的是,当时大语言模型的推理成本远高于一次传统搜索请求。于是从财务模型看,这是一笔很别扭的账:Google 要用一个成本更高、商业模式还不清晰的新产品,去影响自己已经非常成熟的搜索广告业务。

我们今天当然可以说,公司应该勇于自我颠覆。但真正坐在那个位置上,没有这么简单。

Search 部门很难主动支持一个可能减少搜索点击的产品;财务部门也很难为一个成本更高、短期没有成熟收入模式的新业务给出漂亮的 ROI。所以我更愿意把它理解为结构性矛盾,而不是保守或者愚蠢。

越成功的业务,越难被自己颠覆。

这也是《创新者的窘境》最重要的那类问题:很多优秀公司失败,不是因为管理太差,而是因为它们太擅长围绕现有客户、利润和投资回报做出“正确决策”。

LMChat 恰好撞上了 Google 最成功的那套正确决策。

OpenAI 真正不同的,是先把东西交给用户

再看 OpenAI,情况完全不同。

2022 年 11 月 ChatGPT 上线时,远远谈不上完美。OpenAI 在发布公告里就承认,它会生成听起来合理但实际错误的回答,也会受到提问方式影响。它没有把 ChatGPT 当成完成品,而是明确称为一次 research preview,希望通过真实用户了解模型的优势和弱点。

区别不在于 OpenAI 不在乎风险,而是它更愿意先把一个“不完整但已经有价值”的东西交给用户,再从真实反馈中继续迭代。

Tibo 在访谈里用了两个词。

一个是 Bias to Ship,偏向交付。

另一个是 Stop Energy。

他并不是说 Google 当年内部有一个叫“Stop Energy”的机制,而是在形容 OpenAI 的文化:新产品想法出来之后,团队可以很快做出来、发布出去,内部对新想法的阻力很小。研究团队和产品团队也会一起构思、一起设计。

这背后的差别,不是谁更聪明,而是谁更容易形成真实用户的反馈闭环。

Benchmark 能告诉你模型在一道题上得多少分,却很难告诉你普通用户到底会拿它来做什么。ChatGPT 上线以后,用户开始用它写邮件、改代码、总结资料,也不断暴露之前没有被发现的问题。

这些使用行为不会让模型自动实时学习,但会影响后续的评测、训练、对齐和产品设计。

我觉得这才是 ChatGPT 当年最重要的意义:它不只是发布了一个模型,而是让大语言模型真正进入了用户反馈循环。

Google 有 LMChat,却没有走完这一步。

Google 错过的,其实不是 AI

如果只看后来的结果,很容易把这个故事讲成“Google 发明了一切,最后什么也没得到”。这也不准确。

Google 并没有因为错失 ChatGPT 就退出 AI 竞争。后来 Google 合并 Brain 和 DeepMind,Gemini 也重新回到了前沿模型竞争的中心。

所以 Google 真正错过的,并不是 AI 本身。

它错过的是定义第一代生成式 AI 大众产品的机会。

技术领先可以追回来,Benchmark 也可以反超,但用户第一次建立起“AI 就应该这样用”的认知,往往只有一次。

ChatGPT 出现之后,很多人第一次意识到,获取信息不一定非要先搜索网页,也可以直接和 AI 对话。

这个产品认知原本有机会由 Google 建立,最后却被 OpenAI 抢先完成了。

它提醒所有已经成功的公司:真正困难的从来不是看见下一代技术,而是在下一代技术开始威胁今天的成功时,你还愿不愿意把它交给用户。

而这件事对 OpenAI 同样成立。

今天的 OpenAI 已经有 ChatGPT、有企业客户、有 API、有开发者生态,也开始拥有不能轻易被打破的东西。

当一家公司开始拥有自己的“搜索广告业务”——不一定真的是广告,而是任何必须保护的核心收入和产品——Stop Energy 就会自然出现。

所以 LMChat 的故事并没有结束。

Google 当年回答错的那道题,迟早也会摆到每一家成功的 AI 公司面前:

当下一代产品开始威胁今天最赚钱、最成功的产品时,你还敢不敢把它做出来?

Codex负责人Tibo最新访谈:OpenAI开始让AI改进自己,真正变化的却不是模型

我最近看了 Matthew Berman 对 OpenAI 的 Thibault Sottiaux(Tibo)的一次访谈。里面聊了很多现在大家比较关心的话题,包括 Codex、Ultra Fast、OpenAI 和 Anthropic 的竞争,以及下一代 Agent 会变成什么样。

但真正让我停下来想了一会儿的,是其中一段关于 Recursive Self-Improvement,也就是“递归自我改进”的讨论。

以前看到这个词,我首先想到的也是一个很科幻的场景:GPT-6 开始研究怎么训练 GPT-7,GPT-7 出来以后又自己设计 GPT-8,模型越来越聪明,研发下一代模型的速度也越来越快,最后进入所谓的“智能爆炸”。

按照这个标准,今天显然还没有发生递归自我改进。

但 Tibo 提出了一个我觉得更现实的角度:模型并不是孤立存在的。一个真正能够工作的 AI 系统,除了模型本身,还有训练系统、Inference、CUDA Kernel、Harness、缓存、网络、调度乃至最下面的芯片。

如果今天的模型已经可以帮助工程师改进这些运行 AI 所必需的基础设施,而这些改进又会让下一代模型运行得更快、成本更低,那么它其实已经构成了另一种形式的反馈循环。

我后来去看了一下 OpenAI、Anthropic 和 Google DeepMind 最近公开出来的数据,发现这件事已经不只是一个访谈里的想法。

AI确实开始参与“生产AI”了。

AI已经开始参与自己的开发

今年2月发布 GPT-5.3-Codex 时,OpenAI用了一句非常值得注意的话:这是他们第一款“在自身创建过程中发挥关键作用”的模型。

Codex团队使用GPT-5.3-Codex的早期版本,去调试自己的训练过程、管理部署、分析测试和评估结果。换句话说,在这个模型正式完成以前,一个还没有最终完成的自己,就已经进入了自己的研发流程。

如果事情只到这里,我觉得还不能叫递归自我改进。

因为这和我们今天用Claude Code或者Codex开发一个软件,本质上没有太大区别。人还是提出问题,AI只是把写代码、调试这些工作做得更快。

真正让我觉得这个变化值得关注的,是OpenAI在7月底公布GPT-5.6的推理优化过程。

这次模型做的已经不是普通的软件开发了。

OpenAI披露,GPT-5.6 Sol通过Codex分析真实生产流量,寻找负载不均衡的问题,测试新的路由策略;它还自主重写和优化生产环境里的GPU Kernel。这一系列Kernel优化最终让端到端模型服务成本下降了20%。

更有意思的是 speculative decoding。

现在很多大模型为了提高生成速度,会让一个更小的draft model先预测接下来的Token,再让主模型一次验证多个结果。OpenAI让GPT-5.6 Sol去改进自己的这个draft model。

它自己设计并运行了数百个实验,测试不同的模型大小、结构和特征,还启动并监控训练,在遇到硬件故障和训练不稳定时自行干预。最后,这些优化让Token生成效率提高了超过15%。

这时候事情就开始有点不一样了。

模型正在优化运行模型的系统。

而这个系统变得更快以后,又可以用同样的GPU运行更多推理、做更多实验,下一轮模型研发的成本也随之降低。

真正变化的不是模型,而是AI研发开始出现反馈循环

我觉得理解这件事最重要的一点,是不要只盯着“模型有没有自己训练下一个模型”。

AI不是一个单独的模型文件。

从训练数据、训练框架,到GPU Kernel、Inference Engine、缓存、网络、调度、Agent Harness,再到最下面的芯片,这些东西共同决定了我们最终能以什么成本获得多少“智能”。

所以真正需要观察的是:

更强的模型,能不能帮助改善这一整套生产AI的系统。

如果可以,就会出现这样一个循环:

更强的AI帮助优化训练和推理系统,让同样的算力可以完成更多工作;更高的计算效率又让研发团队能够运行更多实验、降低推理成本;这些效率最终又支撑更强的下一代AI,而新的AI再继续优化这套系统。

OpenAI自己其实也把Inference优化称为一个“continuous feedback loop”。他们会观察真实生产系统、寻找最大的效率缺口、实施改进,再验证改进是不是对整个系统有效,而GPT-5.6和Codex正在加速这个循环里的每一个步骤。

今年6月发布的Jalapeño芯片,把这个循环又往下推进了一层。

这是OpenAI与Broadcom联合开发的第一款自有AI推理芯片。OpenAI称,从初始设计到完成流片只用了9个月,其中模型被直接用于加速一部分芯片设计和优化过程。

OpenAI在介绍这款芯片时甚至直接写了一句话:今天服务用户的同一批模型,正在帮助改进未来用于运行这些模型的基础设施。

这句话其实比“AI自己写代码”重要得多。

因为芯片效率提高以后,会降低未来模型的推理成本;未来更强的模型,又可以继续参与下一代芯片、Kernel和推理系统的优化。

这个循环开始跨越模型、软件和硬件。

这不是OpenAI一家正在发生的事情

如果只有OpenAI自己的案例,我们当然还可以把它理解成一种公司宣传。

但类似的事情也发生在Google DeepMind。

DeepMind去年发布的AlphaEvolve,是一个由Gemini驱动的算法发现Agent。它其中一个实际用途,就是优化Google自己的AI基础设施。

AlphaEvolve重新寻找了一种大型矩阵乘法的计算方式,让Gemini架构里的一个关键Kernel速度提高了23%,最终让Gemini整体训练时间缩短了大约1%。

1%看起来不多,但前沿模型一次训练消耗的计算资源非常巨大,这种百分之一级的改善已经意味着相当可观的算力节省。

在FlashAttention Kernel上,AlphaEvolve最高还获得了32.5%的性能提升。更关键的是,DeepMind明确提到,这些基础设施也被用于训练支撑AlphaEvolve本身的大模型。

也就是:

Gemini驱动AlphaEvolve,AlphaEvolve优化Gemini运行和训练所需要的系统,然后改善后的系统又被用于训练未来的Gemini。

这已经非常接近我理解的“现实版递归”。

不是AI突然坐下来发明一个比自己聪明十倍的新模型,而是它开始一点点改造生产自己的机器。

Anthropic最近甚至直接把这件事写成了一篇题为《When AI builds itself》的文章。

其中一个很有意思的数据是,截至今年5月,Anthropic合入生产代码中超过80%的代码已经由Claude编写。2026年第二季度,典型工程师每天合入的代码量大约是2024年的8倍。当然Anthropic自己也特别提醒,代码行数并不等于真实生产率,8倍显然会高估实际提升。

但更值得看的不是代码数量,而是实验能力。

Anthropic一直会给新Claude做一个测试:给它一段训练小型AI模型的代码,在保持结果正确的情况下,尽可能把训练速度优化到最快。

2025年5月,Claude Opus 4平均可以做到大约3倍加速;到了2026年4月,内部的Mythos Preview已经做到约52倍。Anthropic同样强调,这个数字不能理解成“真实大模型训练速度提高了52倍”,它真正反映的是,在一个目标明确的实验循环里,AI自己修改代码、运行实验、观察结果、继续迭代的能力,在一年里发生了非常大的变化。

但这还不是我们过去说的RSI

写到这里很容易得出一个更刺激的结论:

AI已经实现递归自我改进了。

我觉得目前还不能这么说。

Anthropic自己的表述其实非常克制。他们把完整的Recursive Self-Improvement定义为:一个AI系统能够自主设计并开发自己的继任者,然后新的系统继续重复这个过程。

对于这一点,Anthropic明确说:“We are not there yet。”

今天人仍然在这个循环里扮演非常关键的角色。

模型现在最强的地方,是当人给出一个比较清楚的目标后,它可以越来越独立地完成“怎么做”。

优化哪个Kernel、怎样降低延迟、怎么跑实验、为什么训练失败,这些执行和实验工作越来越适合交给Agent。

但“什么问题值得研究”“哪个方向更有价值”“结果是不是真的可信”,今天仍然大量依赖人的判断。

Anthropic的内部数据其实也说明了这一点。他们认为Claude已经可以在一个明确实验目标下达到甚至超过熟练研究人员,但到了选择研究目标、判断什么问题值得做的时候,能力差距仍然明显。

而且就算AI研发这一段变快十倍,也不意味着整个AI产业可以变快十倍。

芯片要制造,数据中心要建设,电力要接入,训练结果要验证。模型可以一天设计一百个ASIC方案,台积电也不可能第二天把一百块先进制程芯片交出来。

一个环节被加速以后,瓶颈只会转移到另一个环节。

所以我并不认为这些案例能够证明所谓的“智能爆炸”马上就会发生。

真正需要重新理解的,是AI为什么可能越来越快

但反过来,如果我们因为完整RSI还没有出现,就认为这件事完全没有发生,我觉得同样会错过一个很重要的变化。

过去AI进步主要依靠几样东西:更多算力、更好的数据、更大的模型,以及更优秀的研究人员。

现在正在多出一个新的变量:

上一代AI本身,开始成为研发下一代AI的工具。

而且这个工具不是简单提高一个程序员20%的编码效率。它正在进入训练、实验、Inference、Kernel、Harness乃至芯片设计这些真正决定AI成本和研发速度的位置。

这也意味着,以后判断OpenAI、Anthropic、Google之间的差距,可能不能只看下一张Benchmark排行榜。

更值得关注的问题是:

哪家公司能够建立更强的AI研发飞轮?

谁的模型能够帮助研究人员同时跑更多实验,谁能够更快找到GPU里的效率浪费,谁能够让自己的推理系统更便宜,谁又能够把这些经验继续带到下一代模型和芯片里。

这些东西不会像Benchmark那样每隔几个月有一张排行榜。

但它最终可能决定模型为什么会越来越快,也决定一家AI公司可以用同样数量的研究人员和GPU,产生多少新的“智能”。

我们过去讨论递归自我改进,总是在寻找一个很明确的时间点:到底哪一天,AI开始自己改进自己?

现在看下来,我越来越觉得,这个问题可能问错了。

也许根本不会有一个非常戏剧性的“RSI Day”。

它更可能是从这些看起来并不起眼的工程变化开始:AI先帮工程师写代码,然后开始调试自己的训练,再优化运行自己的Kernel和Inference系统,接着参与设计未来运行自己的芯片。

其中任何一步单独拿出来,都谈不上什么“智能爆炸”。

但当这些步骤逐渐连接起来以后,一个新的反馈循环确实已经出现。

今天我们还不能说AI已经能够独立创造下一代AI,但如果想理解接下来AI为什么可能进步得越来越快,真正值得盯住的,已经不只是模型本身,而是AI正在多大程度上参与生产下一代AI。

Anthropic CEO Dario Amodei说AI 5—10年能治愈大多数疾病,但谁有权踩刹车?

最近 Anthropic CEO Dario Amodei 和投资人 Gavin Baker 在 X 上吵了一场,我觉得这场争论比“AI 到底会不会取代工作”更值得看。

事情最早来自 All-In Podcast。Baker 批评 Dario,这些年他不断强调 AI 可能带来的灾难性风险,客观上正在帮助美国社会形成越来越强的 AI 反弹,特别是围绕数据中心的抵触。考虑到 Anthropic 已经成为全球最重要的 AI 公司之一,Baker 甚至建议 Dario 应该成为一个更加积极的 AI 行业倡导者,而不是继续告诉公众这项技术有多危险。

Dario 随后罕见地写了两篇很长的回复。他不同意自己只讲风险,反而重新提起了 2024 年那篇《Machines of Loving Grace》:如果足够强大的 AI 出现,人类有可能把未来 50—100 年的生物医学进步压缩到 5—10 年,甚至“治愈大多数人类疾病”。他还承认,这个说法听上去不仅普通人会觉得疯狂,连生物学家都会觉得疯狂——而他自己以前就是做生物学研究的。

这句话当然很夸张。但真正让我感兴趣的,不是 Dario 到底有没有吹牛,而是它把一个过去很容易被忽略的问题摆到了桌面上。

如果 AI 发展得太快,可能带来网络攻击、生物安全、模型失控以及其他现在还难以评估的风险;但如果 AI 真的能够大幅加速科学研究和药物研发,那么让它慢几年,同样不是没有代价。某些原本能够更早出现的药物和治疗,会不会因此晚几年到来?

到了这一步,“AI 应该快一点还是慢一点”就不再只是科技公司的产品节奏问题了。真正的问题变成了:谁有权踩油门,谁又有权踩刹车?

一、这不是“乐观派”和“悲观派”的争论

如果只看表面,很容易把 Baker 归到“加速派”,把 Dario 归到“安全派”。但认真看两个人说的话,会发现并不是这样。

Baker 并不否认 AI 的风险。他真正担心的是另外一种错误:因为不断强调最坏情况,社会最终形成过度反应,把 AI 基础设施、模型发展甚至那些真正有价值的科学应用一起压慢。

这种担心并非完全没有现实基础。Reuters/Ipsos 今年 6 月的一项调查显示,只有 33% 的美国人支持目前 AI 数据中心快速建设的速度,64% 反对,77% 担心数据中心最终推高电价。到了 8 月,宾夕法尼亚州已经收紧数据中心的审批规则,要求提高环境和项目透明度,并增加当地社区的参与。

但如果因此把美国今天的数据中心反弹归因于 Dario 的“AI 风险宣传”,明显又说过头了。普通人反对数据中心,很大一部分原因就是电价、用水、土地和当地能够得到多少就业与税收,这些都是非常现实的利益问题。

Dario 的立场其实也远比“让 AI 慢下来”复杂。他今年 6 月发表《Policy on the AI Exponential》,主张最前沿的模型应该接受强制第三方测试;如果模型在网络攻击、生物武器、模型失控或者自动化研发等方面跨过严重风险门槛,政府甚至应该有能力阻止或者撤销部署。

可是在同一篇文章里,他马上又把方向反了过来:到了生物医学,他认为真正值得担心的反而是 FDA、EMA 这样的监管体系太慢,跟不上 AI 可能带来的药物研发速度。

也就是说,同一个 Dario,一边想给 AI 踩刹车,一边又想拆掉新药路上的一些刹车。

这看起来矛盾,其实恰恰说明了问题:AI 根本不存在一个统一的速度。

二、AI真正没有的,是一个总开关

我们平时说“AI 发展太快”,其实把很多完全不同的事情混在了一起。

模型训练得有多快,是一件事;模型什么时候公开,是一件事;数据中心建多少,是一件事;AI 在企业里扩散多快,是一件事;AI 帮科学家寻找一个新的药物靶点,又是另外一件事。

这些速度为什么一定要一样?

Dario 自己的政策建议其实就是一个很好的例子。对于 frontier model,他希望更加谨慎,因为一次发布就可能把新的网络攻击、生物能力直接扩散出去;但到了生物医学,他担心的却是监管系统成为瓶颈。他甚至预计,如果 AI 大幅增加候选药物数量,今天按照传统节奏运行的审批体系很可能被“塞满”。

这个问题确实存在。FDA 过去给出的药物研发资料显示,从首次人体试验到批准,平均可以接近十年,而进入临床试验的药物最终真正获批的比例不到 10%。人体实验、长期安全性、剂量和疗效验证,都不像写代码一样可以通过增加 GPU 把速度无限提高。

而且就在今年 8 月,《Nature Reviews Drug Discovery》刚发表了一篇对 AI 药物研发非常克制的综述。作者认为,AI 在 Drug Discovery 里已经研究和应用了很多年,但真正能够证明它提高了临床成功率、让更安全有效的新药更快到达患者手里的证据,目前仍然非常有限。很多所谓 AI Drug 依然停留在临床前或者一期、二期,进入三期的还很少。

甚至 Anthropic 自己今年做的生物 Agent 研究也暴露了类似问题。让最先进的 AI Agent 直接从 NCBI Virus 这样的生物数据库获取病毒序列,准确率仍然达不到科研所需要的可靠程度;直到研究人员加入一个确定性的专用检索工具,准确率才提高到 90% 以上,最高达到 99.7%。

所以我并不认为“AI 五到十年治愈大多数疾病”可以直接当成一个医学预测。Dario 原来的表述其实还有一个经常被忽略的前提:这 5—10 年不是从今天开始计算,而是从他定义的 Powerful AI 出现以后开始。那个 AI 在他的想象里,已经相当于一个“装在数据中心里的天才国家”。

但即使把这个预测打很大的折扣,问题依然存在:当 AI 开始真实提高科研效率以后,减速也会产生机会成本。

三、踩油门和踩刹车,都在使用别人的风险预算

我觉得这才是这场争论真正有意思的地方。

一家 AI 公司决定提前半年发布一个更强的模型,获得收入、估值和市场份额的是公司自己;但如果模型增加了网络攻击、生物滥用或者其他社会风险,承担后果的显然不只是公司股东。

可反过来也一样。如果监管者因为一个尚未发生的风险,决定把某一类 AI 技术延迟几年,监管者自己同样不会承担全部成本。成本可能落在创业公司、普通开发者、科研人员身上,如果 AI 最终真的能够加速药物发现,也可能落到未来本可以更早得到治疗的患者身上。

换句话说,无论踩油门还是踩刹车,本质上都可能是在使用别人的“风险预算”。

所以我不太赞成一个很常见的答案:既然 AI 公司有利益冲突,那么交给政府决定就好了。这实际上只是把权力从一群人转给了另一群人。

AI 公司当然不能成为判断自己模型是否安全的唯一裁判,Anthropic 自己现在公开支持的也是这一点,认为影响如此大的技术不能只由行业自行治理。 但政府同样会犯错,也会受到政治周期、公众情绪和产业游说影响。如果合规门槛最终变得极其昂贵,它甚至可能成为现有 AI 巨头最好的护城河,因为真正能够负担这套成本的,恰好还是那几家公司。

所以真正的问题从来不是“公司还是政府”。

而是,谁应该决定哪一部分。

四、真正需要拆开的,是决定AI速度的权力

如果一定要给出一个我现在更倾向的答案,我觉得未来的 AI 治理不会,也不应该有一个“总刹车”。

法律首先应该决定边界。比如生物武器、大规模网络攻击、模型失控这类一旦发生可能影响整个社会,而且很难逆转的风险,显然不能完全交给一家公司的商业判断。

但是模型到底有没有跨过这条线,应该尽可能变成可以重复验证的技术问题,由独立第三方评测,而不是 CEO 在发布会上说一句“我们认为安全”,也不是某个政客凭感觉认为“这个东西很危险”。这其实也是 Dario 现在推动 frontier model 第三方测试的核心逻辑。

只要模型没有达到这些高风险阈值,企业仍然应该保留正常的技术和产品决策权。否则每一次模型升级都要经过漫长审批,最后最可能出现的结果并不是 AI 更安全,而是大公司越来越安全,小公司越来越难进入。

到了下游应用,逻辑还应该再反过来。医疗、材料、能源这些能够产生明确社会收益的领域,不应该因为 frontier AI 需要更严格的监管,就沿用同一套减速逻辑。如果未来 AI 真的能够显著提高药物研发成功率,那么临床试验设计、数据基础设施甚至审批制度都应该随着证据改变。

这里真正重要的不是经常被说烂的“发展与安全要平衡”。

而是把速度拆开,也把决定速度的权力拆开。

五、我们可能永远找不到一个正确的AI速度

当然,这套思路也没有解决最难的问题:我们可能根本不知道那条风险线应该画在哪里。

Dario 可能严重高估了 AI 对生物学的推动,Baker 也可能低估能力快速扩散产生的风险。AI 公司会判断错,监管机构同样会判断错。

所以我现在反而觉得,一个好的制度最重要的能力,可能不是第一次就把速度定对,而是能够随着新的证据快速纠错。风险越不可逆,门槛就应该越谨慎;风险越容易验证和回滚,就越没有必要提前阻止。规则本身也应该不断复审,而不是因为今天担心一种风险,就把它永久写进制度。

Anthropic 自己的 Responsible Scaling Policy 从 2023 年推出到现在已经连续修改,2026 年 7 月已经更新到 3.4 版。这至少说明一件事:就连目前最积极讨论 AI Safety 的公司之一,也不认为我们今天已经知道未来所有问题的答案。

Dario 在这场争论里还提到了一件很私人的事情。他的父亲死于丙型肝炎,而几年以后出现的直接作用抗病毒药 Sofosbuvir,可以治愈大约 95% 的患者。他说,如果这种药早几年出现,很可能就能救下自己的父亲。

我觉得这可能也是为什么他会同时表现出两种看起来非常矛盾的态度:一方面极度担忧 AI 的风险,另一方面又对 AI 加速生物医学抱有近乎激进的期待。

我不知道 AI 能不能在五到十年内治愈大多数疾病,我甚至觉得这个时间表很可能过于乐观。但如果未来 AI 确实能够把一些药物和治疗提前几年,那么我们今天讨论 AI 安全时,就必须同时承认另一件事:踩刹车也不是一个零成本的选择。

所以真正需要讨论的,已经不是“AI 应该快一点还是慢一点”。

而是什么应该快,什么应该慢;谁有权让它慢下来,又必须拿出什么证据;如果踩错了油门或者刹车,最后是谁承担代价。

如果 AI 最终没有 Dario 想象得那么强,这些问题可能显得太早。但如果它真的有一天开始接近他所说的那个“数据中心里的天才国家”,到那时再讨论谁有权踩刹车,可能就已经太晚了。