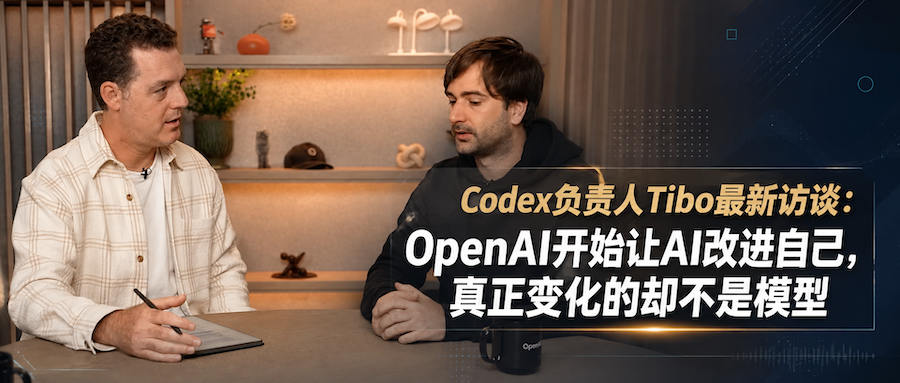
我最近看了 Matthew Berman 对 OpenAI 的 Thibault Sottiaux(Tibo)的一次访谈。里面聊了很多现在大家比较关心的话题,包括 Codex、Ultra Fast、OpenAI 和 Anthropic 的竞争,以及下一代 Agent 会变成什么样。
但真正让我停下来想了一会儿的,是其中一段关于 Recursive Self-Improvement,也就是“递归自我改进”的讨论。
以前看到这个词,我首先想到的也是一个很科幻的场景:GPT-6 开始研究怎么训练 GPT-7,GPT-7 出来以后又自己设计 GPT-8,模型越来越聪明,研发下一代模型的速度也越来越快,最后进入所谓的“智能爆炸”。
按照这个标准,今天显然还没有发生递归自我改进。
但 Tibo 提出了一个我觉得更现实的角度:模型并不是孤立存在的。一个真正能够工作的 AI 系统,除了模型本身,还有训练系统、Inference、CUDA Kernel、Harness、缓存、网络、调度乃至最下面的芯片。
如果今天的模型已经可以帮助工程师改进这些运行 AI 所必需的基础设施,而这些改进又会让下一代模型运行得更快、成本更低,那么它其实已经构成了另一种形式的反馈循环。
我后来去看了一下 OpenAI、Anthropic 和 Google DeepMind 最近公开出来的数据,发现这件事已经不只是一个访谈里的想法。
AI确实开始参与“生产AI”了。
AI已经开始参与自己的开发
今年2月发布 GPT-5.3-Codex 时,OpenAI用了一句非常值得注意的话:这是他们第一款“在自身创建过程中发挥关键作用”的模型。
Codex团队使用GPT-5.3-Codex的早期版本,去调试自己的训练过程、管理部署、分析测试和评估结果。换句话说,在这个模型正式完成以前,一个还没有最终完成的自己,就已经进入了自己的研发流程。
如果事情只到这里,我觉得还不能叫递归自我改进。
因为这和我们今天用Claude Code或者Codex开发一个软件,本质上没有太大区别。人还是提出问题,AI只是把写代码、调试这些工作做得更快。
真正让我觉得这个变化值得关注的,是OpenAI在7月底公布GPT-5.6的推理优化过程。
这次模型做的已经不是普通的软件开发了。
OpenAI披露,GPT-5.6 Sol通过Codex分析真实生产流量,寻找负载不均衡的问题,测试新的路由策略;它还自主重写和优化生产环境里的GPU Kernel。这一系列Kernel优化最终让端到端模型服务成本下降了20%。
更有意思的是 speculative decoding。
现在很多大模型为了提高生成速度,会让一个更小的draft model先预测接下来的Token,再让主模型一次验证多个结果。OpenAI让GPT-5.6 Sol去改进自己的这个draft model。
它自己设计并运行了数百个实验,测试不同的模型大小、结构和特征,还启动并监控训练,在遇到硬件故障和训练不稳定时自行干预。最后,这些优化让Token生成效率提高了超过15%。
这时候事情就开始有点不一样了。
模型正在优化运行模型的系统。
而这个系统变得更快以后,又可以用同样的GPU运行更多推理、做更多实验,下一轮模型研发的成本也随之降低。
真正变化的不是模型,而是AI研发开始出现反馈循环
我觉得理解这件事最重要的一点,是不要只盯着“模型有没有自己训练下一个模型”。
AI不是一个单独的模型文件。
从训练数据、训练框架,到GPU Kernel、Inference Engine、缓存、网络、调度、Agent Harness,再到最下面的芯片,这些东西共同决定了我们最终能以什么成本获得多少“智能”。
所以真正需要观察的是:
更强的模型,能不能帮助改善这一整套生产AI的系统。
如果可以,就会出现这样一个循环:
更强的AI帮助优化训练和推理系统,让同样的算力可以完成更多工作;更高的计算效率又让研发团队能够运行更多实验、降低推理成本;这些效率最终又支撑更强的下一代AI,而新的AI再继续优化这套系统。
OpenAI自己其实也把Inference优化称为一个“continuous feedback loop”。他们会观察真实生产系统、寻找最大的效率缺口、实施改进,再验证改进是不是对整个系统有效,而GPT-5.6和Codex正在加速这个循环里的每一个步骤。
今年6月发布的Jalapeño芯片,把这个循环又往下推进了一层。
这是OpenAI与Broadcom联合开发的第一款自有AI推理芯片。OpenAI称,从初始设计到完成流片只用了9个月,其中模型被直接用于加速一部分芯片设计和优化过程。
OpenAI在介绍这款芯片时甚至直接写了一句话:今天服务用户的同一批模型,正在帮助改进未来用于运行这些模型的基础设施。
这句话其实比“AI自己写代码”重要得多。
因为芯片效率提高以后,会降低未来模型的推理成本;未来更强的模型,又可以继续参与下一代芯片、Kernel和推理系统的优化。
这个循环开始跨越模型、软件和硬件。
这不是OpenAI一家正在发生的事情
如果只有OpenAI自己的案例,我们当然还可以把它理解成一种公司宣传。
但类似的事情也发生在Google DeepMind。
DeepMind去年发布的AlphaEvolve,是一个由Gemini驱动的算法发现Agent。它其中一个实际用途,就是优化Google自己的AI基础设施。
AlphaEvolve重新寻找了一种大型矩阵乘法的计算方式,让Gemini架构里的一个关键Kernel速度提高了23%,最终让Gemini整体训练时间缩短了大约1%。
1%看起来不多,但前沿模型一次训练消耗的计算资源非常巨大,这种百分之一级的改善已经意味着相当可观的算力节省。
在FlashAttention Kernel上,AlphaEvolve最高还获得了32.5%的性能提升。更关键的是,DeepMind明确提到,这些基础设施也被用于训练支撑AlphaEvolve本身的大模型。
也就是:
Gemini驱动AlphaEvolve,AlphaEvolve优化Gemini运行和训练所需要的系统,然后改善后的系统又被用于训练未来的Gemini。
这已经非常接近我理解的“现实版递归”。
不是AI突然坐下来发明一个比自己聪明十倍的新模型,而是它开始一点点改造生产自己的机器。
Anthropic最近甚至直接把这件事写成了一篇题为《When AI builds itself》的文章。
其中一个很有意思的数据是,截至今年5月,Anthropic合入生产代码中超过80%的代码已经由Claude编写。2026年第二季度,典型工程师每天合入的代码量大约是2024年的8倍。当然Anthropic自己也特别提醒,代码行数并不等于真实生产率,8倍显然会高估实际提升。
但更值得看的不是代码数量,而是实验能力。
Anthropic一直会给新Claude做一个测试:给它一段训练小型AI模型的代码,在保持结果正确的情况下,尽可能把训练速度优化到最快。
2025年5月,Claude Opus 4平均可以做到大约3倍加速;到了2026年4月,内部的Mythos Preview已经做到约52倍。Anthropic同样强调,这个数字不能理解成“真实大模型训练速度提高了52倍”,它真正反映的是,在一个目标明确的实验循环里,AI自己修改代码、运行实验、观察结果、继续迭代的能力,在一年里发生了非常大的变化。
但这还不是我们过去说的RSI
写到这里很容易得出一个更刺激的结论:
AI已经实现递归自我改进了。
我觉得目前还不能这么说。
Anthropic自己的表述其实非常克制。他们把完整的Recursive Self-Improvement定义为:一个AI系统能够自主设计并开发自己的继任者,然后新的系统继续重复这个过程。
对于这一点,Anthropic明确说:“We are not there yet。”
今天人仍然在这个循环里扮演非常关键的角色。
模型现在最强的地方,是当人给出一个比较清楚的目标后,它可以越来越独立地完成“怎么做”。
优化哪个Kernel、怎样降低延迟、怎么跑实验、为什么训练失败,这些执行和实验工作越来越适合交给Agent。
但“什么问题值得研究”“哪个方向更有价值”“结果是不是真的可信”,今天仍然大量依赖人的判断。
Anthropic的内部数据其实也说明了这一点。他们认为Claude已经可以在一个明确实验目标下达到甚至超过熟练研究人员,但到了选择研究目标、判断什么问题值得做的时候,能力差距仍然明显。
而且就算AI研发这一段变快十倍,也不意味着整个AI产业可以变快十倍。
芯片要制造,数据中心要建设,电力要接入,训练结果要验证。模型可以一天设计一百个ASIC方案,台积电也不可能第二天把一百块先进制程芯片交出来。
一个环节被加速以后,瓶颈只会转移到另一个环节。
所以我并不认为这些案例能够证明所谓的“智能爆炸”马上就会发生。
真正需要重新理解的,是AI为什么可能越来越快
但反过来,如果我们因为完整RSI还没有出现,就认为这件事完全没有发生,我觉得同样会错过一个很重要的变化。
过去AI进步主要依靠几样东西:更多算力、更好的数据、更大的模型,以及更优秀的研究人员。
现在正在多出一个新的变量:
上一代AI本身,开始成为研发下一代AI的工具。
而且这个工具不是简单提高一个程序员20%的编码效率。它正在进入训练、实验、Inference、Kernel、Harness乃至芯片设计这些真正决定AI成本和研发速度的位置。
这也意味着,以后判断OpenAI、Anthropic、Google之间的差距,可能不能只看下一张Benchmark排行榜。
更值得关注的问题是:
哪家公司能够建立更强的AI研发飞轮?
谁的模型能够帮助研究人员同时跑更多实验,谁能够更快找到GPU里的效率浪费,谁能够让自己的推理系统更便宜,谁又能够把这些经验继续带到下一代模型和芯片里。
这些东西不会像Benchmark那样每隔几个月有一张排行榜。
但它最终可能决定模型为什么会越来越快,也决定一家AI公司可以用同样数量的研究人员和GPU,产生多少新的“智能”。
我们过去讨论递归自我改进,总是在寻找一个很明确的时间点:到底哪一天,AI开始自己改进自己?
现在看下来,我越来越觉得,这个问题可能问错了。
也许根本不会有一个非常戏剧性的“RSI Day”。
它更可能是从这些看起来并不起眼的工程变化开始:AI先帮工程师写代码,然后开始调试自己的训练,再优化运行自己的Kernel和Inference系统,接着参与设计未来运行自己的芯片。
其中任何一步单独拿出来,都谈不上什么“智能爆炸”。
但当这些步骤逐渐连接起来以后,一个新的反馈循环确实已经出现。
今天我们还不能说AI已经能够独立创造下一代AI,但如果想理解接下来AI为什么可能进步得越来越快,真正值得盯住的,已经不只是模型本身,而是AI正在多大程度上参与生产下一代AI。