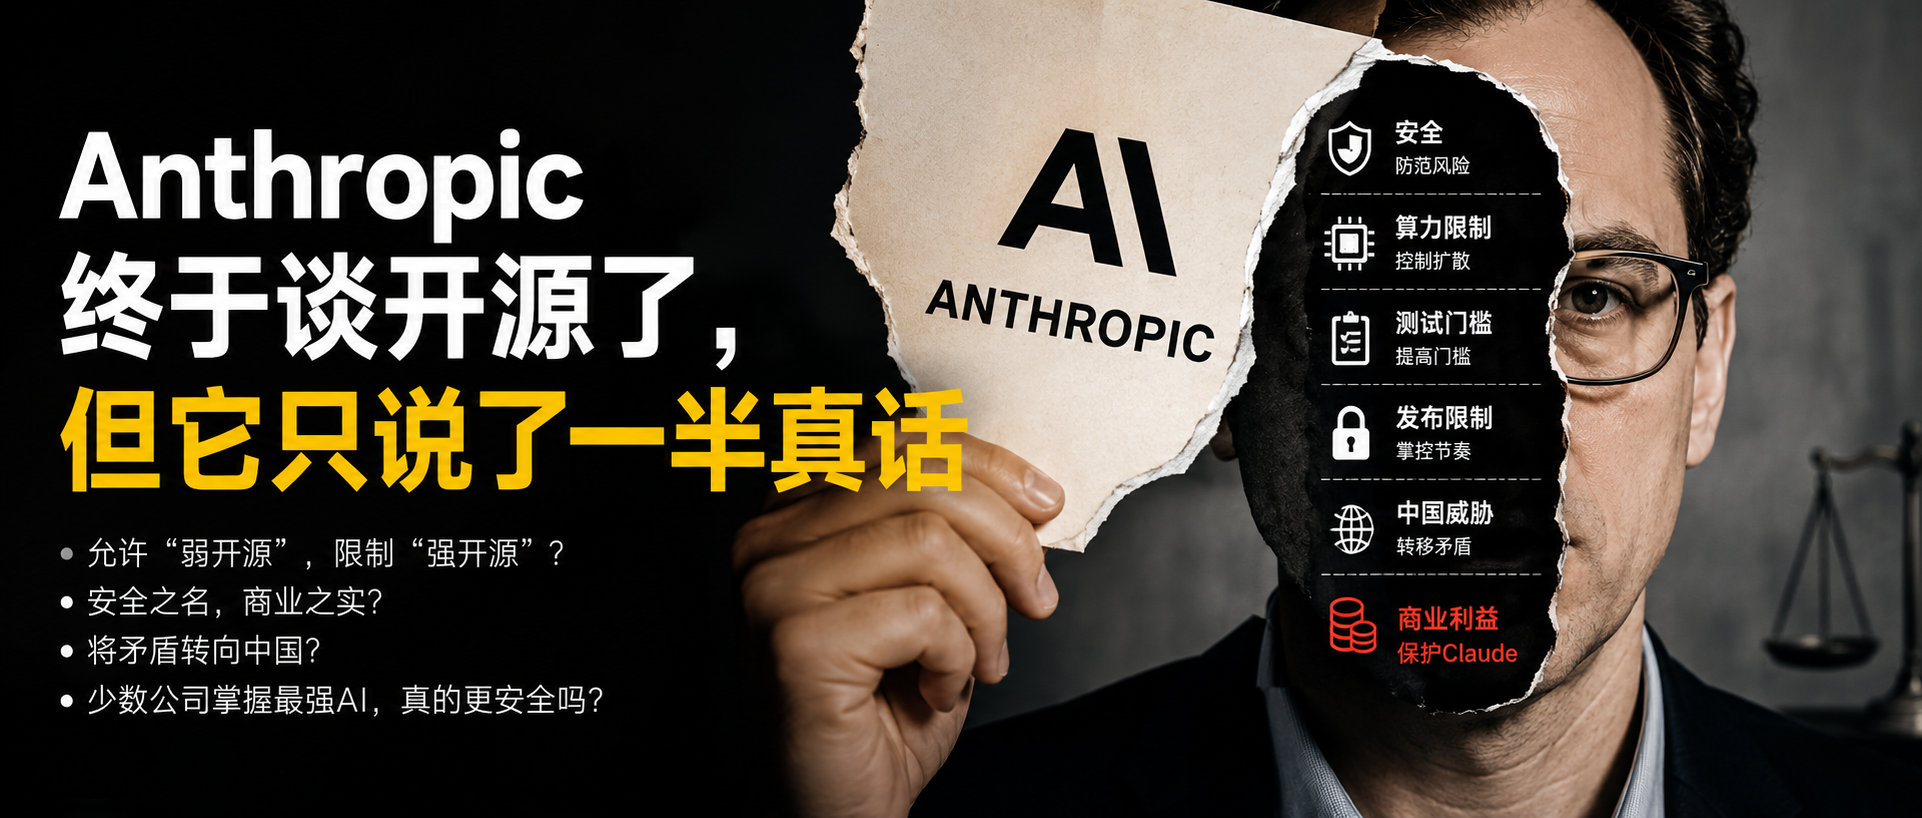
最近,Anthropic专门发布了一份关于开放权重模型的声明,回应外界对其立场的质疑。Dario Amodei在文章中明确表示,Anthropic并不支持全面禁止开放权重模型。对于能力有限、不会带来严重安全风险的模型,开放权重能够促进创新、竞争和用户控制,也可以成为一种有价值的公共产品。
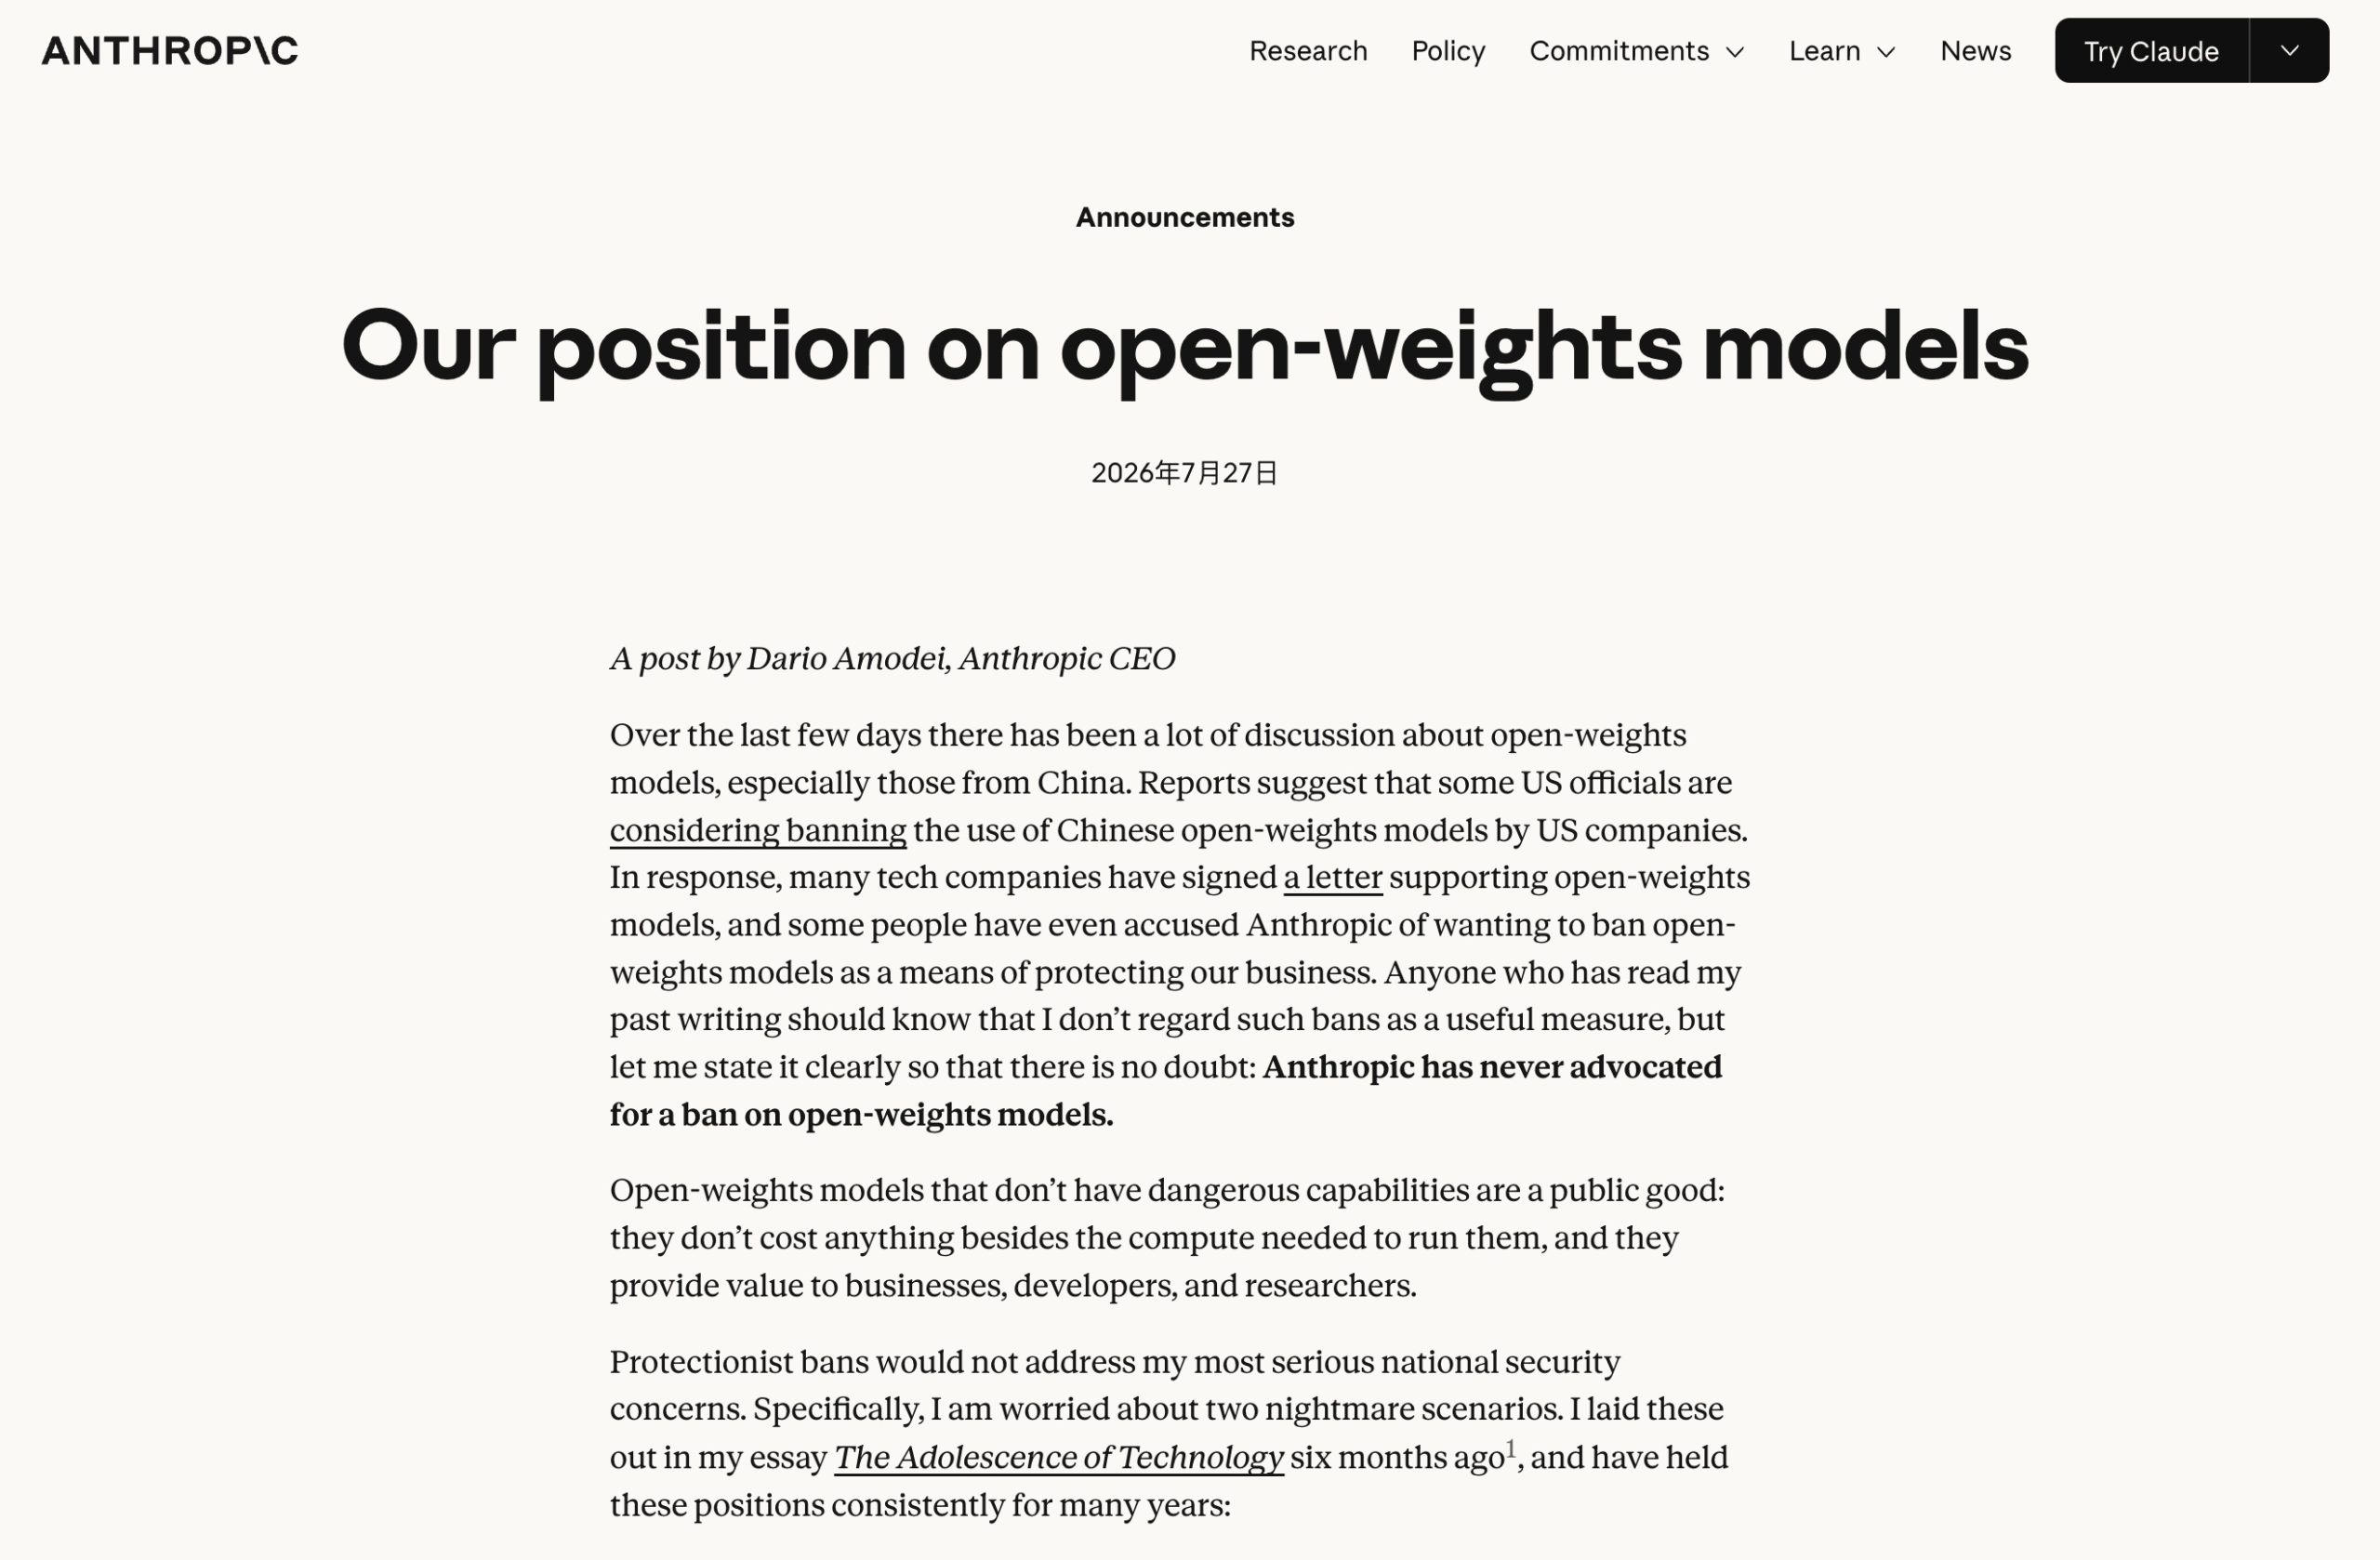
如果只看这些表述,Anthropic似乎终于放下了对开放权重模型的敌意,也愿意承认开放生态的价值。但继续读下去就会发现,它真正改变的只是表达方式,并不是立场本身。
Anthropic可以接受开放权重模型存在,前提是这些模型不能太强。一旦模型能力接近前沿水平,能够在网络攻击、生物研究、自动化执行等领域产生更大影响,它的态度就会迅速改变:模型需要接受强制测试,发布需要设置更高门槛,训练需要受到算力约束,其他国家通过芯片、蒸馏等方式追赶美国模型的路径也应该受到限制。
所以,外界对这份声明最准确的概括是:Anthropic并不反对所有开放权重模型,它只接受能力不太强的开放模型;一旦开放模型接近Claude这样的前沿闭源模型,就应该被严格控制。
这也意味着,Anthropic支持的并不是一种能够真正挑战闭源公司的开放生态,而是一种被限定在安全范围内、也被限定在竞争范围外的开放。开放权重可以作为前沿闭源模型的补充,可以满足研究、教学和部分本地部署需求,却不能成为一种足以改变市场格局的力量。
Anthropic允许开放,但不允许开放模型追上Claude
开放权重模型的价值,并不只是让普通开发者下载一个能力落后两三代的小模型,在自己的电脑上运行一些简单任务。它更重要的意义在于,企业、研究机构和开发者能够获得接近前沿的技术能力,可以独立部署、修改、微调和研究,不必永远依赖少数公司的API,也不必把自己的数据、产品和业务建立在一个随时可能涨价、限额或者改变规则的平台上。
如果最强大的模型永远不能开放,开放生态就很难形成真正的技术竞争。它可以很热闹,可以拥有大量模型、工具和社区项目,但整个行业最核心的能力依然掌握在少数闭源公司手中。开放模型只能跟随闭源模型已经探索过的路线,使用前沿公司允许它拥有的能力,很难真正影响技术发展的方向。
Anthropic的立场恰恰停留在这里。它承认开放权重有价值,却没有准备接受开放模型成为真正的前沿模型。性能不够高时,开放可以促进创新;性能达到前沿水平后,同样的开放就开始被描述为不可逆的安全风险。
这种边界看起来是按照能力和风险划分的,但它同时也划出了一条非常清晰的商业边界:开放模型可以存在,却不能威胁Claude的护城河;可以服务长尾市场,却不能动摇头部闭源公司的定价权;可以成为一种公共产品,却不能成为一种足以重新分配市场利益的竞争产品。
所以,Anthropic真正反对的并不是开放权重这种技术形式,而是前沿能力脱离自己的控制。它担心的也不只是危险模型被滥用,还包括越来越多的开发者和企业不再需要Claude。
安全风险是真实的,但Anthropic不是中立的裁判
必须承认,Anthropic所强调的一些风险并非完全虚构。模型权重一旦发布,确实很难撤回,原有的安全限制也可能被删除。与只能通过API访问的闭源模型相比,开放权重模型能够在私人设备和服务器上运行,模型开发者很难监控它的具体用途。当模型具备更强的网络攻击、生物研究和自动执行能力时,开放发布确实可能带来新的风险。
但承认风险存在,并不意味着必须接受Anthropic给出的解决方案,更不意味着Anthropic天然有资格定义什么是危险、什么样的模型可以发布。
Anthropic首先是一家商业公司,而且是全球最重要的闭源模型公司之一。它依靠模型能力、API调用和订阅服务获得收入,开放权重模型则是其最直接的竞争者。当一家市场参与者开始推动规则,决定竞争对手能够发展到什么程度时,它就不再只是一个单纯的安全倡议者。
更严格的测试要求、更高的合规成本和更复杂的发布审批,对Anthropic这样的公司并不是太大的负担。它拥有资金、算力、研究人员和成熟的安全团队,也有足够的资源参与政策制定。真正会受到影响的,往往是规模较小的模型公司、研究机构和开放社区。它们需要承担同样的测试和合规要求,却没有同等的资源。
限制前沿模型开放,也会直接保护闭源公司的商业模式。只要最强能力仍然只能通过API获得,企业就必须持续向少数模型公司付费,开发者也很难真正掌握底层能力。模型公司不仅拥有技术优势,还拥有定价权、数据入口和生态控制权。
这并不意味着Anthropic讨论安全时一定是在撒谎。更可能的情况是,安全风险与商业利益在这里高度重合。它相信自己的安全判断,同时也从这些判断所推动的监管规则中获益。
安全是一种非常有力量的语言。当一家企业说自己想保护市场份额时,人们会保持警惕;当它说自己正在保护人类时,商业竞争就获得了道德上的正当性。保护自身利益不再被描述为维护护城河,而变成了防止灾难发生。
Anthropic的问题并不是它不应该讨论风险,而是它选择性地放大了开放扩散的风险,却很少讨论封闭垄断和技术权力集中本身可能产生的风险。
从开放权重到中国威胁,矛盾被悄悄转移了
在这份声明中,Anthropic用了相当大的篇幅讨论中国。它认为,美国应该继续限制高端芯片和芯片制造设备出口,打击大规模模型蒸馏,避免中国利用美国闭源模型的能力,以更低成本训练出接近前沿水平的模型。
这里当然存在真实的国家竞争。美国不希望中国率先获得更先进的人工智能能力,中国也不可能放弃发展自己的模型。芯片、算力、模型和人才已经成为中美科技竞争的重要部分,这并不令人意外。
但“美国是否应该限制中国获得先进AI能力”,与“接近前沿的开放权重模型是否应该受到普遍限制”,本来是两个不同的问题。Anthropic却把它们放进了同一套叙事中。
原本的争议是,为什么美国的前沿模型公司不愿意开放权重,为什么Anthropic要推动更严格的发布门槛,为什么闭源公司有资格决定开放模型可以发展到什么程度。经过这份声明的重新包装,问题逐渐变成了:美国是否应该帮助中国发展AI,中国公司是否正在利用美国模型进行蒸馏,以及开放模型是否会增强威权国家的技术能力。
这样一来,关于商业竞争和技术开放的争论,就被转换成了一个国家安全问题。质疑Anthropic对开放模型的限制,似乎也容易被解释为忽视中国AI带来的威胁。
然而,中国开放权重模型能够在全球获得影响力,并不只是因为它们来自中国,也不是因为各国开发者对中国公司有特殊偏好,而是因为它们提供了美国闭源公司不愿意提供的东西:更低的成本、更自由的部署方式,以及对模型权重和数据的实际控制。
当美国公司把最强模型全部封闭在自己的平台内,而中国公司愿意开放权重时,全球开发者自然会作出选择。这首先是一种产品和生态竞争,然后才是国家之间的技术竞争。
如果美国希望自己的模型继续成为全球AI生态的基础,真正应该做的并不只是限制芯片、限制蒸馏或者提高其他模型的发布门槛,而是提供更有竞争力的开放模型。一个开放生态最终依靠的不是行政保护,而是有没有足够多的人愿意使用、部署和改进它。
Anthropic却选择了另一条路线:当开放模型来自美国时,它强调能力扩散的风险;当开放模型来自中国时,它又增加国家安全的风险。两种叙事最后都指向同一个结论——最强大的模型不应该开放,前沿能力应该继续掌握在少数美国闭源公司手中。
表面上是自信,骨子里还是自大和傲慢
我之前写Anthropic时,曾经提到过一个感受:这家公司给人的印象并不只是自信,而是一种建立在技术优势上的自大和傲慢。
Anthropic相信自己对AI风险的理解比其他公司更深,相信自己的安全研究更加成熟,也相信自己拥有比开放社区、其他国家和普通开发者更强的判断能力。这种自信并不难理解,它确实聚集了大量优秀的研究人员,也在模型能力和安全研究方面投入了很多资源。
但这种自信继续向前走一步,就会变成另外一种东西:因为我们最了解AI,所以应该由我们决定谁能够使用它;因为我们建立了安全体系,所以最强模型掌握在我们手中是安全的;因为其他人可能滥用技术,所以他们只应该获得被限制过的能力。
这里真正傲慢的地方,并不是Anthropic认为AI有风险,而是它似乎天然认为自己属于“正确的人”,其他人则需要不断证明自己不会成为风险。
它担心开放权重模型落入恶意攻击者、极端组织或者威权政府手中,却很少认真讨论另一个问题:如果作出错误决定的,恰恰是掌握最强模型的公司和少数高管呢?
闭源不会自动让一个组织变得善良,技术领先也不意味着其判断永远正确。一家公司可能在商业压力下忽视安全问题,可能为了维持竞争优势夸大外部威胁,也可能与政府、军事和情报机构展开外界无法审查的合作。模型没有开放权重,并不代表它不会被滥用,只是相关决策发生在更加封闭的系统中,普通人更难了解和监督。
Anthropic所构想的秩序,是少数公司掌握最强模型,同时由这些公司参与制定安全规则,判断其他模型是否可以发布。技术能力、商业利益和规则制定权集中在同一批人手中,却被默认成了更加安全的状态。
但集中并不会自动带来安全。恰恰相反,当最强模型、最大算力、最多用户数据和规则制定能力同时聚集到少数公司手中,整个行业也会形成新的单点风险。企业内部的一次判断失误、一次利益冲突或者一次政策转向,都可能影响大量开发者、企业和普通用户,而外部社会却很难及时发现,更难纠正。
开放会产生扩散风险,封闭同样会产生权力集中的风险。两者都需要监管,不能因为集中在一家拥有安全团队的公司内部,就默认后一种风险不存在。
真正需要监管的,不只是模型,还有掌握模型的人
我并不认为所有模型都应该毫无条件地开放,也不认为前沿模型的安全风险可以被忽略。随着模型能力继续提升,一些测试、评估和发布规范是必要的,尤其是涉及网络攻击、生物风险和自主执行能力时。
但这些规则必须同时适用于开放模型和闭源模型,而且不能主要由最大的闭源公司来定义。
如果开放模型需要接受独立安全评估,Anthropic、OpenAI和Google的闭源模型同样应该接受外部审计;如果开放模型的开发者需要证明模型不会被滥用,闭源公司也应该解释自己的模型如何被政府、军方和大型企业使用;如果监管机构担心危险能力扩散,也应该担心能力、算力和决策权被永久集中在几家公司手中。
真正公平的规则,不能要求开放模型证明自己绝对安全,却允许闭源公司依靠一份内部安全报告证明自己足够负责。测试标准应该公开,评估机构应该独立,监管过程也应该尽可能避免被头部公司主导。
更重要的是,监管的对象不能只有模型能力,还应该包括掌握模型的人和组织。越强大的模型公司,越应该承担更高的透明度和外部监督要求,而不是因为它拥有最专业的安全团队,就自动获得更多权力。
AI安全不应该成为一种只约束后来者和竞争者的制度。它应该同时约束开放社区、闭源公司、政府机构,以及所有有能力把模型接入现实世界的人。
Anthropic真正想守住的,是定义AI边界的权力
Anthropic这次的声明,确实澄清了一件事:它并不反对所有开放权重模型。以后再简单地说Anthropic想全面禁止开源,并不准确。
但这份声明也让它真正的立场变得更加清楚。Anthropic可以接受开放,但不能接受开放模型接近前沿;可以接受竞争,但不能接受竞争者获得同等能力;可以讨论公共产品,却不愿意放弃自己对最强模型的控制。
它用安全解释这种限制,用中国威胁强化这种限制,又用自身的技术专业性证明自己有资格制定限制。
归根到底,Anthropic争夺的不只是Claude的市场份额,也不只是美国AI公司的领先地位,而是定义AI边界的权力:什么样的模型算危险,谁可以训练最强模型,谁能够获得模型权重,以及整个社会可以使用多强的AI。
但AI未来最危险的局面,未必是强大的模型被太多人掌握,也可能是全世界最强大的模型只掌握在几家公司、几个高管和少数政府机构手中。
Anthropic一直担心危险能力落入错误的人手中,却很少反思一个更基本的问题:它为什么天然认为,自己就是那个正确的人?
这或许才是Anthropic真正让人不安的地方。