Table of Contents
2026 年 2 月,Meta 超级智能实验室(MSL)内部流行起一种颇为诡异的实验。
负责 AI 产品的 Nat Friedman 是团队里第一个深度使用开源个人 Agent 项目 OpenClaw 的人。他在家里给这个 Agent 开放了极高的系统权限,告诉它自己想多喝水;随后,OpenClaw 开始主动调取他家里的安防监控画面,盯着他手里的水杯,每次看到他喝水就发消息夸他干得好。
紧接着,Nat Friedman 写了一套包含多轮深度心理追问的提示词,发给坐在一旁的实验室负责人 Alexandr Wang。
Alexandr Wang 在自己的电脑上装好 OpenClaw,授权它读取个人邮件、相册和历史资料,跑完了那套提示词。他在近期与 David Senra 的深度访谈中回忆,那次与 Agent 的深度交锋让他彻底卸下防备,带来的冲击相当于把整整三年的心理治疗压缩到了同一个瞬间。
在那个阶段,整个团队都沉浸在一一种介于恐惧与狂喜之间的复杂情绪里。扎克伯格甚至把自己的综合格斗(MMA)训练视频喂给 Agent,让它在回合间隙挑毛病、给技术改进建议。
写过不少自动化脚本和 Agent 工作流的人,大抵都能理解那种兴奋感。当大模型第一次跨过对话框,真正接管外部工具并替你完成一件现实任务时,那种体验确实像魔法一样迷人。
但吊诡的事情很快发生了。
曾经让硅谷极客圈彻夜难眠的 OpenClaw 浪潮,在冲上波峰后迅速消退,普通用户几乎全数流失。而在同一时期用两周时间敲出产品原型的 Meta 团队,却做了一个反直觉的决定:按住不发,在外界的质疑声中闷头改了整整七个月,直到九月份才正式推出消费级个人 Agent 应用 Muse,并迅速刷新了消费级 AI 应用的增长纪录。
同样是做个人 Agent,为什么极客圈奉为圭臬的先行者沦为了昙花一现的玩具,而看似笨拙的慢功夫却跑出了真正的国民级应用?
拆解 Alexandr Wang 在访谈中披露的内部研发细节,我发现答案并不在某个神秘的底层算法突破里,而藏在极其枯燥的工程控制与高度克制的组织纪律之中。
偶发的魔法撑不起日活,大模型的非确定性正把早期 Agent 推向留存悬崖
在传统软件工程里,我们习惯了确定性的逻辑:输入 A,经过确定的函数处理,必然得到输出 B。
但大模型驱动的 Agent 天生带有非确定性的基因。
很多跟风做 Agent 的团队没有意识到,从聊天机器人(Chatbot)跨越到智能体(Agent),用户的容忍度模型发生了根本性的逆转。
用户拿 Chatbot 当搜索引擎或陪聊工具时,模型偶尔胡说八道两句,用户笑一笑也就划过去了,试错成本几乎为零。一旦用户把真实生活或工作里的任务交给 Agent 代办,它就站到了 Alexandr Wang 所说的“刀锋边缘”上。
这就是 OpenClaw 以及大批 Agent 产品迅速退潮的病根所在。
它们能在某两次调用中展现出令人拍案叫绝的灵光,但在其余八次日常任务里,却会因为上下文丢失、工具调用超时或边界条件判断失误而频频报错。只要用户在十次体验里撞上两次莫名其妙的崩溃,大脑就会立刻给这个产品贴上“不可靠”的标签,随后彻底卸载离开。
真正的消费级 Agent 留存,建立在一个被称为“信任坠落(Trust Fall)”的心理演进机制之上。
没有任何一个正常用户会在下载应用的第一天,就把自己的核心日程和信用卡交给 AI。用户总是先试探性地交办一件无关痛痒的小事,看到它稳稳接住之后,再试着托付一件稍微复杂点的任务。
访谈中有一个让我印象很深的真实例子。David Senra 的一位掌管着千亿美金市值公司的朋友,把身份证件落在了私人飞机上。这位老板打开 Muse,只丢下一句“我不想参与中间任何环节,你把证件弄回我办公室”,Muse 就自己去协调航班、安排同城闪送、搞定写字楼底层的安保登记,最终把证件送到了他的办公桌上。
这种彻底放手的托付,正是无数次微小交付零失误积累出来的终点。
在软件工程视角下,偶发的惊艳只够用来拍一条融资演示视频;只有把交付成功率从 80% 死磕到 99% 以上,信任的飞轮才转得起来。
把非确定性模型关进确定性笼子,靠的是一张百项指标表的枯燥打磨
看清了“信任坠落”的前提,就能理解为什么 Meta 敢于顶着巨大的外部压力,花七个月时间去打磨一个两周就跑通了的原型。
在 AI 行业,七个月的体感时间几乎等同于传统互联网时代的十年。
那段时间,Anthropic 的 Claude 正在编程赛道上一骑绝尘,全硅谷的创业者和巨头都在扎堆往 Coding Agent 里挤;华尔街则日复一日地唱衰 Meta,认为扎克伯格在 AI 上烧掉的百亿美金正在打水漂。
面对内外交困的焦虑,Alexandr Wang 和团队选择了一条最不性感的路:用砂纸一寸寸打磨细节。
作为常年和系统稳定性打交道的技术人,我非常欣赏 MSL 团队把“玄学体验”拆解为“工程指标”的做法。
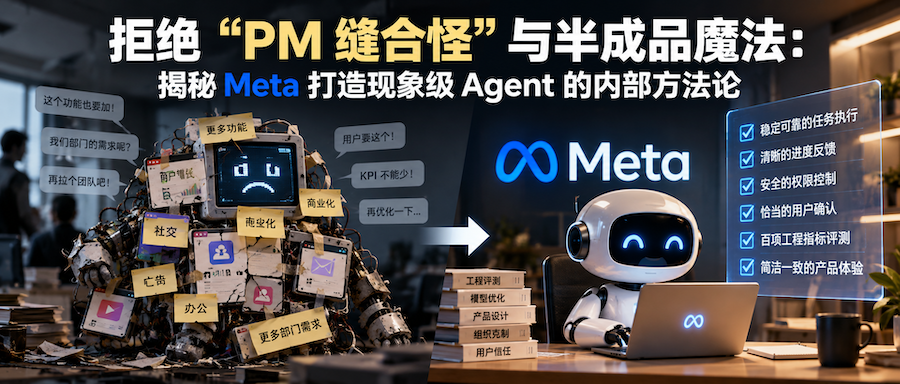
他们没有去盲目刷通用的学术公开榜单,而是拉出了一张巨大的电子表格,把一个理想个人 Agent 需要具备的能力,细化拆解成了 100 多项极其具体的行为指标。
比如,模型在执行长链条任务时的稳定度如何,执行过程中如何向用户清晰同步进展,遇到权限不足或信息模糊的边界情况时,能不能在恰当的时机停下来向用户回问确认,而不会自作主张地乱捅娄子。
针对表格里的每一行,工程与研究团队都编写了专门的自动化评估集(Evals),并以此为靶心对底层模型进行定向的后训练与强化。
在漫长的打磨周期里,团队每周的例会就是对着这张百项指标表逐行过堂,找出亮红灯的短板,回去改数据、调权重、重跑 AB 测试。
他们为每一行指标都设定了严格的“上线阻断阈值”。在很长一段时间里,模型检查点能在其中 80 项上亮绿灯,但剩下的 20 项依然飘红。
换成一家急于向资本市场交差的普通大厂,80% 的达成率早就足够开一场盛大的新品发布会了。但 MSL 硬是压住没发,直到专门针对产品深度特训的版本在所有指标上实现全绿通关,他们才真正推向市场。
这种把底层模型研发与上层产品体验深度咬合、用确定性的工程标尺去收敛模型发散性的笨功夫,才是 Muse 能够接住亿万普通人日常琐碎需求的真正底座。
警惕大厂的“PM 缝合怪”,伟大的消费品必须守住单一的灵魂视角
如果仅仅把 Muse 的成功归结为算力充足与工程评测,还只看到了硬币的一面。
行业里从不缺资金雄厚、工程师成群的科技巨头,但过去两年大厂端出来的 AI 消费品,十有八九都长得像面目模糊、极其难用的四不像。
Alexandr Wang 在访谈中一针见血地指出了大厂做产品的通病:柯南伯格式的缝合怪,也就是俗称的“产品经理地狱”。
在大公司里,一旦某个项目被列为年度最高优先级,组织规模就会迅速膨胀。几十个不同部门的产品经理蜂拥而至,每个人背着不同的 KPI,每个人都想把自己的观点和自留地功能硬塞进同一个应用里。
最后交付给用户的东西,就像一杯把所有食材倒进搅拌机打出来的浑浊奶昔。用户或许说不出你们内部的组织架构到底出了什么问题,但用户在打开界面的第一秒,就能本能地察觉到这种割裂与拧巴。
为了避开这个大厂陷阱,Meta 在组织上展现出了罕见的克制。
尽管整个高管团队都清楚 Muse 是决定公司当年 AI 翻身仗的核心产品,但从底层模型调优到上层应用开发,整个项目的总人数被严格锁定在 200 人以内。
在拥有数万名员工的庞大帝国里,刻意维持一个不到 200 人的扁平特种部队,核心目的只有一个:把产品当成一件不可分割的“单一艺术品”来雕琢。
就像早年的苹果产品是乔布斯个人审美的延伸一样,Muse 从立项第一天起,就确立了以 Nat Friedman 的产品品味和直觉作为唯一准绳。
在早期的内部备忘录中,Nat 就定下了产品的核心基调;从首版原型里的吉祥物到极简的交互框架,自始至终都由同一个清晰的视角一以贯之,没有向任何冗余的部门诉求妥协。
甚至连研究团队的汇报关系,都被设计成了彻底反官僚的结构:超过 200 名核心研究人员跳过繁琐的中间层级,直接向 Alexandr Wang 汇报,内部只按技术方向划分灵活的 Pod 小组,由技术负责人直接拍板技术分歧。
砍掉中间层级的传声筒,堵死多头 PM 塞私货的通道,才让那张“百项指标表”的工程打磨没有在部门扯皮中走形。
AI 下半场的胜负,都在看不见的枯燥之处见分晓
回看这场关于个人 Agent 的分野,其实给所有身处技术与产品一线的从业者敲响了一记警钟。
前两年,底层模型能力每几个月翻一番,造就了一种虚幻的行业浮躁。许多人误以为,只要拿最新的 API 套个漂亮的前端壳子,用最短时间抢发一个能跑通 Demo 的产品,就能轻松收割市场。
但 Meta 哪怕手握每天数十亿活跃用户的分发基本盘,依然清楚地知道,渠道能力救不了一个体验脆弱的半成品。
当全行业都在跟风追逐编码工具、或者在发布会上比拼参数噱头时,真正决定终局的战场已经悄然转移到了枯燥的深水区。
未来的 AI 产品竞争,拼的是团队有没有定力把发散的模型能力拆解成上百个严苛的工程约束,拼的是组织有没有魄力砍掉臃肿的汇报层级、守住纯粹的产品审美。
魔法时刻只负责把用户吸引进门;唯有把每一处不起眼的毛刺都磨平的笨功夫,才能让用户放心地完成那次向后的“信任坠落”。
拒绝“PM 缝合怪”与半成品魔法:揭秘 Meta 打造现象级 Agent 的内部方法论 Share on X