Table of Contents
今天凌晨,Gemini 应用里默认的「日常帮助」换了底层模型,谷歌搜索也跟着换,开发者后台多了一个新名字:Gemini 4 Hydrogen。官方博客把定位写得很直白,它是给 Gemini 3.8 Flash 用户准备的升级对象——在默认的 high 思考档下完成任务比 3.8 Flash 快 2.5 倍,Terminal-Bench 4.1 的分数从 18.2% 提到 57%,胡编的比例降了五倍以上。中文科技媒体的标题几乎都抓住了另外三个字:全员免费。
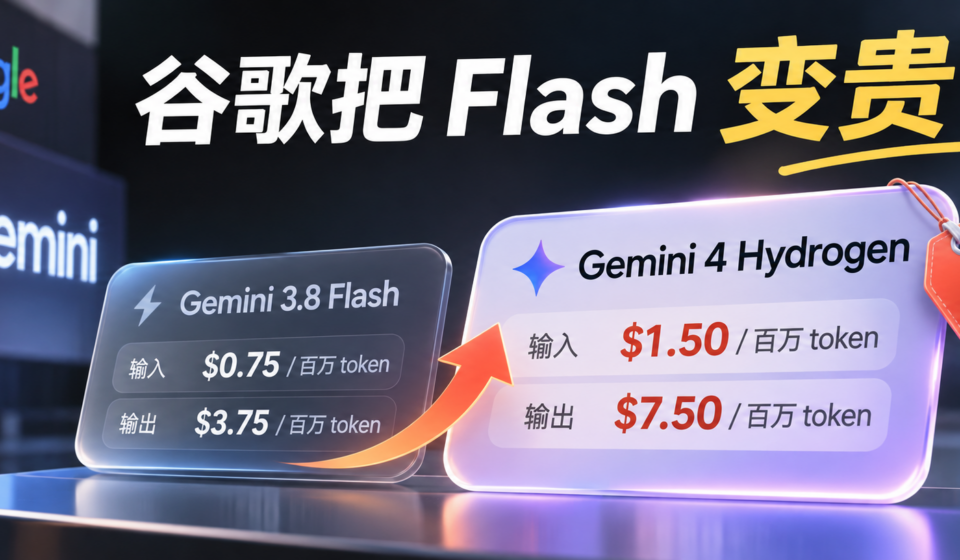
我顺手把两个模型的价格页并排打开,看到另一行几乎没人引用的数字:Hydrogen 每百万 token 输入 1.50 美元、输出 7.50 美元;3.8 Flash 现在是 0.75 和 3.75,2027 年 1 月 1 日起变成 1.50 和 7.50。
一分不差。
智力这一项,谷歌没有虚张声势
先说清楚能力。3.8 Flash 是九月初发布的,当时的定位是「最强 Flash」,在 Artificial Analysis 的智能指数上拿 31 分,78 个模型里排第 54。Hydrogen 默认档 51 分,第 21;开到新加的 xhigh 档是 54 分,第 16。两个月涨 20 分,在同一个指数上是很少见的跨度。
更有意思的是家族内部的位置:谷歌自己说 51 分已经超过 Gemini 4 Argon 的 50 分。Argon 是这一代的旗舰之一,输入价 2 美元、输出 10 美元,比 Hydrogen 贵三分之一。一个按「日常执行」定位的中杯模型,在综合分上追平甚至超过自家旗舰,这是这轮发布里最容易被标题盖过去的事实。
第三方也给了一致的信号。Cursor 的编程榜 CursorBench 4.0 上,Hydrogen 的 High 档 54.3%,每任务 5.59 美元;自家旗舰 Carbon High 60.4%,9.22 美元。差 6 分,价格六折。所以能力这一项的结论可以放心:提升是真的,不是挑着跑分挑出来的。
价格页上那行没人引用的小字
真正需要停下来看的是价格结构,而且 Hydrogen 并不是孤例。价格页上,Carbon 和 Argon 现在都是输入 2 美元、输出 10 美元,11 月 30 日之后变成 4 和 20;3.8 Flash 在 12 月 31 日之后从 0.75/3.75 变成 1.50/7.50。也就是说,2026 年底是 Gemini 全系的一次调价窗口,Hydrogen 的所谓「新定价」,其实就是把明年 1 月 1 日的 Flash 价格提前用在了今天的新模型上。
这么看,「更聪明、更快、更便宜」这句话里,第三项是站不住的——至少按 token 单价算,它比今天的 3.8 Flash 贵一倍。谷歌没有明说的部分,是把「便宜」这个词拆开、挪到了别处:一处是四档思考里的低档,另一处是仍在售的 3.5 Flash-Lite,那才是官方价目表上最便宜的位置。
这里有个常被忽略的商业约束。Hydrogen 的 51 分已经和 Argon 的 50 分平起平坐,可 Argon 卖 2 美元和 10 美元。如果 Hydrogen 真按 3.8 Flash 的 0.75 美元卖,家族内部的价格秩序当场崩掉:同样的分数、三分之一的价钱,没人有理由再为 Argon 付钱。所以它的定价不只是「算力成本涨了」的结果,也是产品线自己划出来的底线——一个模型能便宜到什么程度,先取决于它上面还压着谁。这条推不出谷歌的财务动机,但足以解释为什么「更聪明的模型卖得更贵」在这一代是必然而不是意外。
免费层也值得一提。Hydrogen 确实在 AI Studio 和 API 免费层里可以直接用,是 Gemini 4 家族第一个进免费层的模型,Carbon 和 Argon 的免费层栏位都写着 Not available。但同一张表上还有一行:免费层「用于改进我们的产品:是」。付费层是「否」。所以「全员免费」不是单纯的让利,它是一次用数据换算力的交换,只不过这条写在价格页,不写在发布会里。
「快 2.5 倍」成立,但和你以为的不是同一件事
官方的 2.5 倍,口径是「在默认 high 档完成任务」。AA 测同一个档位,得到的是每任务 8.3 分钟对 14.7 分钟,大约 1.8 倍;输出速度 170 对 112 tok/s;首字延迟 18.89 秒对 17.53 秒,基本没变,甚至还慢了一点。
1.8 和 2.5 的差距不奇怪。官方那套数字建立在 Terminal-Bench 4.1 上,成功率从 18.2% 跳到 57% 之后,任务集合里「失败的短任务」大量被「成功的长任务」替换掉,平均耗时的结构已经变了;AA 用的是固定的一套评测任务,比的是同一批题。两个数字都对,只是回答的不是同一个问题。
真正解释「快」的,是另一组数:跑完整套评测,3.8 Flash 读了 102 亿输入 token,Hydrogen 只读了 53 亿。它快,主要不是因为算得更快,而是因为读得更少、试错更少、来回更少。谷歌说的并行批量读文件、工具调用失败后能换路线、缺上下文就明说而不是猜,落到实处就是这两件事:少读一遍,少改一版。这也是「捏造陈述减少五倍」和「快」在工程上其实是同一件事的原因——模型少猜,就不用你回头纠正。
顺带说一个我没写进结论的数字。AA 给了单任务成本:3.8 Flash 7.77 美元,Hydrogen 1.87 美元,差四倍多。可把两边的 token 单价和用量代进去,怎么算都凑不出这个差距,缓存命中率的假设显然不一致。所以这条我不引用,「单任务成本只有四分之一」这种话看着漂亮,口径不清的时候很容易变成另一种跑分。
价签正在从 token 换成任务
Hydrogen 这一代真正的新东西不是模型,是定价方式。
四档思考把同一个模型切成四个价签。Cursor 榜上写得最清楚:High 档 54.3%、每任务 5.59 美元;Medium 档 46.7%、1.76 美元;Low 档 27.9%、0.28 美元。同一个模型,最低档比最高档便宜二十倍,能力掉一半。对开发者来说,这意味着一件事:以后不能问「这个模型多少钱」,只能问「我这类任务用哪一档、多少钱一题、错了重来一次多贵」。
配合同一天上线的 Orchestrator 更明显。它在同一个会话里自动在 Carbon 和 Hydrogen 之间切换,难的交给 Carbon,改代码、跑测试、验证交给 Hydrogen。谷歌在 Terminal-Bench 4.0 上给出的结果是:成功率和全程只用 Carbon 差不多,额度少用 24%,速度快 19%。模型选择这件事,从「人来挑」变成了「产品替你挑」。
还有一个细节让档位选择和成本直接绑在一起:Gemini 的输出价格是含思考 token 的,也就是说,模型多想的那部分,按 7.50 美元一百万 token 计费。这跟上一代 Flash 的体验差别很大——过去你几乎不用管模型在心里绕了多少圈,现在同一道题开 Low 和开 xhigh,账单可能差二十倍,答案的差别却只在难任务上看得出来。
这才是这轮发布里我认为最值得记下来的变化。过去两年,大家比的是「同样的钱买到多少智能」;现在谷歌把问题换成了「同样的任务花多少钱、多快做完」。计价单位从 token 挪到任务,单价上涨就不必然是成本上涨,反过来也一样。
它没赢的地方,也是它不该被派去的地方
要防止把上面这些读成「全面换代」。官方那十项对比里它输了三项,两项是终端任务,一项是电脑操作;AA 的终端类评测上,它也没有赢过 Claude Sonnet 5.5;Cognition 的 FrontierCode 2.0 上,它略低于 GPT-6.1 Sol。这些都是长链路、多步骤、需要现场判断的活,正好是 Carbon 和 Argon 的位置。还有一个版本陷阱:官方用来展示进步的是 Terminal-Bench 4.1,第三方评测跑的是 4.0,两个版本的难度和任务构成都不同,把 57% 和 54% 放在一起讨论是没有意义的。
所以它的正确用法是执行和验证,不是架构判断。同样,它也不该被拿去替代 Flash-Lite 做高频短调用——那类请求本来一次就答完,不需要思考档位,单价翻倍只会体现在账单上,不会体现在结果里。
唯一算得上「贵得有理由」的是安全那一组数:谷歌说它在智能体任务里的越权操作减少 81%、服务不足减少 79%、在内部诚实度评测上达到 96.7%。这些指标不好看、也不好传播,但对把模型放进生产环境跑自动化的人来说,比多考几分实在。
回到那两行价格
对普通用户,这就是一次免费拿到的能力升级:Gemini 应用和搜索里的日常回答确实变强了,代价写在价格页的数据条款里。对开发者,这是一次价格锚点的上移,也是一次计价单位的更换。
所以真正该问的不是「Hydrogen 比 3.8 Flash 强多少」,而是「我的调用属于哪一类」。一次做对的复杂任务、需要读很多文件还要自己验证的活,迁过去大概率省钱,因为它少读一遍、少改一版;海量短请求、分类、路由,留在低档或者 Flash-Lite 就行。
谷歌这次没有让智能变便宜,它把「便宜」重新分配了一遍:能力往上走,单价往上抬,省下来的部分交给你在选择档位和编排时自己挣。至于能挣回多少,取决于你的账是按 token 记的,还是按任务记的。
谷歌把 Flash 变贵了,Gemini 4 Hydrogen 与 3.8 Flash 之间那道价签 Share on X