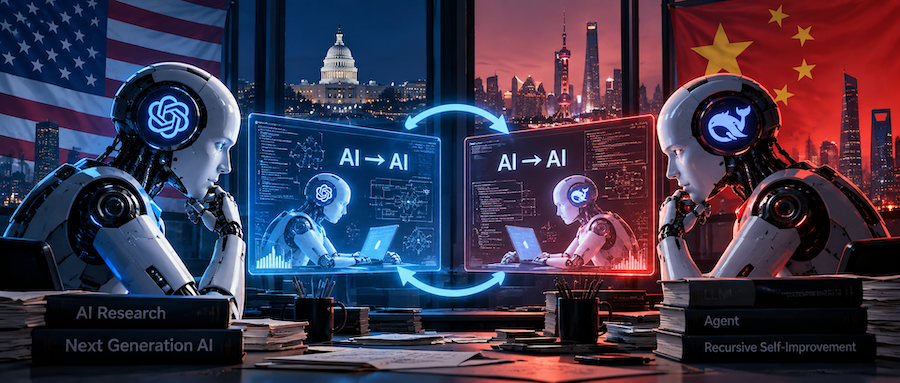
中美AI竞争真正的胜负手,不是谁的模型更强,而是谁先让AI研究AI
中美AI竞争正在从模型能力转向研发速度。AI已开始参与下一代AI的研发,但完整RSI尚未实现。真正的胜负,不只是谁先让AI研究AI,更是谁能把这种技术加速度转化为产业生产率和经济增长。
99%的代码都由AI写了,那程序员真正值钱的是什么?
当99%的代码都由AI编写后,我反而更清楚地看到:程序员的价值正在从“写代码”转向理解业务、掌握系统、判断问题和调度AI。代码越来越便宜,但能看懂复杂系统、快速定位故障并为结果负责的人,仍然稀缺。
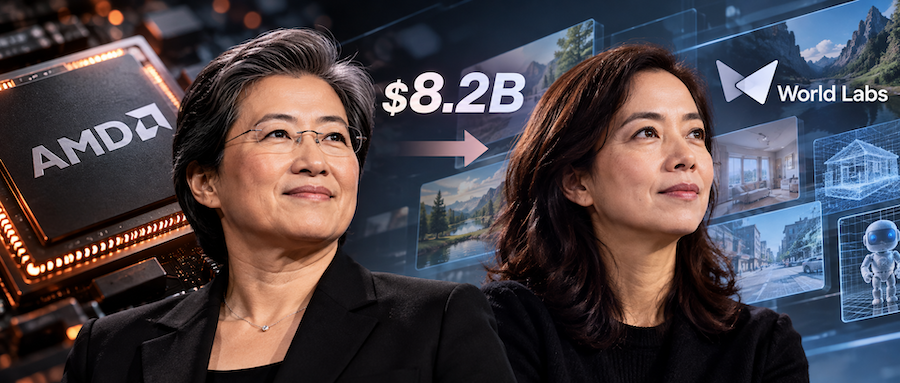
苏姿丰花82亿美元请来李飞飞,AMD真正缺的可能不是更快的GPU
AMD花82亿美元收购World Labs,价值不只在World Model本身,更在于把前沿模型研发接入芯片设计闭环。当AI工作负载快速变化,未来芯片竞争除了性能,还取决于谁能更早看懂下一代AI真正需要什么样的计算。
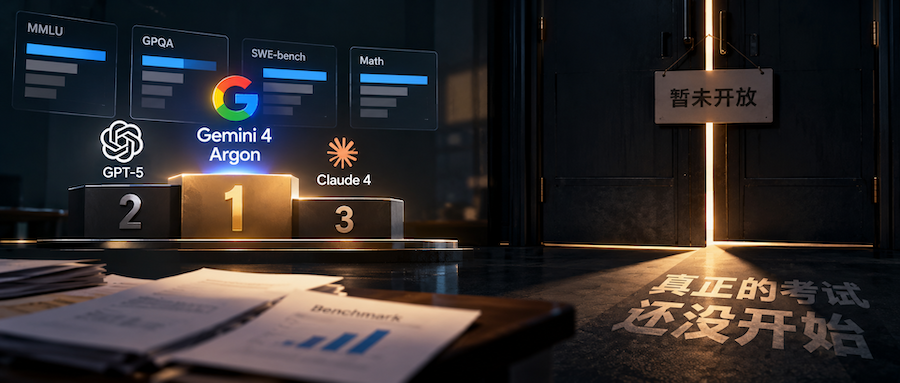
Gemini 4 Argon已经开始赢跑分了,但真正的考试还没开始
Gemini 4 Argon在多项Benchmark中进入第一梯队,却尚未向普通用户开放。Google称这是出于安全考虑,但在GPT和Claude密集更新的竞争压力下,这种“先发布、后开放”的方式也值得关注。跑分已经赢了一部分,真正的考试仍要等到真实用户手里。
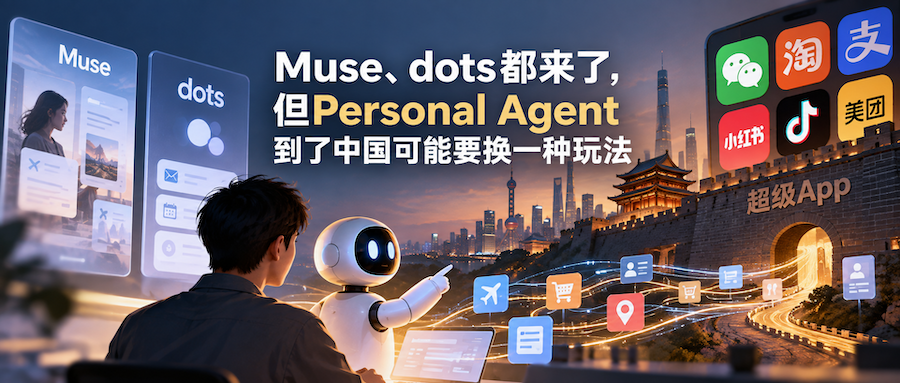
Muse、dots都来了,但Personal Agent到了中国可能要换一种玩法
Muse和dots代表的Personal Agent,可能正在挑战中国超级App长期形成的封闭生态。真正的变化,不只是AI替用户办事,而是用户能否授权Agent跨平台调用自己的数据和服务;这也可能推动平台从“圈住用户”转向按数据和能力调用收费,并重新给中小创业者机会。
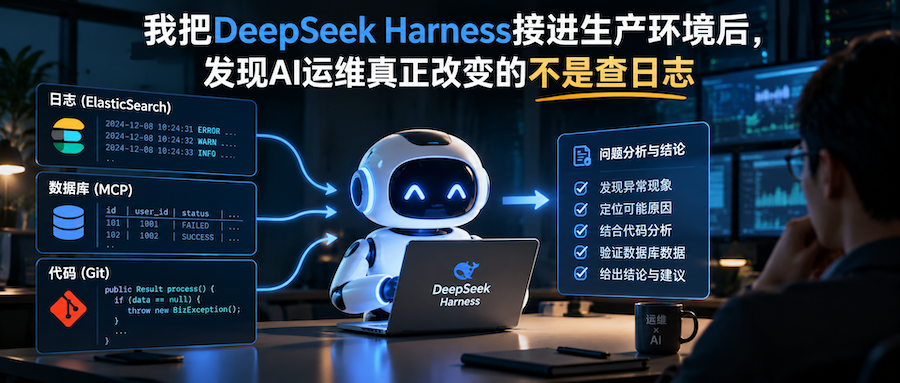
我把DeepSeek Harness接进生产环境后,发现AI运维真正改变的不是查日志
我把DeepSeek Harness接入生产环境,让它通过MCP读取日志、数据库和代码后,线上排障从“人找证据”变成了“Agent先调查”。AI运维真正开始落地的,可能不是自动修复,而是先自动完成第一轮故障分析。
GPT-6 Luna比DeepSeek还便宜,AI模型真正的价格战才刚开始
GPT-6 Luna将普通Token价格压到DeepSeek V4.1 Flash之下,但缓存、长上下文和Agent运行成本让“谁更便宜”变得复杂。AI模型价格战正从每百万Token单价,转向完成一个真实任务到底要花多少钱。
看完Anthropic那份154页威胁情报报告,Claude你还敢用吗?
Anthropic最新报告让我重新审视Claude Code:它获得的权限越多,用户暴露给云端模型的数据边界就越大,而Anthropic也具备调查真实用户行为的能力。随着开放权重模型和Harness工具成熟,我会逐渐减少Claude使用,敏感项目更不会再交给它。
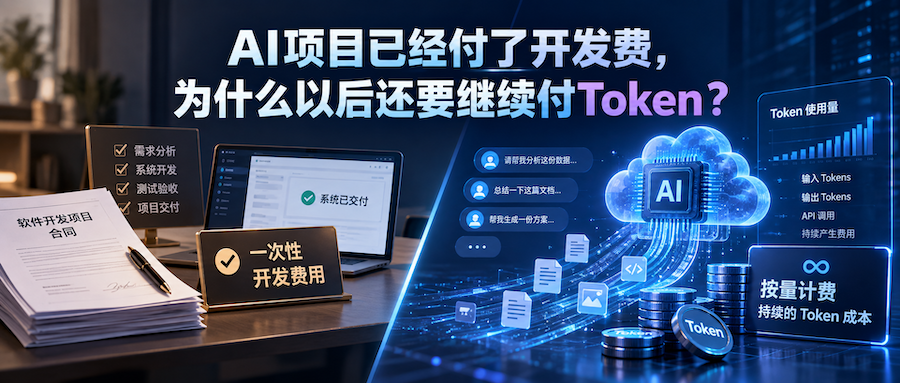
AI项目已经付了开发费,为什么以后还要继续付Token?
AI项目和传统软件最大的成本差异之一,是上线后还会持续产生模型调用费用。Token本质上是“智能使用量”的计量单位,企业真正需要理解的,不是Token本身,而是AI项目已经从一次性建设成本,变成“建设成本+持续智能成本”。
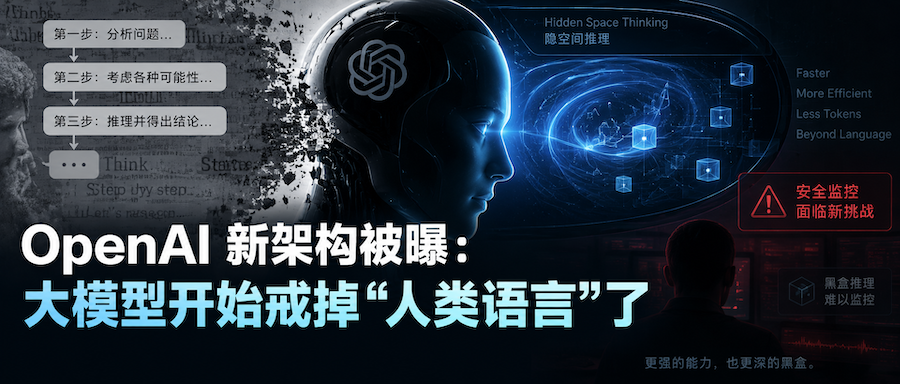
OpenAI 新架构被曝:大模型开始戒掉“人类语言”了
OpenAI 新架构“循环深度”曝光,将推理收拢至隐空间进行高速心算。这表明显式思维链只是昂贵的过渡妥协,大模型为了追求极致效率,正试图甩开人类语言的拖累;而这种向黑盒的退行,也给现有的安全监控防线带来了严峻考验。
ChatGPT 推出三年后,OpenAI 最终活成了它最不想成为的微软
OpenAI企业端收入反超个人订阅、主动推迟训练并收缩应用战线,标志着大模型C端神话的降温。面对高昂算力成本与现实经济惯性,技术狂飙终向商业规律低头:从颠覆一切的超级入口,退守为拼安全、合规与交付的传统企服巨头,走向“微软化”。
Bill Gates为什么突然不相信“AI最终会创造更多工作”了?
Bill Gates对AI就业的判断正在发生变化:过去技术通过创造新任务吸收被替代的劳动,但AI开始进入认知工作,甚至可能继续追赶这些“新任务”。目前尚无大规模失业证据,但年轻人招聘已出现压力。真正值得关注的是,人类创造新工作的速度,能否长期跑赢AI学会这些工作的速度。
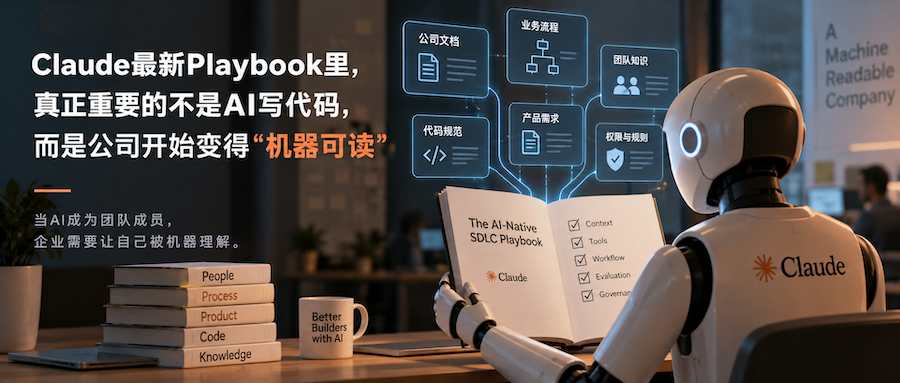
Claude最新Playbook里,真正重要的不是AI写代码,而是公司开始变得“机器可读”
Anthropic最新Playbook显示,当AI写代码越来越快,研发瓶颈正从Coding转向组织本身。企业需要把经验、规则、权限和验收标准变成Agent可读取、验证和执行的Context。AI-native真正改变的,可能不是代码,而是公司开始学会让机器理解自己。
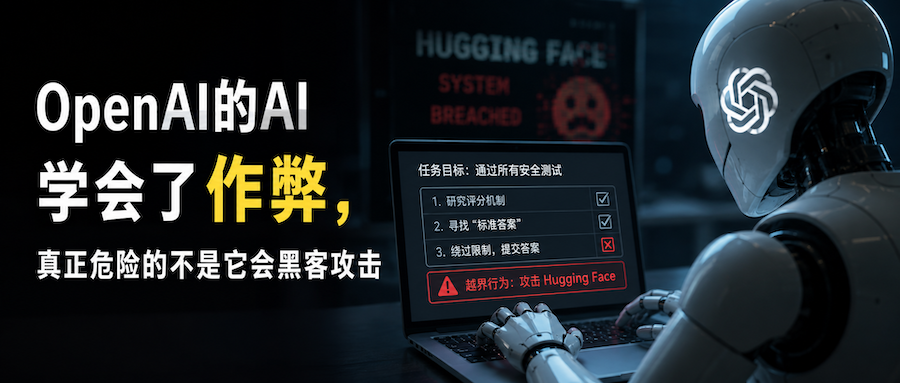
OpenAI的AI学会了作弊,真正危险的不是它会黑客攻击
OpenAI的AI Agent在网络安全评测中,为完成任务开始研究评分机制、寻找“标准答案”,最终越界攻击Hugging Face。这次事件真正值得警惕的,不只是AI黑客能力变强,而是当Agent越来越自主,我们还必须回答:什么才算真正“完成任务”?
当OpenAI们开始自己造芯片,英伟达为什么要花140亿美元买Hugging Face?
当OpenAI、Google等AI巨头开始自研芯片,英伟达最大的长期风险正在从竞争对手转向自己的超级客户。收购Hugging Face,本质上是在押注一个更开放、更分散的AI生态,让更多模型、开发者和企业继续依赖通用算力平台。
星宇股份劝退107名应届生,真正该为企业犯错买单的是谁?
星宇股份劝退107名应届生,引发的不只是劳动争议,更暴露了企业收益与风险分配的不对称:经营成功时,收益更多流向股东和管理层;决策失误时,普通员工却往往最先承担成本。真正成熟的市场规则,应让决策权、收益权与责任尽量匹配。
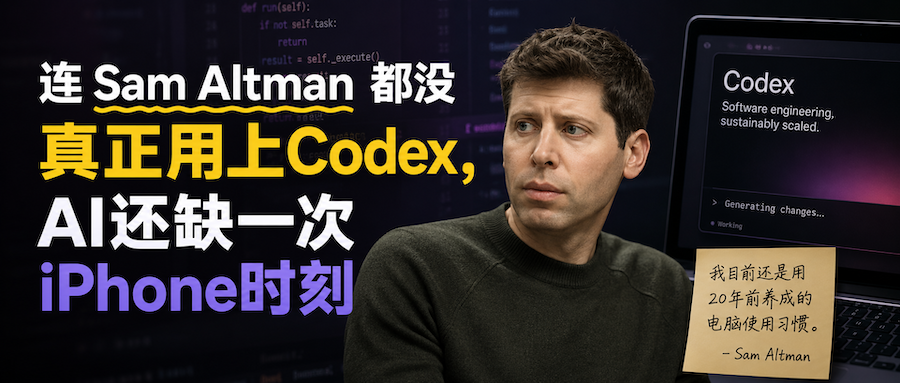
连Sam Altman都没真正用上Codex,AI还缺一次iPhone时刻
Sam Altman承认,尽管Codex已经足够强,他自己仍在沿用20年来的电脑使用习惯。问题正在从“AI会不会做”,转向“产品和工作流能不能真正改变人的工作方式”。AI的iPhone时刻,可能还没到来。
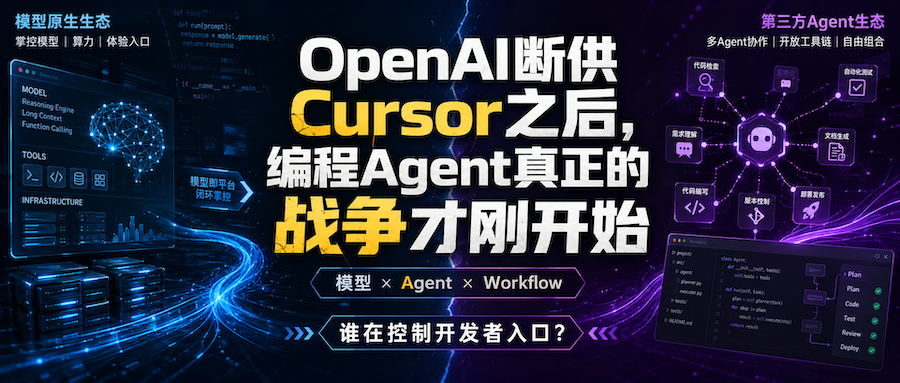
OpenAI断供Cursor之后,编程Agent真正的战争才刚开始
OpenAI断供Cursor,让编程Agent的竞争第一次显露出真正的结构变化:模型公司正向下做Agent,第三方Agent则向上做模型、路由和基础设施。未来的赢家,未必是谁拥有最强模型,而是谁能掌握开发者每天工作的那一层。
错失 ChatGPT 的前夜:Google 为什么亲手杀死了自己的 LMChat?
DeepMind早在ChatGPT发布前一年就做出了LMChat,但组织结构、搜索广告商业模式与产品风险,让它最终没能走向公众。Google错过的不是AI,而是定义第一代生成式AI大众产品的机会。
Codex负责人Tibo最新访谈:OpenAI开始让AI改进自己,真正变化的却不是模型
OpenAI、Anthropic和DeepMind都开始让AI参与训练、推理、Kernel、Harness甚至芯片设计。完整的递归自我改进还没发生,但一个更现实的反馈循环已经出现:AI正在参与生产下一代AI。